一、本期总体分析
arXiv 论文时间范围:[2026-11-20 05:00:00, 2026-11-21 05:00:00)(Asia/Singapore) 各分类篇数:astro-ph 154;cs.CV 337;cs.LG 359;cs.AI 400;stat.ML 58(含跨类,分类间可能重复) 入选篇数:2
测光目录的来源、测量口径和缺测模式随天区与天体类型变化。EuclidFM 把这些不规则输入压缩成固定长度向量,量化了 VIS 亮度、形态代理量和目录误差在向量中保留了多少。SDSS–WISE 研究把星等、颜色、尺寸、红移和类别先验逐项拆开,展示分类分数随观测条件和目标选择变化的幅度。前者提供了可用于不同测光覆盖的编码器,后者给出了判断新增表征是否真正改善部署结果的对照设计。
优先精读 EuclidFM 的第 II 节与附录 A,再用第 III 节辨别每个读出实验验证的对象,预计 35–45 分钟。SDSS–WISE 适合作为分类评估的方法储备,选读表 3、5–7、9、11 和 13,预计 30–40 分钟。需要把分数用于编制实际候选表时,可先读两篇的外部验证。
二、入选论文概览
| 优先级 | 英文标题 | 类型 | 核心贡献 | 数据与基准 | 代码状态 | 适用研究场景 | 判断 | arXiv |
|---|---|---|---|---|---|---|---|---|
| 1 | EuclidFM: Foundation Model for Compact Photometric Survey Representation | 天文交叉 | 带来源标识的掩码测光重建与 128 维目标表征 | Euclid Q1 三个深场、Platinum 三分类参考集 | 官方模型、训练和推理代码可查 | 异质测光目录表征与缺测分析 | 验证了信息保留,表征相对原始测光的下游增益仍待对照 | 2611.25080v1 |
| 2 | Feature redundancy, redshift, and class-prior effects in SDSS–WISE photometric classification | 天文交叉 | 用消融、配对重采样和先验变换解剖分类分数 | SDSS DR17、WISE All-Sky、DESI DR1 与 Legacy Surveys DR10 | 论文未给出该实验代码链接 | 星系、类星体与恒星分类及跨巡天验证 | 外域结果明确暴露失效,WISE 深度的独立贡献仍需分离 | 2611.26310v1 |
三、逐篇深度分析
EuclidFM: Foundation Model for Compact Photometric Survey Representation
作者 Reyhaneh Vojoudi Salmani、Mahsa Berahman、Saeed Ansarifard、Michael M. Fausnaugh、Seyed Mohammad Sadegh Movahed。版本 2611.25080v1,2026 年 11 月 18 日 19:21:05 UTC 首次提交。分类 astro-ph.IM、astro-ph.CO。 摘要 · HTML · PDF · 作者代码
适用研究场景是需要在光学和近红外覆盖不齐的目录中,以统一维度批量输入分类器、回归器或相似源检索的任务。推荐精读。用测量出处标记每个 token,再区分自然缺测与训练时人为遮掩,是这套方法最直接的实现贡献。
测光目录与参考标签
Euclid Q1 的 MER 目录把 VIS 的
作者从 EDF-North、EDF-South、EDF-Fornax 近均匀随机抽取 100,000 个源。要求伪源标记为零,检测质量标记允许 0、2、512,保留部分混叠源及延展源区域内的目标。质量筛选后再移除与光谱类星体 Golden Sample 重叠的 17 个 ID,得到三场分别 29,150、30,463、30,645 个源。重建训练和验证按 Euclid 对象 ID 分成 72,206 和 18,052 个。后续 VIS 的逐场留出只发生在线性读出阶段;编码器预训练使用了三场。 附录 A.1、A.4 · 附录 C.3
分类器的 Platinum 参考集走另一条构建路径。2,675 个类星体取自 Q1 光谱 Golden Sample。恒星和星系从类星体所在瓦片中的 PHZ 候选开始,要求测光和检测质量达标,再分别借助 Gaia DR3 天体测量、DES DR2 延展判据与 VHS DR4 分类信息验证。恒星用视差显著性或带协方差的自行统计量,并把 Gaia 位置传播至 Euclid Q1 时段的两个端点检查匹配。星系须同时通过 DES 与 VHS 的无歧义匹配。恒星和星系还要在 VIS、Y、J、H 中至少三个波段有有限测量和正误差,至少一带信噪比达到 5,并剔除可能混淆的近邻。最终各保留 3,500 个,因此参考标签的高纯度建立在空间覆盖、目标选择和测光质量条件之上。 第 II.3 节 · 附录 B
从不齐全的测量到对象向量
通量
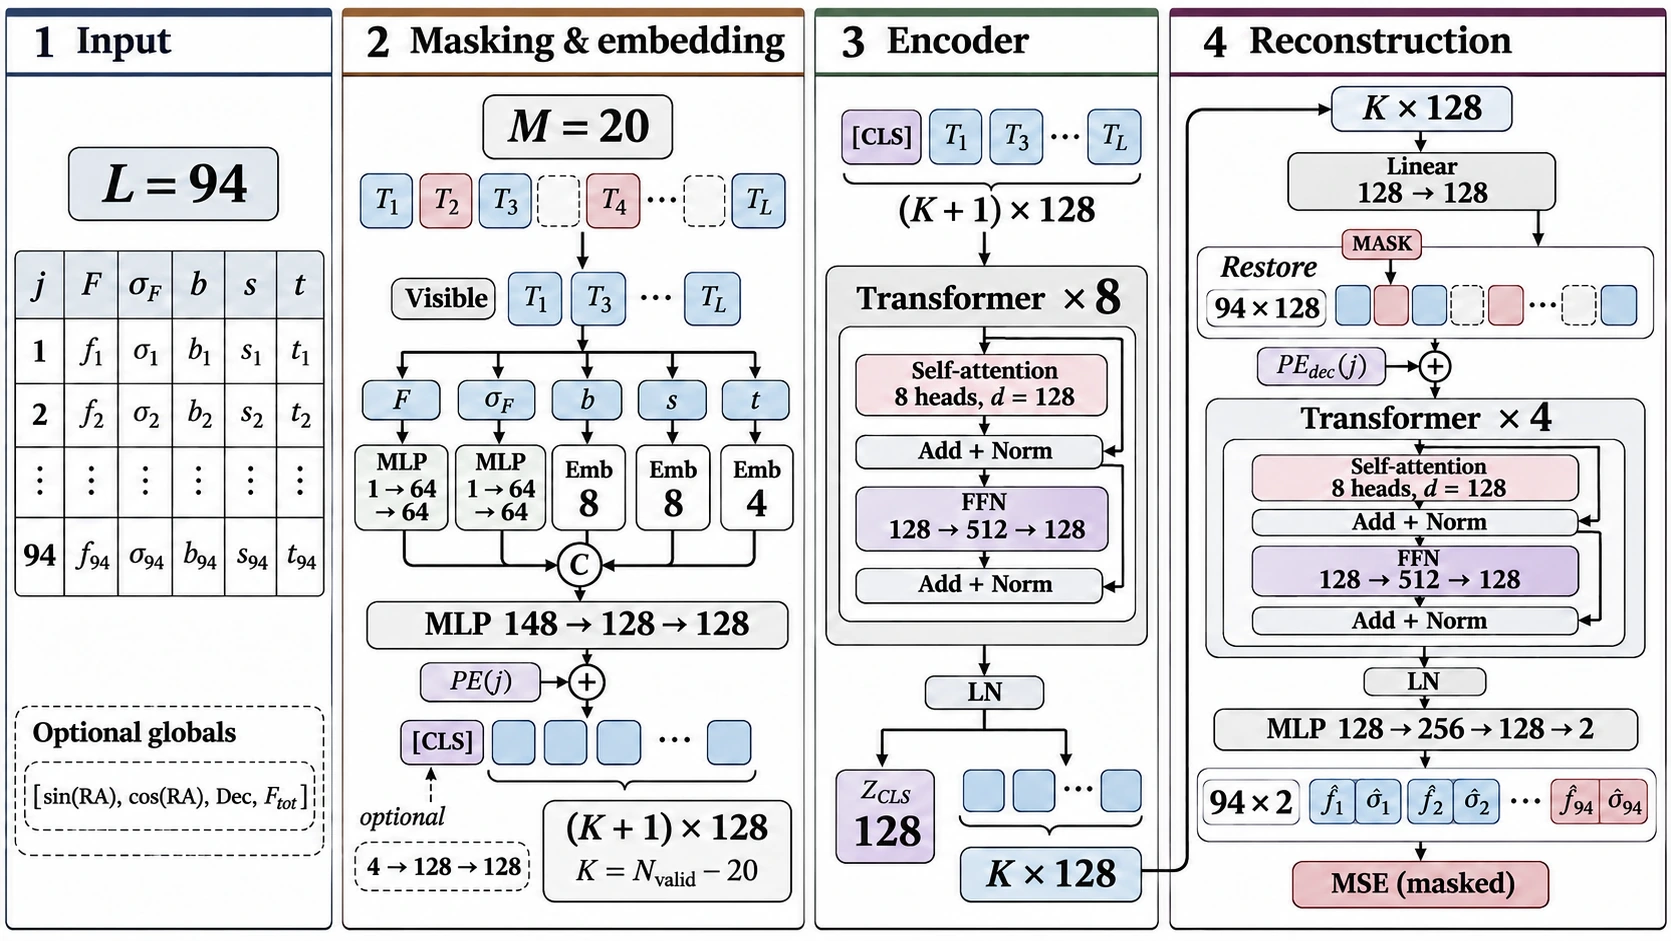
通量和误差分别经小型 MLP 投影,和巡天、波段、测量类型的嵌入拼接,再融合成 128 维 token。位置编码对应固定波长顺序中的原始通道编号,跳过缺测项后也能区分测量身份。八层 Transformer 编码器处理可见 token 与一个可训练的 [CLS] token。解码器仅取测量 token 的输出,恢复通道顺序,在人为遮掩位置填入可学习 token,经过四层 Transformer 和预测头恢复两维变换量。对每个源的遮掩集合
误差是输入特征和重建目标。这个损失给变换后的通量与误差同等的平方误差权重。[CLS] 虽不直接进入解码器,仍可通过编码器注意力与测量 token 交换信息。训练不输入天区坐标、类别或显式形态量,图中可选的全局特征分支在报告实验里关闭。编码器有 8 个注意力头、512 维前馈层、0.1 dropout。作者用 AdamW、初始学习率
嵌入保留了哪些信息
形态分析先把 128 维向量用 PCA 与 t-SNE 投影用于观察,再回到原空间计算欧氏邻域。在 66,106 个具有 VIS 星等且点源概率处于两端的源中,点源概率至少 0.8 的目标,其 15 个近邻平均有 12.4 个也在高概率组。固定天区和 0.25 星等小区间后的标签随机化给出 4.3 个。结果支持向量保留了亮度和场区之外的形态相关信息。孔径间通量差、模型拟合通量与 MER 点源概率可能共用测量来源,故这个设计验证的是目录内形态代理量的保留。大 Kron 半径源的近邻更常带混叠标记,也可以由大源相互聚集和本身更常混叠共同解释。 第 III.1 节 · 附录 C.1
在两场拟合线性头、第三场读出时,预测 VIS 星等的 Spearman 相关在 0.954–0.980。这个星等与模型的可用 VIS 测量共享观测信息,实验回答的是压缩后还能读回多少亮度信息。信噪比的近邻比较在匹配场区与亮度之前为 74.9%,匹配后为 52.3%,接近随机的 50%。误差的近邻一致性约 52.5%,而线性探针在误差不超过 1 微央斯基时能读出较强的全局关系。在该子样本中,把向量加到只用星等的样条回归上,三个留出场的对数误差 RMSE 各降低 24%–37%。纳入高误差尾部后,误差读出的 Spearman 相关由 0.556–0.712 降至 0.100–0.223。读出目标是目录报告的孔径通量误差,不能据此评价单源的测量误差是否已校准。北场与南方两场的嵌入空间分布也不同,作者提出地面巡天覆盖差异是可能原因,尚未做同覆盖对照。 第 III.2–III.4 节 · 附录 C.2–C.3
分类实验冻结编码器,用 64、32 单元的两层 ReLU MLP、交叉熵和学习率 0.001 的 Adam。Platinum 按类作 70:15:15 划分。按最大概率取类时,测试准确率 97.3%,三类中类星体的 F1 最低,为 0.951。用于工作目录的阈值在验证集上按各类精确率高于 99% 选择,类星体、恒星、星系分别为 0.83、0.96、0.95。模型提出 1,150 个类星体候选,其中 156 个获得接受的外部对应源,21 个有 QSO/AGN 证据,包括 12 个光谱类星体。另有 83 个匹配外部恒星标签、39 个星系标签、13 个未验证。外部匹配样本具有自己的观测选择,21/156 只描述该匹配子集。参考集上的阈值也没有给出工作目录总体的纯度或完备度。 第 II.4 节、表 1 · 表 2
证据强度与复现条件
对所测三场中亮度信息可读、点源邻域超出分层随机基线的结论,可信度高。对受限误差范围内的读出增益,可信度中等,前提是同一目录误差定义及与训练相近的可用通道。对高置信类星体阈值可跨样本使用,现有证据弱。跨曝光、跨深度或换巡天时,应显式检查可用通道数、质量标记和来源分布。样本与参考集的完整对象及近邻排斥只能按论文披露评估。文中未报告同等输入和标注预算下的端到端分类基线,也未给出可用于比较计算成本的统一训练时长。 讨论
作者在论文的数据可用性声明指向官方仓库。本次核对了固定提交中的 models/transformer.py、训练入口和 README。仓库还提供数据预处理、评估代码及推理笔记本。README 列出工作目录数据和第 656 轮检查点的下载入口;此次核验覆盖源码与文档,权重文件及训练结果未在本机复运行。 固定仓库提交 · 模型实现 · 数据可用性
审稿人视角:最大问题与研究启发
最大的一个问题
实验尚未分离自监督预训练的收益与原始测光本身的可分性。第 III 节的亮度和误差读出可以证明压缩后信息仍在。表 1 的冻结分类器分数可以证明精选参考样本可分。要量化掩码预训练带来的分类增益,还需比较同一组测光、误差和可用性掩码直接用于分类的结果;作者在讨论中明确把这一比较留给后续工作。这限制了“少量标签即可适配”的主张,同时保留了固定维度表征在已测试目录中的价值。最小补充是用同一 ID 分组与留出场、相同测量和训练标签预算,对比原始测光加掩码的树模型、同架构随机初始化的编码器及冻结 EuclidFM。用分场的类别精确率–召回率和随标签量变化的学习曲线量化差值。若要检验从其他波段推断 VIS 的能力,再在所有对照中一并移走 VIS 及其同源衍生量。 表 1 · 附录 C.3 · 讨论
研究启发与可执行验证
迁移分析可从模型是否依赖通道覆盖入手。第一组实验固定源及其共有的 Euclid 通道,逐组移除地面巡天通道,比较同一对象的向量漂移与分类置信度。第二组按目标选择、星等和区域构建独立光谱验证层,分别计算错误率与弃判率,再按已知抽样概率加权估计目标样本中的性能。前者需要可识别的测量来源,后者需要足够的外部标签和可靠的选择模型。阅读可沿图 2、式 A4–A6、附录 C.3、表 2 的顺序进行。 图 2 · 附录 A · 表 2
Feature redundancy, redshift, and class-prior effects in SDSS–WISE photometric classification
作者 Mohammad Sadeghi、Kayoomars Karami。版本 2611.26310v1,2026 年 11 月 19 日 15:58:58 UTC 首次提交。分类 astro-ph.GA。 摘要 · HTML · PDF
适用研究场景是用光学、红外测光区分星系、类星体与恒星,尤其需要判断特征消融的改进能否随样本选择迁移。优先选读诊断实验。有红移、无红移和光学独用三个设置回答的是不同数据可用性下的问题,需要分别报告。
两套巡天怎样构成对照
SDSS 训练与测试数据从 DR17 的 SpecObj、PhotoObj 关联而来,类别和红移来自同一光谱管线。作者要求类标为 GALAXY、QSO 或 STAR,光谱红移大于 −0.1,
按类别分层的 70:15:15 划分给出 2,556,617 个训练源、547,846 个验证源、547,847 个测试源。切分单元是目录源,论文未另设按天区分组的内部测试。特征构建不使用真实类别来筛选异常值,排名和选择在训练及验证阶段完成。测光、尺寸和光谱类标沿用对应巡天管线。文章重点处理跨系统的星等单位与列定义,未从原始曝光重新作 PSF 或背景校准。 第 2.4 节 · 第 4.1 节
跨巡天测试取 DESI DR1 光谱的 SPECTYPE 与 Legacy Surveys DR10 的匹配测光,要求 ZWARN 为零。249,839 个初始匹配源中,保留五带通量及尺寸为正的 230,235 个,含 226,967 个星系、2,421 个类星体、847 个恒星。为在两套系统中取同类输入,作者只使用共有的
同一组原始量能支持多大增益
11 个原始输入包括九个光学与红外星等、尺寸和光谱红移。派生 11 个颜色与三个形态量后有 25 个特征。颜色是星等差,但树每次只沿一维分裂,用颜色可直接切分色–色平面需要的方向。紧致度和对数半径对原半径单调,表面亮度同时用到
四种特征排名使用随机森林 Gini 不纯度下降、近邻互信息、ANOVA F 统计量、LightGBM 的平均绝对 SHAP,归一化后等权汇总。特征排名稳定性在十个种子和 30 次类内 bootstrap 下评估,尺寸代理量的单列 SHAP 排名比其他方法更易波动。随机森林在 30 万分层训练样本上按袋外宏 F1 搜索 15 组超参数,再在全训练集重训并对三个种子的概率取平均。更大的训练集对这一固定数据分布的收益趋缓:默认随机森林由 50 万源增至约 256 万源时,宏 F1 仅从 0.9827 到 0.9832。增加数据量对暗端域移的作用需单独测量。 第 3.2–3.3 节 · 第 4.2 节
| SDSS 测试配置 | 宏平均 F1 | 结果含义 |
|---|---|---|
| 含光谱红移,11 个原始特征 | 0.9830 | 已达到调优模型附近 |
| 含光谱红移,SHAP Top-12 随机森林 | 0.9834 | 该配置的类星体 F1 为 0.9608 |
| 无光谱红移,10 个原始特征 | 0.9507 | 直接测光加尺寸是有竞争力的基线 |
| 无光谱红移,原始量加光学与 WISE 颜色 | 0.9553 | 颜色组解释了主要增益 |
| 无光谱红移,24 个完整特征 | 0.9551 | 再加形态派生量的增益未显现 |
| 无光谱红移,光学独用 | 0.9234 | 可用于估计要求 WISE 的代价 |
组合特征的重要性与它们带来的边际增益是两个问题。用相同随机置换同时打乱一组尺寸代理量,含红移模型的 F1 降幅为 0.0021,超过逐列降幅加总的 0.0007。无红移模型的组置换降幅是 0.1422,显示此时模型高度依赖尺寸信号。原始半径仍足以给出大部分这类信息。无红移的完整特征把原始基线提高 0.0044,而不使用 WISE 的情景比 14 特征纯测光配置低 0.0327。对部署而言,保有独立波段的影响大于增加同源派生特征。 表 2–4 · 表 8
红移值、红移的可得性与稀有类纯度
含光谱红移时,置换量表中该列占总重要性的 80.1%。星体靠近零的红移有物理依据,SDSS 目标选择也让大部分星系落在较低红移,模型因此可能把高红移当成 QSO 代理。在
同源 photo-
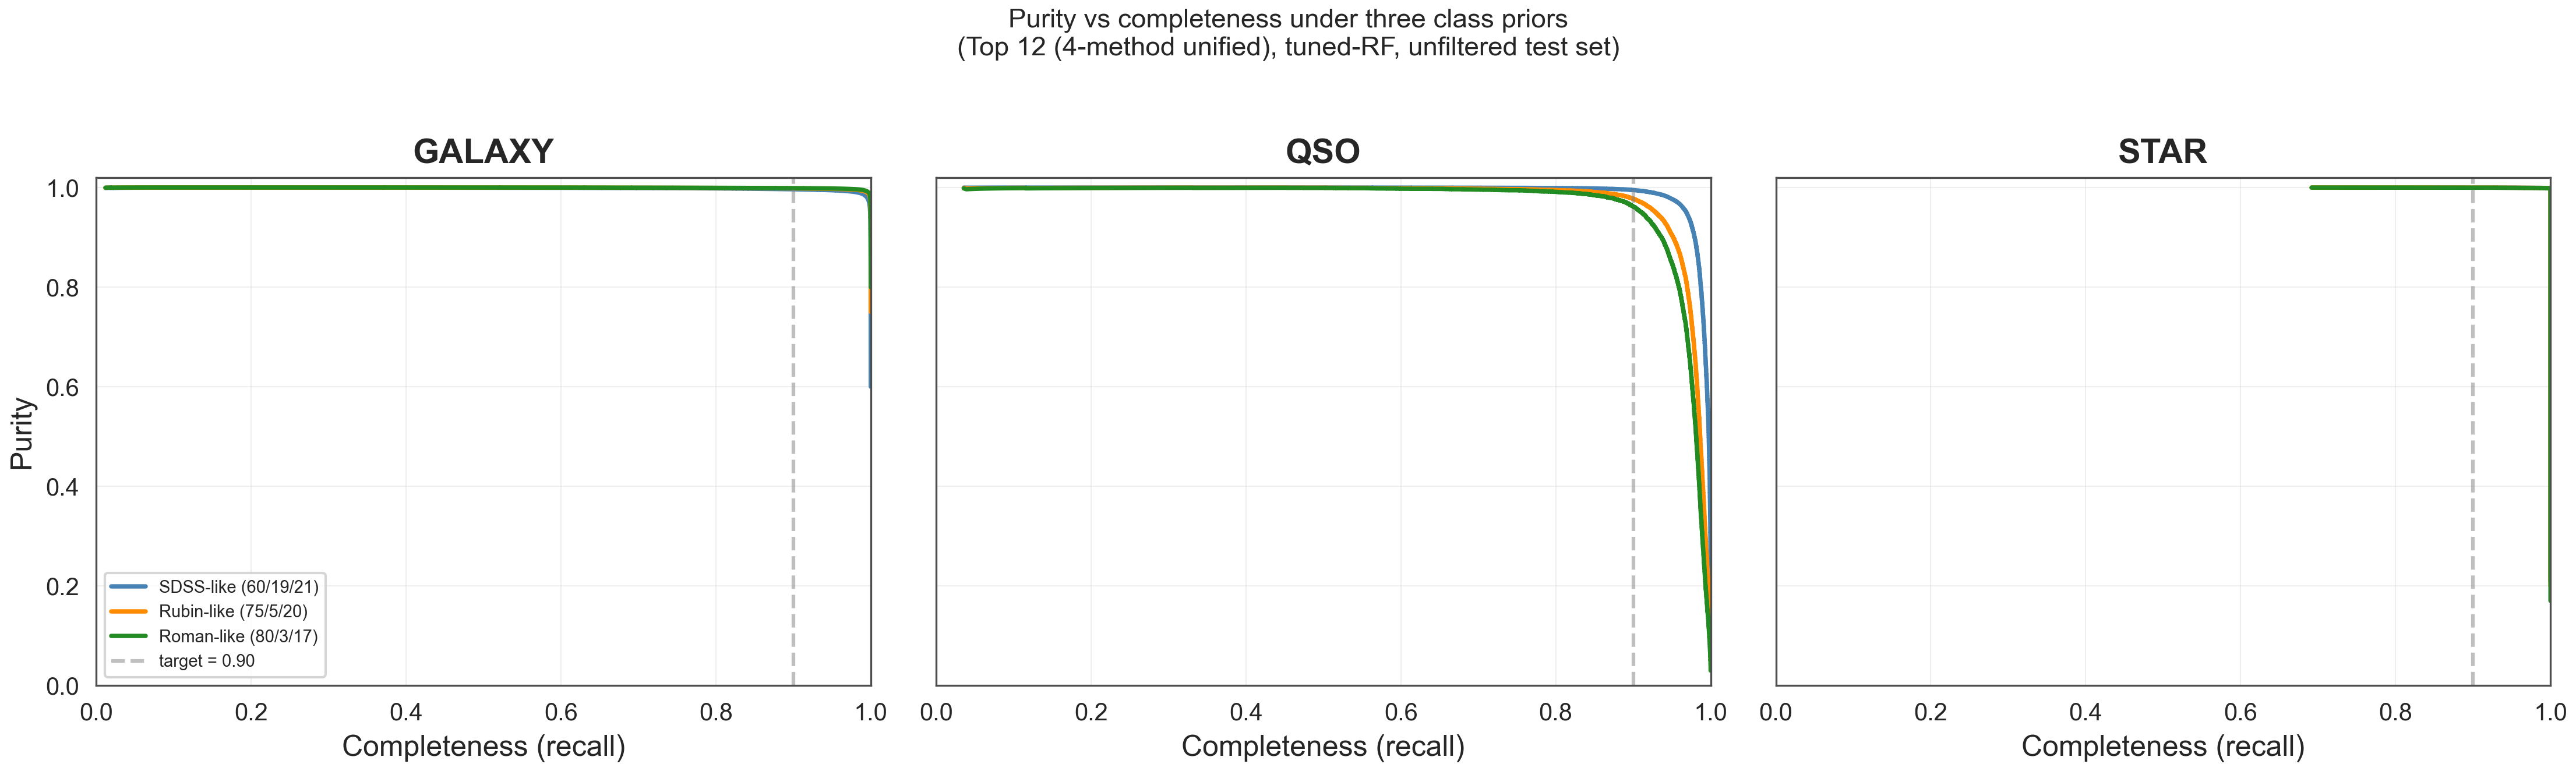
若固定每类的真阳性率、假阳性率和目标样本中该类的比例
给出。用四方法综合排名的 Top-12 随机森林,在 90% 完备度处把类星体比例从 SDSS 式先验下调到 5% 和 3%,其估计纯度由 0.995 降为 0.977 和 0.962。后两种是示例类配比。验证集保序回归把分箱 ECE 从 0.0052 降为 0.0004,固定完备度的纯度几乎不变。阈值排序与概率刻度的改进要分别测量。更换巡天若同时改变类内特征分布,同一 ROC 及单纯先验重加权的假设都需要重新检查。 第 5.3 节与表 7
从内部验证到跨巡天失效
在 SDSS 内按
作者再用 11,514 个共同对象,先固定 SDSS 标签切换两个测光系统,再固定 DESI 测光切换光谱标签,使用 2,000 次配对 bootstrap。共同样本的总体标签一致率为 99.3%,但 100 个 SDSS 类星体只有 68 个仍获 DESI QSO 标签。十特征模型切换测光时 QSO AUC 变动 −0.049,95% 区间为 [−0.093, −0.013]。切换标签的 AUC 差 −0.022,区间 [−0.070, +0.023],共同样本只有约 100 个类星体,难以比较两类效应的大小。线性重标定对 AUC 的点估计略有改善,QSO F1 却下降。这个配对实验检验同一对象上测量系统的变化,能与整个外部目录测试互相补充。 第 6.1 节与表 11
证据强度与复现条件
同一样本上检验原始特征、先验和红移的消融,结论有较高可信度。配对对象上测光系统确实变化,对十特征模型 AUC 的影响有中等可信度。对 WISE 深度在完整 DESI 域移中造成多少损失,现有证据有限。正文把 W1–W2 稳健散布的变化 0.038 至 0.087 mag 与 Spearman 相关从 0.86 降至 0.50 描述为同一段范围,表 13 显示 0.038 mag 属于最亮的
审稿人视角:最大问题与研究启发
最大的一个问题
WISE 深度筛选改变了被评估的对象,尚不能把迁移损失中最大的独立份额归给 WISE 测光。在与 SDSS 不重合的 218,721 个 DESI 源中,仅保留 W1 ≤ 17.6、W2 ≤ 17.0 的源,类星体 F1 从 0.104 升至 0.288,假阳性率由 0.092 降至 0.024。同一操作改变了光学亮度、红移及类别组成。表 13 量化了共同对象上的颜色一致性随星等下降,表 11 量化整套测光系统的切换,两者都无法单独隔离深度。作者在第 6.2 和 7.2 节承认共变。它限制的主要是原因排序和部署改造优先级,DESI 上的性能下降本身有直接数据支持。最小验证应固定同一目标集合及光谱标签,按光学星等、红移及类别分层,对同一源的两套测光仅替换 W1/W2,再做配对重采样并报告 QSO AUC 和固定完备度下的纯度。若两套测量只在亮端重叠,可向同一组亮源的强制测光加入暗端估得的噪声并重新计算颜色,同时保留原有光谱标签、光学测量与对象权重。这样的注入实验检验噪声机制,对真实暗端类群的外推仍须用观测样本验证。 第 6.1–6.2 节 · 第 7.2 节
研究启发与可执行验证
迁移分析应区分特征值、缺测指示和样本入选概率。第一步用同一对象群作原始测光、颜色、单独的可用性掩码三个消融,量化只看缺测模式能得到多少类别信息。再以独立深场或独立巡天做外域验证,报告每类的工作点、未探测率和统计区间。按目标类型与亮度配平有助于比较测量系统,代价是缩小覆盖范围并可能减少稀有类样本,需要把全样本性能另行列出。阅读顺序可从表 3、5、7 到表 9、11、13。 诊断实验 · 外部验证
四、跨论文结论与行动建议
- 精读 EuclidFM 的输入与可用性掩码,复现对象向量的构建。用 SDSS–WISE 的特征对照约束下游实验,在同样标注量和同样可用测量下比较原始目录模型与冻结嵌入。
- 把读出信息与预测未知测量定义为两个实验。前者允许向量见到目标带,后者从编码输入排除该波段和同源衍生量,再以场区留出评估。
- 在选择稀有天体的操作阈值前,用独立光谱样本检验与目标目录相符的先验和深度。分别报告覆盖率、纯度、完备度,并保留按亮度和红移的分箱结果。
- 这两项研究的证据分别支持限定目录中的信息保留,以及既有分类器外推时会失效。表征是否节省标签、哪个单独测光因素主导迁移损失,仍待上述配对对照。
本报告由 GPT 6.2Sol XHigh 整理分析,博客作者对分析内容不负责且不代表博客作者本人的想法。