一、本期总体分析
arXiv 论文时间范围:[2026-11-19 05:00:00, 2026-11-20 05:00:00)(Asia/Singapore) 各分类篇数:astro-ph 149;cs.CV 340;cs.LG 370;cs.AI 362;stat.ML 58(含跨类,分类间可能重复) 入选篇数:2
低分辨率观测里的科学信息能否用于下游分析,取决于测量对象和验证方式。恒星光谱论文固定各巡天的编码器,比较两个跨巡天目标函数,检验温度、表面重力与化学丰度在 Gaia XP 表征中能否被简单读出。STAR++ 把 HST 图像降采样,要求模型同时恢复星像和源通量。前者的关键对照是同输入、同编码器和同探针下的目标函数差异,后者的关键对照是同一批未见滤光片图像上的重建与测光误差。
优先读光谱论文的图 2、表 2 和附录 B,约 25–35 分钟。它把“丰度能否预测”“少量标签能否线性预测”和“丰度是否集中在几个主成分”拆成了可检验的问题。图像论文适合作为构造天文重建基准的方法储备,推荐用约 20–30 分钟读第 III 节、表 III–V 和图 7。它在按天区隔离的模拟退化图像上提供了可比较的结果,实际仪器之间的低分辨率观测仍需独立验证。
二、入选论文概览
| 优先级 | 论文 | 类型 | 核心贡献 | 数据或基准 | 代码状态 | 适用研究场景 | 一句话判断 |
|---|---|---|---|---|---|---|---|
| 1 | JEPA for astronomy: multi-survey spectral alignment puts stellar parameters on the leading principal axes | 天文交叉 | 对齐同星的多巡天谱,以分布正则维持表征方差,比较线性探针和主成分 | Gaia XP DR3、LAMOST LRS DR11、DESI DR1、APOGEE DR17 | 上游 SpecCLIP 可查,本论文代码与权重待作者发布 | 跨巡天光谱预训练、少标签恒星参数估计 | 铁丰度轴最有说服力,跨选择函数的可读性仍待检验 |
| 2 | STAR++: A Physical-Aware Benchmark and Framework for Astronomical Super-Resolution across Multiple Filters | 天文交叉 | 用天球面积重叠保持降采样通量,并以滤光片条件和亚像素偏移损失训练重建器 | HST ACS/WFC、WFC3/UVIS,36 个滤光片,7 个留出滤光片 | v1 正文与 PDF 未给出实现或处理后基准下载入口 | 星场超分辨、测光误差评估、未见滤光片测试 | 合成退化上的测光与图像指标均有提升,真实低分辨率输入待测 |
三、逐篇深度分析
JEPA for astronomy: multi-survey spectral alignment puts stellar parameters on the leading principal axes
基本信息 Xiaosheng Zhao、Rosemary F. G. Wyse、Yuan-Sen Ting、Alexander S. Szalay。arXiv:2611.23492v1,主类 astro-ph.GA,交叉分类 astro-ph.IM、astro-ph.SR、cs.LG。v1 提交于 2026-11-17 20:44:12 UTC。 摘要与版本历史 · HTML 全文 · PDF
适用研究场景 用大规模低分辨率光谱估计有效温度、表面重力和化学丰度时,少量高质量参考标签通常只覆盖特定巡天的目标。若预训练后的 Gaia XP 表征能让带正则的线性模型读出这些参数,就可以减少下游对标签量和非线性回归器的依赖。本文值得精读的证据是,同一表征分别用主成分、岭回归和小型 MLP 检查,能区分信息的位置与信息的可预测程度。
同一颗星提供了对齐信号
同一颗星在多个仪器上产生的观测共享温度、表面重力和组成,波段、分辨率、线扩展函数、定标误差和背景残差各有差异。普通自编码器需要重建输入像素,其高方差方向可以同时承载恒星信号和仪器结构。跨巡天训练借用交叉匹配关系,要求同星的两种表示接近。作者进一步问,用不同恒星做对比负例会如何影响化学相近的恒星在嵌入中的邻域。作者的动机是,太阳孪生星等物理性质相近的对象仍会被 InfoNCE 当作负例推远,而目标函数可以用总体分布约束来避免表示坍缩。 引言和第 II.1 节
样本与输入 两巡天配置使用 Gaia XP DR3 与 LAMOST LRS DR11,交叉匹配 820,568 对。四巡天增加 DESI DR1 和 APOGEE DR17,训练覆盖全部六种两两配对。新增配对从 16,732 对 APOGEE–DESI 到 454,355 对 XP–APOGEE,同一颗星可能出现在多条边上。参考标签集有 113,218 颗星,探针训练用 101,891 颗,留出 11,327 颗。化学参考主要来自 APOGEE,低金属丰度的铁丰度补充自文献汇编。样本受亮度、颜色及交叉观测选择影响。论文未逐项列出所有交叉匹配质量阈值、参考样本的天区分布,以及参考留出对象和上游编码器预训练对象的交集。 第 III 节和表 1
Gaia XP 范围约 0.336–1.021 微米,输入为 343 个采样通量值,各自除以该谱在 550 nm 的通量。LAMOST 与 DESI 使用约 0.40–0.56 微米的蓝端窗口,输入做连续谱归一化,DESI 还插值到 LAMOST 波长网格。APOGEE 的近红外 H 波段约为 1.5–1.7 微米,与 XP 无直接波段重合。APOGEE 编码器用连续波长 Fourier 嵌入,读入像素通量误差,并用分辨率
在投影空间对齐,在投影之前读参数
每个巡天使用各自冻结的预训练编码器。XP 的过完备自编码器产生一个 768 维向量,由可训练 MLP 映射到共用的 768 维表征空间。LAMOST 和 DESI 的掩码 Transformer 产生序列,APOGEE 的波长感知自编码器也产生序列,这三个分支各用单个学习查询的交叉注意力将序列池化为 768 维。接下来,训练专用的共享投影器把表征
序列的形成保留了不同仪器的采样结构。LAMOST 的 1,462 像素输入输出 146 个宽度为 768 的 token。APOGEE 的 8,575 像素按 32 像素成块,得到 267 个 token,最后 31 像素舍弃。其编码器为 8 层、宽度 384 的 Transformer。同一套池化接口允许模型比较匹配视图,同时维持各自的前端。作者在 XP 自编码器上另做瓶颈宽度实验。标签数为 10,000 时,将宽表征压到 24、12、6 维,[α/Fe] 非线性探针的
目标函数有两项。第一项在抽到的同星观测对上计算每坐标的平方差,使匹配视图靠近。只优化这一项会产生一个常量解,所有恒星都映射到同一个点。第二项 RDMReg 逐巡天匹配整个批次的投影分布。先从零均值、单位方差的 Laplace 分布独立采样各坐标,将负值截为零,再沿随机单位方向投影目标样本与模型样本。每个方向上分别排序两个一维样本集,比较对应秩的位置,得到平方的分布差。它要求投影保持宽度与形状,同时让一部分坐标可以为零。该约束给常量表示留下损失,且无需指定异星负例。可把公式 B1 与 B2 看作分别回答同星放多近和总体仍要保留多少变化。 第 II.2 节 · 公式 B1–B2
四巡天 JEPA 每步从每条边抽 128 对,训练轮按最大的 XP–LRS 配对集定义,较小的配对集会重用样本。XP–DESI 和 XP–APOGEE 的边权为 2,其余为 1。每个巡天每步经 8,192 个随机方向估算分布差,分布项与匹配项的权重比为 5。作者使用 AdamW、初始学习率
表征中有信息,以及信息落在哪里
探针输入的标准化统计量只用训练划分计算。岭回归正则在已标注训练集内选择,三层线性变换的小型 MLP 训练 200 轮。表 2 在同一批留出星上给出经
| 目标 | 标签数 | 四巡天 JEPA | 四巡天 CLIP | 两巡天 JEPA | 两巡天 CLIP | 无对齐 AE |
|---|---|---|---|---|---|---|
| 铁丰度 [Fe/H] | 200 | 0.90 | 0.87 | 0.86 | 0.82 | 0.69 |
| 铁丰度 [Fe/H] | 10,000 | 0.95 | 0.94 | 0.93 | 0.92 | 0.87 |
| α 元素丰度 [α/Fe] | 200 | 0.61 | 0.60 | 0.55 | 0.53 | 0.31 |
| α 元素丰度 [α/Fe] | 10,000 | 0.79 | 0.75 | 0.74 | 0.71 | 0.58 |
最清楚的结果是交叉对齐改善了低标签丰度读出。以 200 个标签为例,四巡天 JEPA 相对无对齐 AE 的岭回归
主成分分析给出了比全量探针更有区分度的结果。图 2 在同样 40,000 颗星上比较三个嵌入,JEPA 的 PC1–PC2 平面接近用有效温度和表面重力构成的 Kiel 图。四巡天 JEPA 用 PC3 单独回归铁丰度时
[α/Fe] 的几何更复杂。图 3 中,薄盘、厚盘和吸积星候选沿巨星弧分布,不同群体的 α 丰度形成交错的带。用前两个主成分做薄盘与厚盘分类,近邻分类器的 AUC 为 0.83,线性逻辑回归为 0.55。全训练标签下,[α/Fe] 的岭回归
这些族群用参考化学量划分。吸积星候选使用 [Al/Fe] 和 [Mg/Mn] 的判据,极贫金属组要求 [Fe/H] 低于 −2 且有有效的 [α/Fe]。重叠的判据按优先级分配,每颗星最多取一类。薄盘和厚盘分别有 46,627 和 19,340 颗,吸积候选 9,292 颗,极贫金属组只有 143 颗,低 α 贫金属组 5,470 颗,约 29% 的标注样本落在这些类别之外。PC3 在极贫金属区趋于饱和,论文给出的少数族群位置宜用于看分布趋势。要评估罕见对象的识别能力,还需查看给定纯度下的召回率和测量误差。 第 III 节 · 图 3
巡天规模的结果与复现条件
图 4 展示从 3,450 万条公开 Gaia XP 光谱推断后筛出的 800 万颗红巨星。样本要求有效温度低于 5,300 K、表面重力
对参考样本上的铁丰度与重力读出,证据可信度较高。架构固定、留出一致,主成分和探针结果相互支持。RDMReg 在附录 A 的 SIGReg 和 VICReg 变体中表现最好,论文只给出定性比较,尚不足以确定其优势来自稀疏目标的哪一项性质。四巡天两种目标都用标签探针分数选检查点,两巡天则用无标签验证损失。这个差异尤其影响四巡天与两巡天的直接归因。作者说明四巡天 JEPA 的无标签损失受投影尺度增长影响,不能直接作为检查点排序。正文的数据可用性声明列出公开观测档案。关联的 SpecCLIP 仓库可查到 XP 过完备 AE 和 LAMOST 掩码编码器的配置及权重链接。本文完整训练代码、四巡天权重和巡天规模推断变体仍待作者发布。 附录 A–B · 数据和代码声明 · SpecCLIP README(固定提交)
建议精读第 II.2–II.3 节、表 2、图 2–4 和附录 B。原图链接提供坐标和色标,尤其应把图 2 的独立 PCA 与图 4 的不同推断检查点一起读。
审稿人视角:最大问题与研究启发
最大的一个问题
低分辨率光谱的化学方向,尚缺少跨选择函数的独立标签验证。表 1 所列参考星依赖交叉匹配,参考丰度主要来自 APOGEE。第 VI 节明确承认亮度和颜色选择会改变群体比例,消光还可作为多巡天共享信号保留。图 4 的大样本展示说明预测后能重现群体形态,但分布形态的相似无法量化在高消光、低信噪比或稀少金属丰度尾部的逐星偏差。这是对“表征可作为通用物理坐标”外推影响最大的一点。相同参考样本中目标函数之间的差距仍有实证支持。最直接的补充是按天区留出一组具备独立高分辨率标签的恒星,从对齐和探针拟合中整组排除,再在固定探针下按消光和金属丰度分层报告未裁剪残差、偏差和尾部误差。 表 1 · 第 VI 节
研究启发与可执行验证
跨仪器预训练应同时报告线性读出、非线性读出和前几个主成分的读出。把三种结果画在同一标签预算下,可区分变量信息丢失、信息分散和线性读出缺样本。最小实验可固定自编码器和同天体匹配样本,对照带负例的目标与无负例的分布约束,并保留按对象隔离的划分。还可在匹配温度和重力的子样本上检查铁丰度残差与消光的关系。迁移到其他波段之前,需要先确认匹配对中的共享信号确实与下游科学量相关,并保留足够的独立参考标签估计域外误差。
STAR++: A Physical-Aware Benchmark and Framework for Astronomical Super-Resolution across Multiple Filters
基本信息 Guohang Zhuang、Jiaze Li、Kuo-cheng Wu、Hao Du、Jinyang Huang、Xiang Zhang、Wanli Ouyang、Yan Lu。arXiv:2611.24023v1,分类 cs.CV。v1 提交于 2026-11-18 08:13:00 UTC。任务是 HST 星场超分辨与天体测光保真。 摘要与版本历史 · HTML 全文 · PDF
适用研究场景 拥挤星场中的邻近点源可能只占少数低分辨率像素。常规像素重建的平均解会压低峰值,恢复结果即使看起来锐利,测光和质心仍可能偏移。STAR++ 值得精读的部分是把图像相似度、源级通量误差和亚像素偏移放到同一验证流程中,并显式留出滤光片和天区。其主要证据来自受控退化的重建对照。 引言 · 第 III 节
从 HST 科学图像构造测光一致的训练对
高分辨率参考来自 2,019 张 HST 科学图像,其中 ACS/WFC 913 张、WFC3/UVIS 1,106 张。36 个滤光片的枢轴波长为 222.4–906.0 nm,相对带宽涵盖 0.004–0.352。赤经范围约为 0.07°–359.94°、赤纬约为 −89.13°–87.41°,这些是档案图像的坐标范围。表 II 按滤光片列出了图像和切块数量,不能从坐标极值推断连续覆盖面积。共有 1,697,816 对 LR–HR 切块,训练 922,586 对、验证 162,593 对,使用同一组 29 个滤光片。7 个测试滤光片里,处于训练波长范围内的 F435W、F555W、F606W、F625W 有 523,137 对,范围外的 F218W、F225W、F850LP 有 89,500 对。各滤光片的样本量差别很大,例如 F606W 有 351,326 对,F218W 有 3,500 对。总体指标不能替代各滤光片的稳定性检查。 表 II · 第 III-A 节
低分辨率图像从同一张高分辨率图像前向生成。第 III-B 节以等概率选 Gaussian 或 Airy 核模拟模糊,第 V-A 节给出的 Gaussian 标准差为 0.8–1.2 像素,Airy 半径为 1.9–2.2 像素,其参数依据 HST ACS/WFC F814W 的模糊宽度设置。随后高、低分辨率网格经世界坐标系投到天球,低分辨像素接收每个重叠高分辨像素的通量份额。令
对内部完整覆盖的高分辨像素,各个重叠面积之和等于其面积,这使分配到低分辨网格的通量加总后保持一致。应用到以单位面积亮度存储的图像,应先确认像素值的物理含义及重投影归一化。切块时剔除经 DrizzlePac 几何校准产生大量 NaN 的区域,保留有效部分超过 80% 且含恒星特征的切块。作者按天区划分,并报告检查了集合间的天区覆盖和原始曝光去重。文中未逐项列出不同滤光片的天空背景分布、额外噪声谱、坏像素传播及逐曝光完整处理配方。 原图 2 和第 III-C 节 · 第 III-D 节
重建器如何使用通量、滤光片与位置信息
网络处理单张带滤光片元数据的低分辨图像。输入先通过
FAA 把归一化的滤光片波长、带宽与轴比相关元数据映射为滤光片 token。各尺度的图像特征作为查询,滤光片 token 提供键和值,经交叉注意力和残差融合进入解码器。图 3 把三次融合画在输入网格的八分之一、四分之一与二分之一线性分辨率,通道宽度依次为基宽的 8、4、2 倍。跳跃连接将对应尺度的编码器特征按通道拼接,最后上采样使用 PixelShuffle。连续元数据使训练中未出现的滤光片也能得到定义明确的输入。枢轴波长相同的两种滤光片仍可能具有不同的透过率曲线,仪器之间的像差和 PSF 空间变化也未被这几个标量完整描述。 第 IV-E 节
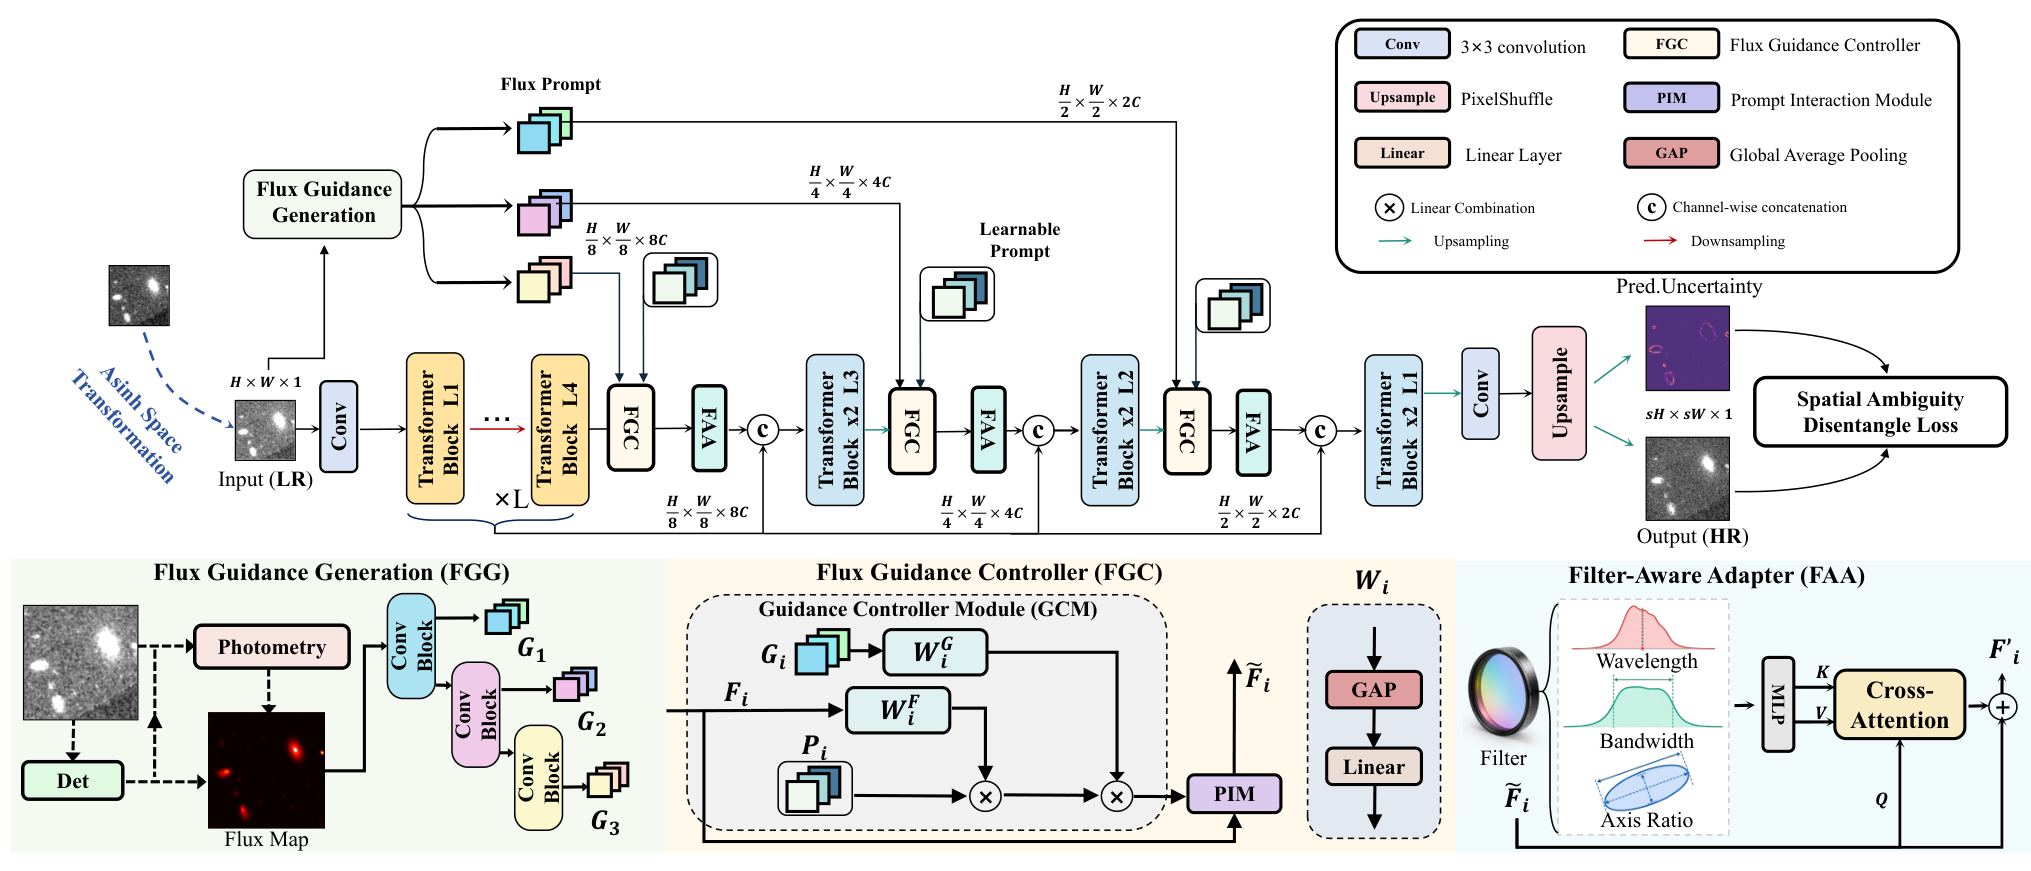
SADL 在训练时一起拟合逐像素误差尺度
损失按
测光误差要结合检测协议阅读
FE 使用 Starfinder 在参考 HR 图上定位源,再做椭圆测光。在重建图上复用同一目录和测光定义,取逐源绝对通量差的均值。所测的量相当于对参考目录做强制测光,能发现同一源口径内的能量偏差。它也会受质心偏移影响,因为部分能量可能移出固定口径。重建产生新假源、遗失目录外的弱源或改变背景时,应再做独立检测。FE 是绝对差,0.4341 是作者所用通量尺度下的差值,不能当成 43.41% 的通量偏差。若要判断颜色是否被系统改变,还要对同一源按滤光片分别看有符号残差,检查跨滤光片的误差协方差。 第 III-E 节
论文将 Bicubic、CNN 类 EDSR、RCAN、Transformer 类 SwinIR、HAT 以及天文重建 FISR 放在相同 STAR++ 留出滤光片上测评。学习方法按文中配置训练 24 轮,批大小 16,使用 8 张 Ascend 910B2 NPU。初始学习率为
| 倍率 | 方法 | 插值滤光片 PSNR(dB) | 外推滤光片 PSNR(dB) | 总体 PSNR(dB) | SSIM | FE |
|---|---|---|---|---|---|---|
| 2 倍 | HAT | 37.93 | 31.28 | 35.08 | 0.8585 | 0.5617 |
| 2 倍 | FISR | 37.22 | 30.46 | 34.32 | 0.8542 | 0.5304 |
| 2 倍 | FISR++ | 38.05 | 31.91 | 35.42 | 0.8623 | 0.4341 |
| 4 倍 | HAT | 34.44 | 27.76 | 31.58 | 0.7773 | 0.7494 |
| 4 倍 | FISR | 34.09 | 28.10 | 31.52 | 0.7736 | 0.7257 |
| 4 倍 | FISR++ | 35.35 | 29.01 | 32.63 | 0.7805 | 0.6803 |
2 倍任务中,FISR++ 比同训 FISR 的总体 PSNR 增加 1.10 dB,FE 绝对降低 0.0963,约为 18.2% 的相对降幅。4 倍任务中总体 PSNR 的增益为 1.11 dB,FE 降幅约 6.3%。PSNR 提升在插值和外推组都出现,外推组整体仍更难。HAT 从单滤光片 STAR 改用 STAR++ 后,2 倍 PSNR 也从 31.55 升到 35.08 dB。对这个数据集对照,滤光片数量和样本量一起增长,贡献不能从这一组结果中单独拆出。对应地,把 FISR++ 与同训 HAT 相比,2 倍任务在插值组只高 0.12 dB,在外推组高 0.63 dB。这组结果更适合配合源级指标阅读,避免只拿总体 PSNR 决定流程。 表 III–IV
表 V 的消融从同一 STAR++ 上的 FISR 基线开始。单加 FAA,FE 从 0.5304 降到 0.5207。只加不确定性损失降到 0.4714,再引入偏移建模与正则降到 0.4549。完整加入 FAA 与 SADL 后为 0.4536,最后加入 asinh 到 0.4341。该顺序表明,收益主要出现在不确定性加权与空间建模的对照中。表 VI 中偏移先验的标准差从 0.10 到 0.20 时总体 PSNR 接近,放宽到 0.50 时降至 34.94 dB,较最佳值低 0.48 dB。表 VII 的 FCL 对照还显示,在 STAR++ 的 4 倍 FISR++ 中,FE 从 0.6811 到 0.6803,单项增益很小。 表 V–VII
证据边界和阅读路线
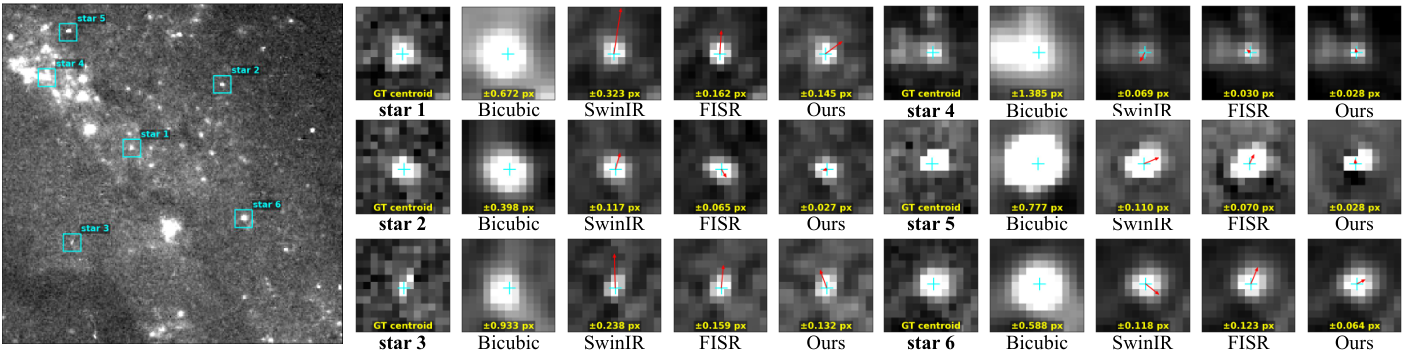
对给定退化模型、按天区留出和未见滤光片设置下的指标改进,证据可信度较高。对真实低分辨数据的测光准确度,现有证据有限。图 7 的六个选定源中,FISR++ 的质心偏移均低于 FISR。例如第 2 颗从 0.065 降到 0.027 像素。论文未报告测试集全体源在拥挤度、信噪比或亮度分层下的质心偏差分布。样本覆盖的实际噪声模型、不同仪器的跨域测试和从重建图抽取新源的误报率也需要额外验证。v1 HTML 与 PDF 未给出本版模型代码、权重或处理后图像对的下载入口,复现切片划分和微小位移实现仍有成本。建议先读表 II、公式 3–6 和图 3,再用表 III–V 区分训练数据收益、模型收益和消融收益。 第 V-D 节 · PDF
审稿人视角:最大问题与研究启发
最大的一个问题
留出滤光片检验仍发生在同一套合成退化族内,无法直接验证真实低分辨率观测的通量保真。第 III 节的输入由同张 HST 科学图像经 Gaussian 或 Airy 核模糊和天球积分生成,第 V-A 节的核尺度依据 F814W 设定。这一设计明确收住了几何重投影和光强积分变量,也使训练与测试共享形成机制。结论把证据放在 STAR++ 基准上,正文用两种核尝试覆盖模糊变化,仍缺真实输入的交叉仪器测试。最小而有判别力的补充,是同一或近似通带、曝光与天区独立的一组真实低分辨率—高分辨率观测,用已知星源测量前后通量和质心偏差,并在相同匹配规则下记录漏检及假源率。此检验直接关系到模型能否进入测光生产流程,当前基准内部的性能排序依然成立。 第 III-B 节 · 第 V-A 节
研究启发与可执行验证
先把数据生成端的通量守恒和重建端的测光准确度分别测出来。可将人工源注入真实背景,改变信噪比、邻源距离和 PSF 位置,分别比较双三次插值、经典 PSF 反卷积和学习模型。用同一参考目录做强制测光,再在各重建图上盲检一次,统计每个亮度分箱的通量偏差和假源率。迁移时需要一致的通量单位、可追溯的像素掩膜与配准。滤光片条件提供了先验,独立验证仍需覆盖目标仪器的实际点扩散函数与噪声。
四、跨论文结论与行动建议
- 优先精读 JEPA 光谱论文。 它的同架构对照适合直接移植为表征研究的实验设计。先比较完整表征的线性和非线性读出,再检查前三、前十、前三十个主成分,尤其核对铁丰度轴和 α 丰度尾部的差异。
- STAR++ 适合作为数据与指标设计储备。 可先复用面积加权生成低分辨率参考对和基于真值源目录的强制测光。在合成数据能复现同分布排序之后,再用真实多仪器配对图像检查通量、质心和假源。
- 两文都应报告比总体分数更贴近科学使用的子样本诊断。光谱侧可在独立恒星样本上按消光、信噪比和金属丰度分层。图像侧可按亮度、拥挤度和滤光片独立统计。光谱论文当前支持在已覆盖样本内读取恒星参数,STAR++ 当前支持在设定退化族内改善图像和测光指标。把线性探针直接当作全巡天无偏丰度,或把更锐利的星像直接用于科学目录,都需要相应的外部对照。
本报告由 GPT 6.2Sol XHigh 整理分析,博客作者对分析内容不负责且不代表博客作者本人的想法。