一、本期总体分析
arXiv 论文时间范围:[2026-11-18 05:00:00, 2026-11-19 05:00:00)(Asia/Singapore) 各分类篇数:astro-ph 163;cs.CV 322;cs.LG 358;cs.AI 401;stat.ML 42(含跨类,分类间可能重复) 入选篇数:2
两篇论文都把仪器如何产生数据写进了学习过程。Spectro-Spatial Survey Fusion 为每种观测定义独立的前向算子,把单次曝光和光纤光谱约束到同一片天空。SARVIA 用原生雷达功率和配准坐标计算自监督答案,把这些约束转成可复用的视觉特征。前者得到一个可通过不同仪器查询的天区模型,后者得到一个可接入检测和分割头的编码器。
优先精读 Spectro-Spatial Survey Fusion,预计 40–50 分钟。它用同一批影像和相同优化预算比较联合拟合与纯影像拟合,给出了稀疏光谱如何改善留出预测的直接证据。SARVIA 适合作为 backbone 适配的方法储备,预计 30–40 分钟。它有跨六项公开基准的下游结果,最清楚的采样器消融则来自一个开发集。两篇论文分别值得追问观测究竟约束了哪些谱特征,以及已具备的通用视觉能力和短程后预训练各贡献了多少。
二、入选论文概览
| 优先级 | 英文标题 | 论文类型 | 核心贡献 | 数据或基准 | 代码状态 | 适用研究场景 | 一句话判断 | arXiv |
|---|---|---|---|---|---|---|---|---|
| 1 | Spectro-Spatial Survey Fusion | 天文交叉 | 用自适应二维高斯与共享光谱字典,通过观测算子联合拟合图像和光纤光谱 | SDSS/BOSS COSMOS,外部 HSC PDR3、DESI DR1 | 公开研究代码快照,含 SDSS 拟合路径,缺原拟合权重和完整外部分析流程 | 跨巡天光度一致性、稀疏光谱补全、联合去混叠 | 留出观测支持连续谱重建,细谱线需要独立谱证据 | 2611.21798v1 |
| 2 | SARVIA: Fast-Adapting the Strong SAR Foundation Models That Are Already in Your MLLMs | 纯 CV backbone | 基于可计算答案与损失驱动采样做短程 LoRA,再导出独立视觉编码器 | TerraMesh、SARLO-80、KuroSiwo,六项 SAR 检测和分割基准 | 官方 Apache-2.0 仓库,模型、训练、评估和配方已核实 | 新传感器表征适配、旋转检测、多尺度特征提取 | 先测通用编码器,再衡量每种领域监督带来的额外增益 | 2611.22273v1 |
三、逐篇深度分析
Spectro-Spatial Survey Fusion
基本信息 Georgios N. Vassilakis、Miles Cranmer、Vasily Belokurov。arXiv:2611.21798v1,astro-ph.CO、astro-ph.IM。首版于 2026 年 11 月 16 日提交。论文和实现分别见 arXiv 摘要、HTML 正文、PDF 和 官方代码快照。
科学问题与适用场景
同一个星系的宽带像素保留空间分布,却把波长方向压成几个积分。光纤给出逐波长的谱通量,却把视宁度展宽后的邻近光源和目标内部结构一起积分。直接匹配两个巡天的目录时,源的分割、孔径和标定都已受各自管线影响。逐波段叠图可以提高成像信噪比,但叠图仍对应特定带通和有效 PSF。作者改为联合拟合原始观测域中的校准测量,使同一个潜在场同时解释单次曝光和光谱。与依赖覆盖全域的 IFU 融合不同,本文要把稀疏光纤的信息传到只有成像的位置。能否可靠预测未拟合的测量,是判断这项设计价值的主要依据。 引言
值得精读的判断 共享字典确实能把已观测光谱对连续谱的约束传给同一天区的其他目标。模型可用于设计跨巡天测量和检查通量一致性。把预测当作可测量线强或等值宽度的光谱,仍缺独立验证。
观测、掩膜和检验划分
拟合天区为 COSMOS 中约 84′ × 84′ 的区域,场模型覆盖观测波长 2980–11230 Å。SDSS 在 2000 年 5 月至 2001 年 2 月取得 82 个场的五波段观测,共 410 幅
拟合集含 400 幅曝光和 800 条光谱,后者包括 433 个星系、109 个类星体和 258 颗恒星。整幅留出每带两张,另按小于 10″ 的邻近位置建组,再整组留出 89 条光谱,含 41 个星系、23 个类星体和 25 颗恒星。相邻 SDSS 场有 128 行重复读出,只要一份被留出,另一份也从目标函数删除。不同观测运行或相机列的独立重叠仍可参与拟合。因此作者按留出曝光有无同带输入分区评分。另有 2% 随机留出像素和谱道作开发诊断,成像峰值初始化仍看到了这些曝光的完整源图,随机留出像素只适合作拟合过程诊断。HSC PDR3 与 DESI DR1 均未参与场的初始化和拟合,但都观测了同一片天空,检验的是观测算子迁移。 第 3.2 节 · 第 5.2 节
场表示、仪器渲染和优化
模型把平天区中的天空亮度写成空间和谱形的可分离组合。每个二维高斯
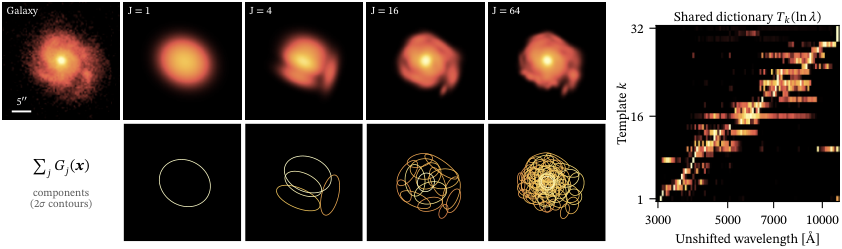
两类仪器共享同一场,通过不同算子产生预测。影像算子在每个波段用光子计数权重
目标函数对像素和谱道的平方残差按各自方差加权,标准联合拟合对光谱项再乘 5。影像背景估计固定,每轮用当前预测的源加天空计数更新散粒噪声方差。这样可减轻直接用观测计数作权重对低波动像素的偏好。残差超过 10 倍数据误差的像素改用原始数据方差,防止预测方差过小。求梯度时固定这些权重。评估采用从观测量推得的误差,令平均平方标准化残差 MSP 等于平均的
作者从拟合曝光的光峰初始化十万个高斯,合并重复峰,并在峰周围布置多种宽度。每步取一万个像素与 64 个谱道,对偏向有源像素的采样做逆概率加权。稀疏 Adam 只更新当前观测渲染涉及的成分,共享模板每步更新。增长阶段按位置梯度筛选,复制小成分或把大成分拆成两个子高斯,同时平分振幅并继承谱形,保持各波长的总通量。过暗或过宽的成分会被裁去。成分数在第 14,900 步达到约 564 万,最终为 285.5 万。11 个影像 epoch 用时 8 小时,单张 NVIDIA B200 峰值分配显存约 11 GB。实际运行使用 PyTorch 与自定义 Triton 内核,跨天区扩展还要计入观测准备、空间索引与多次拟合成本。 第 3.4 节 · 附录 B
实验结果与可复现性
| 检验 | 代表结果 | 证据所及 |
|---|---|---|
| 400 幅拟合曝光 | 五带的有源像素总通量低 0.4%–1.7%,逐像素绝对残差和为观测通量的 5.4%–6.8% | 总通量接近,局部亮度偏差仍可互相抵消 |
| 800 条拟合光谱 | 96.1% 的积分通量落在观测的 ±10% 内。最亮、最暗三分位的中位 MSP 为 4.37、0.99 | 高信噪比观测能显出线形或仪器误差,积分通量指标会弱化这类差异 |
| 89 条整条留出光谱 | 联合拟合中位 MSP 6.01,纯影像 98.5。三个随机种子各有 88 条由联合拟合取得更低 MSP | 同影像、同预算下加入稀疏光谱对谱形有直接增益,残差仍大于观测噪声 |
| 10 幅留出曝光 | 无同带覆盖区域,有源像素的预测/观测通量比为 0.45–1.16,两幅 | 其他波段能保留主要空间轮廓,定量光度受波长覆盖限制 |
| HSC、DESI 外部观测 | HSC 无拟合 SDSS 光纤的 49 个星系在 6″ 半径内中位通量比 1.01,改为 3″ 直径后为 0.967。DESI 同类选样的 80 个星系中位通量比 0.986,百 Å 谱形误差中位数 9.9% | 同一天区可跨仪器查询,结果依赖孔径且限于所选样本与谱分辨率 |
这些结果的顺序很重要。拟合指标先说明场有足够容量。整条留出与三组随机种子才检验光谱信息是否离开已拟合光纤后仍有效。外部预测只用各自仪器响应和标定,没有用 HSC、DESI 光通量回调该场。HSC 的两例有可辨认的旋臂,细结与中心结构有残差。DESI 样本按 SDSS 孔径亮度挑选,且两个有无拟合光纤的组独立取样。原文表 2 的 5.6% 对 9.9% 形状误差适合描述两组,不能直接视为给同一星系增加光谱后的因果增益。 拟合结果 · 留出与外部比较
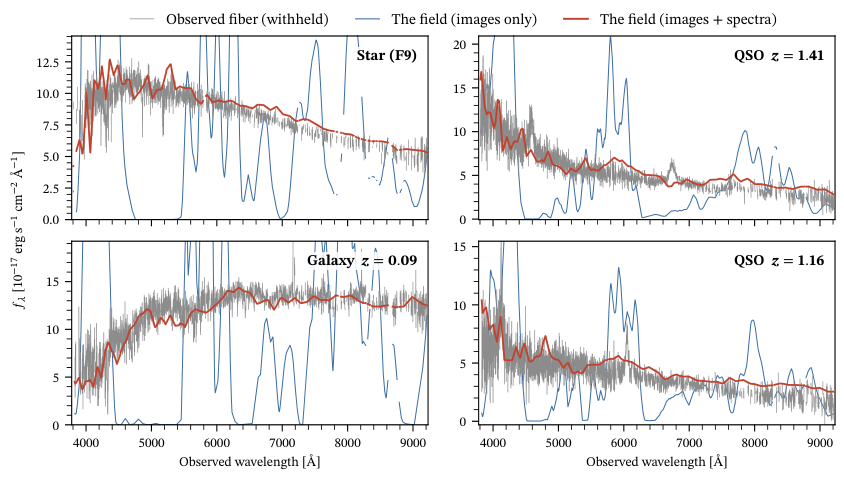
证据评价 对同一 COSMOS 场的宽带连续谱增益给高可信度,对跨仪器孔径通量给中等可信度。图 11 记录了两类容易进入下游目录的残差。长条高斯可形成虚假细线,固定天空背景又可把非光度夜的矩形背景偏差吸收到弥散结构中。恒星也有域差异:缺少 SDSS 拟合光谱的 80 颗 DESI 恒星,中位光谱通量比为 0.814。最亮三分位中 27 颗有 25 颗在至少一幅参与拟合的
公开仓库含场表示、观测算子、SDSS 数据准备、两种拟合配置和留出评估脚本。作者发布的冻结快照不含拟合检查点与完整 HSC、DESI 分析路径。仓库的导出验证覆盖配置、代表性数据与单元检查,完整观测下载和论文训练并未在导出时重跑。优先从少量曝光和光纤验证坐标及通量约定,再判断是否值得重建整个天区。 数据可用性 · 仓库验证记录
审稿人视角:最大问题与研究启发
最大的一个问题
无光纤位置的细谱结构在现有观测下可辨识性不足。这直接决定了虚拟光纤能支持怎样的物理推断。五带积分可以约束颜色,同样的五个通量仍可能对应不同线强和线比。6000 Å 附近模板节点相隔约 84 Å,仪器线扩展函数只有几 Å。第 5.1.1 节和图 7 的留出改进主要体现在连续谱,表 2 的 DESI 谱形按 100 Å 分箱评分,图 10 的旋臂位置无对应真谱。第 6 节已指出窄线平滑并且缺少逐预测的校准误差,现有对照仍支持连续谱和宽带预测的结论。若要验证发射线诊断,最小改动是在同类天区留出一组有独立 IFU 的星系,仅使这些目标的成像进入拟合。在事先指定的若干孔径上,以匹配的视宁度和谱分辨率比较 Hα 等值宽度、线通量和误差覆盖率,并在相同的划分下保留纯成像对照。 留出光谱 · 虚拟光纤 · 讨论
研究启发与可执行验证
先在观测域检验每一种物理量。对连续谱或测光融合,可按场区或目标组留出,而后分别检验宽带光度、经孔径匹配的谱形,以及窄线残差。对源形态,按与拟合 PSF 的尺度比报告通量和结构误差,并在已知亮度的人工源或高分辨率独立成像上复核。这样可以识别出哪些增益来自多模态约束,哪些特征仍主要由字典和空间基底决定。建议先读第 2.2–2.3 节与图 2,再看图 7、表 2 和图 11。复现拟合时回看第 3.3–3.4 节和附录 B。 表示与算子 · 实验 · 附录 B
SARVIA: Fast-Adapting the Strong SAR Foundation Models That Are Already in Your MLLMs
基本信息 Yuxuan Li、Zichen Tian、Qianru Sun。arXiv:2611.22273v1,cs.CV。首版于 2026 年 11 月 17 日提交。 arXiv 摘要 · HTML 正文 · PDF · 官方实现
研究问题与方法定位
合成孔径雷达(SAR)的亮度取决于微波散射,图像还受相干斑、入射几何和极化方式影响。专用基础模型往往通过大量雷达数据和传感器专用目标学习这些规律。SARVIA 先检验通用多模态大模型的视觉编码器可以迁移多少,再以少量更新强化雷达表征。作者在 OEM-SLC-Amplitude 的相同分割设置下发现,未适配的 Qwen3.5-2B 视觉编码器已达 36.29 mIoU,高于 TerraMind 的 34.69 和 SARMAE 的 33.07。论文的增量主要是构造可计算的监督、按任务损失分配短程训练预算,以及把适配后的编码器交给常规视觉头。 引言 · 相关工作 · 表 2
值得带走的判断 面对新传感器,先测强通用编码器及轻量适配的基线。SARVIA 的核心设计是让不同类型的可计算监督共享一个已存在的问答接口,同时把部署路径保留为常规检测或分割网络。
从原生测量到可计算监督
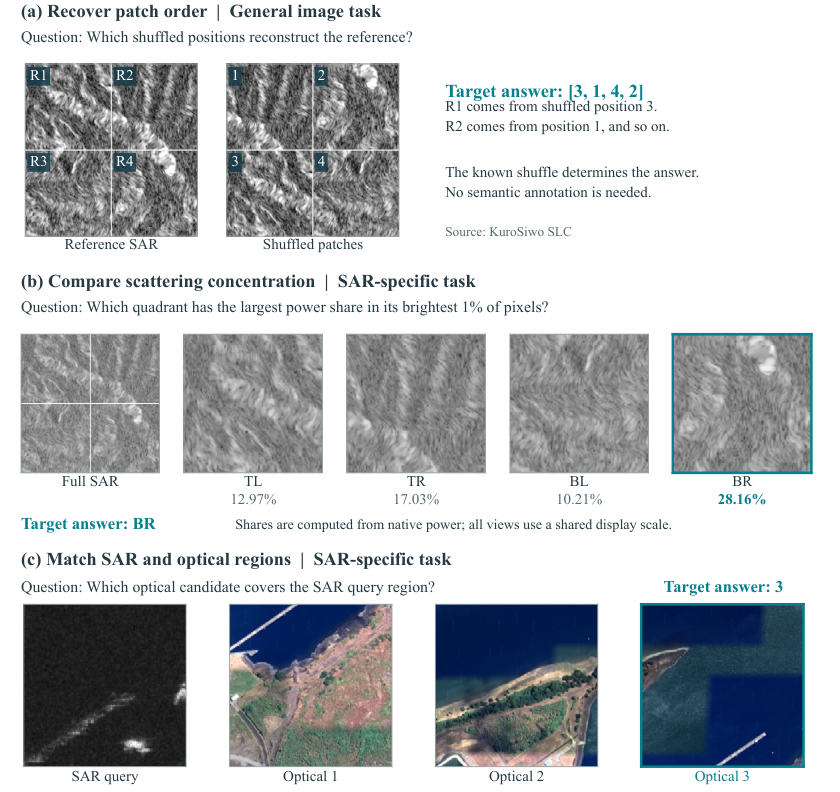
预训练池由 TerraMesh 的 Sentinel-1 观测、SARLO-80 雷达—光学配对和 KuroSiwo 多时相雷达组成。附录表 S1 给出 859,048 个训练源记录和 317,128 个诊断评估池记录。每个记录可有多极化、历元或配对视图,并能派生多个问题。视觉输入和监督数据分开处理。以 TerraMesh、KuroSiwo 为例,默认可见输入用 VV,转换到 dB 后按第 1 和 99 百分位缩放,复制成三个灰度通道再缩放至 448 × 448。涉及相对功率的答案由原生数据计算。复数 SAR 取振幅平方,dB 功率转回线性尺度,再按区域计算均值、相对方差或最亮 1% 像素占区域总功率的比例。作者检查答案在原生值和呈现视图之间是否一致,还用最小差距过滤歧义样本。 数据与呈现 · 测量目标
第一类任务用已知空间变换确立答案,例如还原 patch 置换、找出翻转块或定位裁剪块,训练局部结构和尺度对应。第二类把空间关系与雷达测量结合。例如先在光学图上定位对应区域,再根据原生雷达功率给出排序。SARLO 的官方配准网格提供成对裁剪、检索和合成位移的几何真值。87 种变体包含 24 种通用图像任务和 63 种 SAR 专用任务,共 131 个来源与任务组合。模型接收有序图像与问题,答案可统一表示为索引、排列、排序或框坐标。作者的动机是让不同任务共用已有的文本预测接口,新增任务只需定义可核验的目标和输入构造。 第 3.1–3.3 节 · 附录表 S2
LoRA、损失采样和视觉输出
MLLM 的底座参数在适配期固定。图像通过 ViT 与多模态 merger,同问题一起进入语言解码器。三处线性层加 LoRA,在相同答案目标下联合更新。公式 1 只累加答案 token 的负对数似然,给定图像序列
每个来源—任务变体维护快、慢两个答案损失指数移动平均
第一项在中等残余处最大,使已饱和与停滞任务都少占预算。第二项奖励仍有下降空间且确在学习的任务。最后一项在损失反弹时增加再次抽样的机会。总预算固定为 TerraMesh:SARLO:KuroSiwo = 1:4:1,采样只在各个来源内重新分配。每个窗口 100 个优化步,窗口末累计的损失用于再下一个窗口,给数据预取留出固定顺序。保留 1% 的先验混合并对概率变化设界。用于调度的损失统计与梯度分离,无需额外模型评估,后续训练的答案损失也不作重要性重加权。 第 3.4 节 · 附录 C
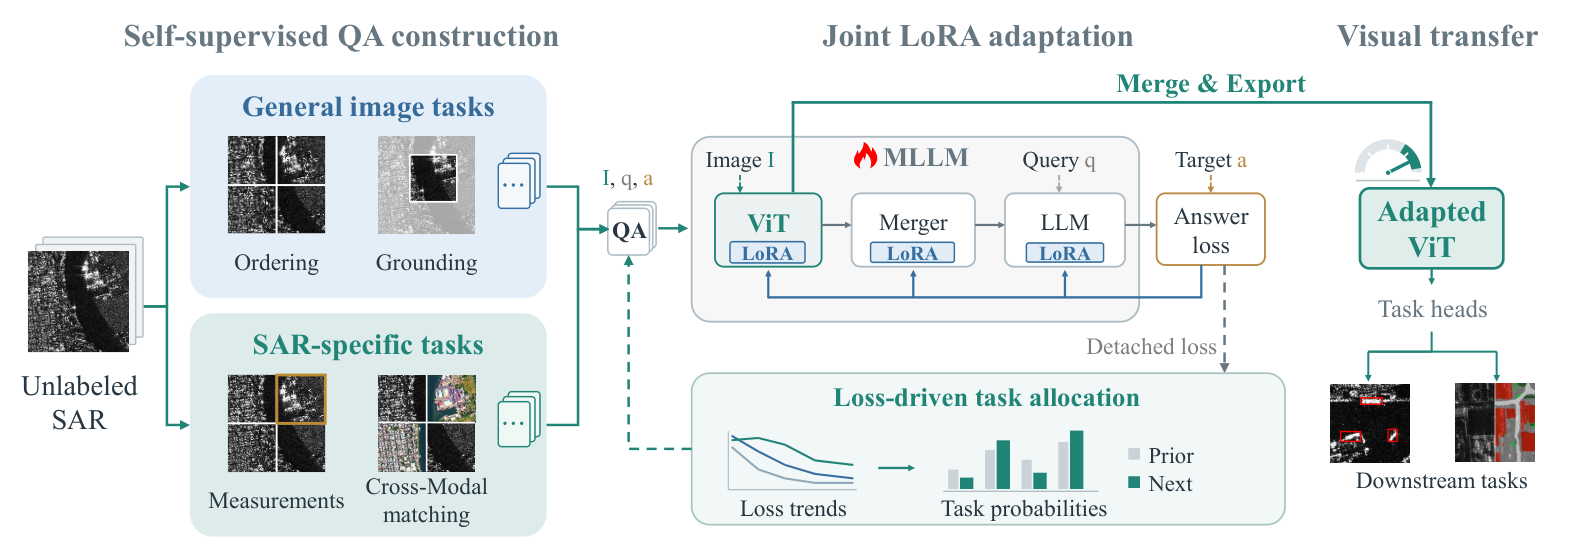
导出时把视觉 LoRA 合入 ViT,取 merger 之前的视觉输出。主模型 ViT-L 为 24 层、宽度 1024,ViT-B 为 12 层、宽度 768。主模型代码从 16 × 16 patch 得到步幅 16 的单尺度网格,用可插值的学习式位置表和二维旋转位置编码。下游的卷积分支先提取局部空间先验,四组 ViT block 通过可变形注意力与多尺度特征交换信息,主配置按第 0–7、8–11、12–15 和 16–23 层划组。经上采样和融合得到步幅 4、8、16、32 的四级输出。作者将这一层次结构用于补足 MLLM 单尺度输出的空间细节,额外成本来自卷积分支、多尺度交互与下游 neck。论文未给出分项 FLOPs、推理延迟或峰值显存。 导出设计 · ViT 实现 · 适配器
以 RSAR 为例,SimpleFPN 把四级特征转换成 256 通道的五级特征。旋转 RPN 用锚框生成提议,正负 IoU 阈值为 0.7 和 0.3,采用目标性分类与 Smooth L1 回归。旋转 RoI 头用旋转框重叠以 0.5 分配,训练六类分类与框的中心、宽高、角度回归。SARDet-100K 则用水平框及三级 Cascade RoI 头,分配阈值为 0.5、0.6、0.7。分割使用 UPerNet 与辅助 FCN 头。论文报告旋转检测输入为 RSAR 800 × 800、M4-SAR 512 × 512,水平检测 SARDet-100K 为 1024 × 1024。检测全局 batch 为 8、12 个 epoch,在第 8、11 个 epoch 降学习率。分割做随机裁剪、滑窗推理,40,000 步和 batch 16。各数据集采用自己的评估划分,AIR-PolSAR-Seg-2.0 使用验证集,WHU-OPT-SAR 按场景划分后切片。 下游设置 · 附录 B.1 · RSAR 配置 · SARDet 配置
结果、消融和训练成本
| 下游基准 | 指标 | SARVIA ViT-B | SARVIA ViT-L | 表中 ViT-L 规模的最佳对照 |
|---|---|---|---|---|
| RSAR | 旋转 AP50 | 70.29 | 73.40 | SARMAE 72.20 |
| SARDet-100K | COCO mAP | 55.10 | 59.15 | SARMAE 54.11 |
| M4-SAR | 旋转 AP50 | 41.23 | 50.93 | SARATR-X-v2 46.62 |
| OpenEarthMap-SAR | mIoU | 35.76 | 36.90 | SARATR-X-v2 35.14 |
| AIR-PolSAR-Seg-2.0 | mIoU | 93.37 | 94.60 | SARATR-X-v2 90.20 |
| WHU-OPT-SAR | mIoU | 48.19 | 48.79 | TerraMind 48.72 |
大模型在三项检测中的表内领先幅度为 1.20、5.04 和 4.31 点。WHU-OPT-SAR 的差距仅 0.07 点。表 3–8 同时包含不同架构与预训练来源,结果说明最后导出的系统具有竞争力。受控的适配前后比较应看表 2,五个通用编码器在同一个开发集上均提高,幅度为 1.06–4.24 mIoU。主模型从 36.29 到 39.70,作者报告的新增适配成本为 1.92 个 RTX PRO 6000 GPU 小时。与 SARMAE、TerraMind 数百至数千 GPU 小时的对照属于估算或测量的域训练成本,通用底座的历史训练和六项下游微调成本都需另计。 表 2 与计算开销 · 表 3–8
同一 600 步、相同采样来源配额下,表 9 给出通用任务 37.33、SAR 任务 37.94、两类静态混合 38.21,动态采样 39.70。TSCL 和 DWA 的动态策略反而低于 38.21,较强的 ACL 为 38.87。这支持两个具体判断。原生测量目标补充了通用空间任务,调度方法的选择也影响同一任务池的下游效果。600 步时,累计预期抽样量重分配约 10.55%,SAR 专用任务总占比只变动 1.05 个百分点,主要变化发生在同类任务内部。延至 800 步时问答准确率继续上升,开发集分割却由 39.70 降至 38.55。用问答损失选择视觉检查点需要额外的下游验证。 表 9 · 表 10 和训练动态
开源代码核验卡
2026 年 11 月 19 日核对官方 Apache-2.0 仓库的固定提交。arXiv 摘要及正文均指向该仓库,公开内容满足实质性开源门槛。这里的核验覆盖源代码和配方,实验指标以论文报告为依据。 官方摘要 · 固定提交
- 模型实现
sarvia/model.py加载独立编码器,视觉 Transformer、空间先验、可变形特征交互和适配器都有源码。采样控制器和答案损失统计分别在adaptation/sampling.py与adaptation/loss.py。 视觉模块 · 采样实现 - 训练入口
adaptation/train.py启动adaptation/worker.py中的 SWIFT 训练,调用可计算任务数据和采样逻辑。downstream/train.py提供检测和分割微调,公开配置给出权重、任务头、优化器和划分。公开适配配方默认跑 800 步并保留 600 步检查点,论文主结果使用后者。 适配配方 · 下游入口 - 评估路径 下游入口有
evaluate模式,downstream/evaluation.py接入原生评估,文档给出旋转框、水平框和分割评估协议及所用划分。 评估实现 · 基准说明 - 环境与数据 仓库区分独立编码器、适配训练和 OpenMMLab 下游环境,提供依赖、CUDA 构建和数据目录说明。公开 TerraMesh 与 KuroSiwo 各保留一万个记录,覆盖任务组合但改变候选观测和采样轨迹。文档提供已适配权重和下游检查点的入口。开发集复现另依赖正文附录 D 所述的 OEM-SLC-Amplitude 发布。 安装 · 数据说明 · 附录 D
审稿人视角:最大问题与研究启发
最大的一个问题
后预训练机制的增益归因依赖单个开发基准。表 2、9、10 以及 LoRA 秩和步数的选择都使用 OEM-SLC-Amplitude。它只有 274 张训练切片和 654 张评估切片,附录 D 还说明其标签和区域与 OpenEarthMap-SAR 有关联。现有材料没有给出具体重叠分区,也无法由此判定下游测试泄漏。更重要的是,表 3–8 展示了最终方案与其他模型的排名,却没有用同一个起点、头和预算隔离要检验的模块。第 4.2 节指向未适配 Qwen3.5-2B 的六项结果,PDF 第 5 页引用为“Table ??”,附录中未找到对应表。因此,对数值作表内比较的可信度较高,对相同幅度的采样收益能迁移到新传感器和任务给中等可信度。作者第 5 节承认 SAR 之外尚未验证。对当前结论最直接的补充是在与开发集不共享场区的旋转检测基准上固定配方,比较未适配、静态任务混合和损失驱动采样三组,并用多个种子报告 AP 与样本间变化。 开发集与下游对照 · 附录 D · PDF 第 5 页
研究启发与可执行验证
更换成像域时,先测固定骨干的可迁移表征,再分别测试领域监督和调度。对多波段天文影像,可把同一天区的已知 WCS 偏移、视宁度差或曝光掩膜变成有答案的匹配任务。图像显示拉伸和原生通量单位应分别处理,并按巡天或独立天区划分,以免模型靠图像重叠或管线纹理识别答案。任务价值由留出天区的目标定位、弱源召回和分割误差决定。 可计算任务 · 适用边界
可复用模块或设计思想
- 可计算问答监督 把配准坐标、原始测量和已知增强运算转成可核验的结构化答案,在更换任务时复用同一视觉训练接口。表 9 的静态混合结果给出对照。实现入口在
adaptation/tasks.py,接在检测标注微调之前。所需条件包括可靠的配准、明确的有效像元和能从输入辨认的测量量。成本主要来自数据准备和 MLLM 适配,导出后语言部分不参加检测。最小实验用相同数量的问答比较通用空间变换与加上原生测量目标的版本。 任务目录 · 混合监督消融 - 保留传感器配额的自适应采样 采样器接收各任务已分离梯度的答案损失,输出本来源内的下批概率。它能移植到分组明确、损失统计稳定的自监督训练循环。部署模型无需新增参数,训练侧要维护每个任务的损失统计、预取窗口和一致的批次配额。论文没有独立报告这些调度开销。先用同初始化、同样本预算的静态配比作对照,并在不同随机种子下核对增益是否超过波动。 采样实现 · 调度消融
建议选读图 3、第 3.4 节、表 2 和表 9。走实现路线时,再查附录 C、下游配置及导出入口。看迁移证据时同时读表 3–8 和附录 D。 方法与实验 · 附录 C
四、跨论文结论与行动建议
- 优先读联合巡天拟合。它的纯影像对照、整条留出光谱与跨仪器检查依次回答了可辨识性、输入增益和观测迁移问题。复现完整 COSMOS 拟合要准备单次曝光、光纤管线元数据与 Triton 环境,适合先在小片天区核查光度。离开有光纤的位置,研究用途宜优先限于连续谱与宽带预测。
- 把 SARVIA 作为新成像域适配的储备。可计算任务、静态混合、动态配额三个环节可以独立验证。文章给出的检查点有助于降低直接评估成本,重新训练的主要工作仍在资料准备和公开子集与原始训练池的对齐。问答成绩上升后,下游检测仍需要自己的停止判据。
- 两项可立即设计的对照。巡天融合可在同一组留出目标上比较纯成像与加入邻域光谱后的通量、连续谱和谱线误差。视觉适配可固定检测头、初始化与样本预算,比较静态任务混合和损失采样,在不同场景或仪器的留出集上按目标尺寸报告召回与 AP。这两类实验都应在划分锁定后再调配方。
本报告由 GPT 6.2Sol XHigh 整理分析,博客作者对分析内容不负责且不代表博客作者本人的想法。