一、本期总体分析
arXiv 论文时间范围:[2026-11-17 05:00:00, 2026-11-18 05:00:00)(Asia/Singapore) 各分类篇数:astro-ph 211;cs.CV 511;cs.LG 774;cs.AI 717;stat.ML 115(含跨类,分类间可能重复) 入选篇数:2
本期两篇论文都围绕天文观测的前向建模,但控制对象不同。TDSM 从恒星参数生成光谱,再反过来拟合观测;Flow-VAE 从一组形态描述量生成星系图像。前者把理论光谱对参数的响应加入训练,后者把生成条件重新测量出来,检验网络是否兑现了输入要求。两者都说明:输出与训练数据相似,只是验证的起点。
优先精读 TDSM。它给出了从合成谱、连续谱归一化、数值拟合到外部标定的完整应用链,并处理了上千万条真实光谱。它最有价值的部分是把参数可辨识性落实到光谱导数,而最需要核实的是导数监督究竟带来多少独立增益。Flow-VAE 适合作为可控图像模拟的方法储备,尤其值得学习其“生成后重新测量”和按联合条件支持度检查失败的做法;其高恢复率不能直接解释为罕见星系形态也能可靠生成。
建议先用约 45–60 分钟阅读 TDSM 的方法与标定,再用约 35–45 分钟阅读 Flow-VAE 的条件生成、表 3 和低密度条件实验。复现前,两篇都还有具体材料需要补齐:TDSM 的训练实现未在本文来源中核实;Flow-VAE 虽有作者仓库,公开默认设置与本文实验存在差异。
二、入选论文概览
| 优先级 | 英文标题 | 类型 | 核心贡献 | 数据或基准 | 代码状态 | 适用研究场景 | 一句话判断 | 论文 |
|---|---|---|---|---|---|---|---|---|
| 1 | Model-Driven Stellar Spectroscopy with the Total Differential Spectral Model (TDSM): Framework and Its Application to 11 Million LAMOST Low-Resolution Spectra | 天文交叉 | 同时监督合成光谱通量与参数导数,并完成大规模谱拟合和标定 | Kurucz 合成谱、LAMOST DR10、多个外部参考集 | 本文未提供已核实的训练仓库 | 恒星光谱模拟、参数反演、物理响应约束 | 方法值得精读;模拟精度与真实星的绝对精度须分开看 | 2611.20633v1 |
| 2 | From Non-parametric Statistics to Images: Generating Galaxy Morphologies | 天文交叉 | VAE、条件归一化流与 GMM 联合支持形态条件生成及支持域诊断 | 240,000 张 DECaLS 单波段星系图像 | 作者仓库可访问,有模型和训练代码;本文配置对应关系未完全确认 | 星系图像模拟、形态选择效应和生成条件检验 | 典型条件下有用;稀有联合条件下误差明显增大 | 2611.19211v1 |
三、逐篇深度分析
1. TDSM:让前向光谱模型同时学会通量与参数响应
基本信息:Lanya Mou、Maosheng Xiang、Haibo Yuan、Tianmin Wu、Meng Zhang;arXiv:2611.20633v1;分类 astro-ph.GA。首次提交及当前版本日期均为 2026-11-16。摘要页、HTML 全文、PDF。摘要页列有期刊出处 ApJS 287, 24 (2026) 及 DOI;以下分析以 arXiv v1 为准。
适用研究场景与结论:适合研究低分辨率光谱中的恒星参数反演、合成谱代理模型和物理响应约束。值得精读的观点是:一个前向模型即使把通量拟合得很准,也可能没有学对“改变某个参数会怎样改变光谱”。参数推断依赖这些方向性响应,因此导数精度需要单独验证。
科学问题、数据与标签来源
低分辨率光谱中,多种元素吸收线严重混叠,同一段通量变化也可能由温度、金属丰度或表面重力共同造成。纯数据驱动模型可以利用高分辨率参考标签训练,但训练星的覆盖范围会限制其对热星、冷星和贫金属星的适用性。TDSM 延续 The Payne 的前向谱建模思路,从大范围理论参数生成光谱,并在拟合真实光谱时同时求解参数。
论文使用两类性质不同的数据,不能把它们混为同一种“真值”。
第一类是理论训练数据。作者根据 MIST 等时线抽取有效温度、表面重力和金属丰度,其余参数在指定区间随机抽样,用 ATLAS12 平面平行大气和 SYNTHE 辐射转移计算 14,901 条 Kurucz 合成谱。原始分辨率为
第二类是真实巡天观测。LAMOST DR10 包含 11,817,425 条低分辨率光谱,其中 11,473,640 条被原管线分类为恒星,观测时间为 2011 年 10 月至 2022 年 6 月。论文处理的是这些恒星谱,约对应 800 万个独立天体;它没有把重复观测当成新的独立恒星。拟合使用约 3,700–9,000 Å 的光学光谱,LAMOST 低分辨率数据约为
真实恒星参数也没有逐个直接测量的无误差真值。作者采用 IRFM 温标、APOGEE DR17、GALAH DR3、PASTEL、贫金属星参考样本及 DD-Payne 等进行标定或比较,并用 Kepler 星震学表面重力提供另一种检验。参考集的标度、覆盖范围和相互依赖,都是解读结果的一部分。
方法:从七维参数到光谱,再从光谱回到参数
设恒星标签为
光谱值决定模型是否经过正确位置,参数导数决定它朝哪个方向变化。只监督通量时,网络仍可能在参数协方差较强的方向上学到不准确的局部响应。作者明确提出,用理论模型计算的梯度给网络增加约束。
实际训练并非用这条线性展开替代整个光谱模型,而是训练一个非线性全连接代理。七个主输入是
导数标签来自随机选取的 689 个参考参数点,每点计算七条差分谱。温度步长为 100 K,表面重力和丰度步长为 0.2 dex。式 2 使用单侧有限差分,因此这里的梯度真值仍继承大气模型与差分步长的近似,不是对真实恒星大气的无误差测量。
式 3 的目标可概括为:
这里
网络训练完成后,参数反演使用 Levenberg–Marquardt 数值拟合,而不是再训练一个“光谱到标签”的直接回归器。给定观测光谱、误差和掩膜,优化器调整恒星参数,让代理谱匹配观测。最终第八个标签 [Mg/Fe] 也不是七维网络的普通联合输出:作者先得到七个参数,再固定除 [
真实光谱处理决定了方法能否落地
第 III 节值得和网络结构同样认真地阅读。作者先用 LAMOST 管线径向速度将光谱线性插值到静止系,再用原谱除以高斯平滑谱进行归一化。全样本各自采用 25 Å 和 100 Å 两种平滑核:较窄核适合原子线占优的暖星,较宽核保留冷星宽分子带。两套拟合结果按
归一化抑制消光和宽尺度标定误差,但也会改变可用于推断的谱形信息,因而需要与合成谱保持一致。论文没有把这些步骤简化成一个对全部恒星都合适的固定连续谱操作。
优化还存在物理退化:Balmer 线在 A0 附近最强,温度响应在该区域改变符号,从太阳温度初始化可能把真正的热星拟合到较冷的局部极值。作者分别从 5,800 K 和 15,000 K 初始化,并结合 He I、He II、Ca II 线、拟合优度及原管线分类决定采用哪组解。对约 9,000–10,000 K 的人工“A 型星缺口”,又增加屏蔽 Balmer 线的拟合,并在相应温区做平滑组合。
这些步骤是解决真实退化的工程处理,也意味着最终目录的行为不能只归因于导数损失。第 V.1 节仍指出约 10,000 K 附近存在组合造成的条纹;分析这一温区的星数分布时,需要先排查这些算法结构。
定量证据:三种误差对应三种问题
| 检验 | 样本与协议 | 代表结果 | 能支持什么 |
|---|---|---|---|
| 理论通量插值 | 3,901 条未用于通量训练的 Kurucz 谱 | 像素残差标准差 | 网络能精确逼近该理论谱库 |
| 理论梯度拟合 | 使用导数训练样本计算残差 | 标准差 | 对已监督梯度的拟合很好;不是独立梯度测试 |
| 带噪合成谱反演 | 1,309 条 FGK 合成谱,S/N=50,加经验误差 | 约 36 K、0.16 dex、0.06 dex,分别对应温度、 | 在同一理论模型及采用的误差模型下能恢复输入参数 |
| 真实重复观测 | 同一源两次观测,S/N 相差小于 10%,差值散布除以 | 富金属 FGK 矮星在 S/N=100 时约 25 K、0.06 dex、0.03 dex | 实际重复测量具有较高内部一致性 |
前两行对应图 2,合成谱反演见图 5,重复观测见图 9。不能把第一行的约 0.05% 通量误差改写为恒星物理参数具有 0.05% 的真实精度。
带噪合成谱实验中,[
真实重复观测的结果同样有明确适用范围。富金属 FGK 矮星在 S/N=20 时温度、
第 IV 节外部标定缓解了参考标度差异:温度按 IRFM,金属丰度分别提供 LTE 与 NLTE 两种标度;
图 10 中,校准后的 LTE [Fe/H] 与 APOGEE 的散布为 0.071 dex,[Mg/Fe]、[C/Fe]、[N/Fe] 与 APOGEE 的散布分别为 0.050、0.084、0.138 dex。但这些比较与标定参考存在关联。附录 B 还说明,
证据强度、边界与复现条件
本文对“轻量网络可以高精度模拟 Kurucz 光谱,并用于大规模真实谱拟合”的判断给出较高可信度;对“导数监督相对通量监督的实际增益”给出中等可信度,因为缺少直接隔离该变量的实验;对热星、极冷星和稀有丰度区域的绝对准确度,仅给予有限信任。
主要物理边界来自 LTE 大气、分子不透明度、谱线表及平面平行近似。作者在第 V、VI 节明确提醒,热星和冷星的丰度标定不足,M 型星的部分分布结构来源仍不清楚。合成库覆盖广泛,并不自动意味着每个区域都具有同等的实际准确度。
文内也有范围表述差异:摘要以 45,000 K 为性能范围上限,总结中写到 50,000 K;表 1 的合成库范围与实际目录范围也不完全相同。使用时应分别核对训练支持域、具体天体所在区域和外部标定覆盖,不将单一精度数字外推到全部温区。
计算成本方面,第 VI 节报告约 1,500 CPU 小时完成约 1,100 万条谱的七标签拟合,硬件为 2.5 GHz AMD 处理器。这是整批任务成本,不是单条谱的实时性能保证。本文来源中未找到可核验的 TDSM 训练仓库;作者声明目录公开,但本次未核实可下载目录文件及其完整发布位置,因此不能称为已经复现。
阅读路线:精读 II.1–II.4 的梯度构造、损失和测试,再看 III.2 的初始化与 A 型星处理、IV.5–IV.6 的内部和外部误差;图 3 的参数响应谱与附录 A 尤其值得对照。目录使用者还应阅读 III.3 的质量标志及 V.1–V.2 的警告。
审稿人视角:最大问题与研究启发
最大的一个问题
导数监督这一核心增量,尚未通过同条件消融证明它实际改善了多少恒星参数推断。第 II.3 节将全部差分谱用于训练,第 II.4 节的梯度残差也是在训练样本上计算;独立通量验证、带噪合成谱反演和真实目录比较展示了整套系统的可用性,却没有提供同一网络仅用通量损失时的对照。
这个问题直接影响对方法贡献的归因:目前无法分清参数结果中有多少来自导数项,有多少来自理论谱库覆盖、模型容量及后续拟合和标定。它不推翻已展示的目录价值,也不意味着梯度约束无效,但使“应当为其他光谱任务增加这项监督”仍需实验支撑。作者解释了导数监督的物理动机,并承认模型系统误差;这些解释没有替代增量对照。
最小验证是固定谱库、网络、波段分段、初始化和拟合协议,只比较通量损失与通量加导数损失;保留一组从未参与梯度训练的参数点,同时检查梯度误差、未标定参数偏差和真实参考星结果。这样可以直接判断额外理论计算是否换来了实际反演收益。
研究启发与可执行验证
前向模型的验证应同时覆盖函数值、局部响应和逆问题结果。迁移到其他天文光谱任务时,可先在物理模型可靠、有限差分稳定的区域构建小型对照;按参数空间块保留测试点,并在信噪比、金属丰度和温度分层报告误差。导数监督增加了理论计算和自动微分成本,也可能把错误的物理响应更强地写入网络,因此必须保留真实观测检验。
对于目录使用,另一个可执行步骤是分别比较原始参数与标定参数,先按质量标志和适用温区构建样本,再检查研究结论对这些选择的敏感性。这是面向新应用的验证建议,不能视为论文已完成的跨巡天检验。
2. Flow-VAE:按形态统计生成星系,并检验生成条件是否被兑现
基本信息:Quanfeng Xu、Mi Chen、Renhao Ye、Siyuan Chen、Nan Li、Shiyin Shen;arXiv:2611.19211v1;分类 astro-ph.GA。首次提交及当前版本日期均为 2026-11-14。摘要页、HTML 全文、PDF、作者代码仓库。
适用研究场景与结论:适用于需要控制星系形态统计的图像模拟,以及形态相关选择偏差的研究。最有价值的设计是把图像生成看作一个可检验的条件采样问题:先指定描述量,再从输出图像重测这些量。它能在典型条件下提供有效控制,但不能根据几个统计量相符,就认定具体旋臂、棒或潮汐结构真实。
五个统计量能规定什么
论文的科学出发点是,解析亮度轮廓擅长控制整体形状,却不容易直接规定不对称和斑块结构。非参数形态指标直接由像素分布计算,因此同一测量程序可以用于观测、模拟和生成图像,适合检验条件是否被满足。
条件向量为
这些统计量描述的是测量得到的表面亮度结构,不是五个可以任意独立调节的物理属性。两个外观不同的星系可以有相近的五维描述量,同一星系也会随分辨率、PSF 和背景处理改变测量值。因而合理目标是学习条件图像分布,而非从五个数字唯一还原一个星系。
样本、预处理与测试划分
论文从 SDSS 主星系样本出发,结合 DESI Legacy Imaging Surveys 的 DECaLS 成像。表 2 从 633,568 个 MGS 对象开始,经南部成像覆盖、与 DR9 BGS_BRIGHT 目标在 0.79 角秒内匹配、cutout 可用性及中心源检测等要求,最后选取 240,000 个星系。训练实际使用
样本最初要求
污染源处理使用 SExtractor:检测阈值为局部背景之上
五个统计量由 statmorph 测量。为了去除罕见极值,采用约覆盖 99% 样本的区间:
| 描述量 | 采用区间 | 区间宽度 |
|---|---|---|
| 0.5–4.5 | 4.00 | |
| −0.7–1.0 | 1.70 | |
| −0.25–0.2 | 0.45 | |
| 0.4–0.95 | 0.55 | |
| −2.5–−0.5 | 2.00 |
样本中 23.14% 的
240,000 张图像随机分为 216,000 张训练图像和 24,000 张测试图像。论文未给出按天空区域或观测条件隔离的测试,也未报告单独验证集及完整调参流程;不能仅凭这些缺项认定发生了泄漏,但现有随机划分不足以检验跨场区和跨巡天泛化。文中也未逐项给出独立的像素强度归一化或统一 PSF 匹配协议,不能按常见流程自行补全。
VAE、条件流与 GMM 分别承担什么
VAE 先将图像编码为 40 维潜变量分布,解码器负责把潜变量还原成图像。损失中的掩膜像素误差保留目标和背景,KL 项约束潜空间。40 维是本文采用的表示规模,作者没有提供本论文中的系统维度消融来证明它对五种条件都最优。
条件 Masked Autoregressive Flow 学习的是
五个形态量作为上下文,同时进入基础高斯分布的均值、方差预测和自回归变换。它们不是被流变换直接输出的五个数。生成时先从
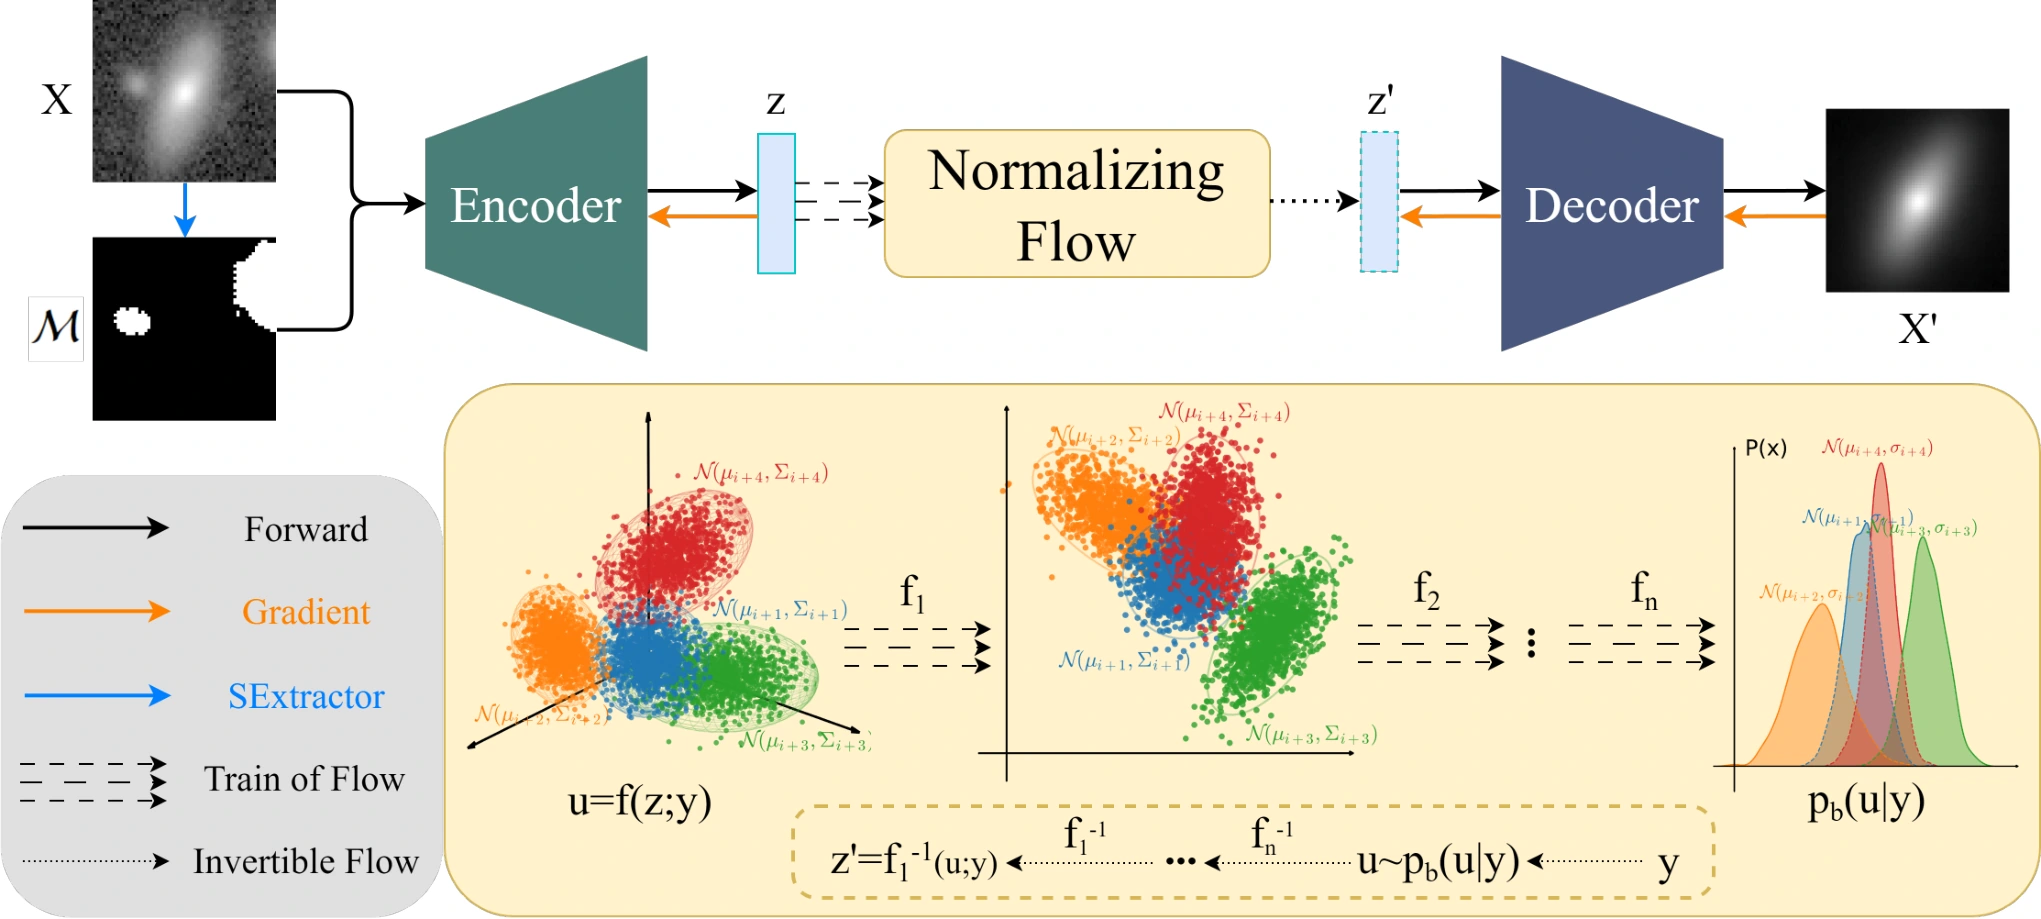
论文式 14 将掩膜重建、条件流负对数似然和 KL 正则联合起来,流项权重为 0.1。主文训练设置为 Adam、学习率 0.001、批量大小 256、100 轮,使用单张 80 GB NVIDIA A100。正文没有给出足以唯一重建全部网络层和各项超参数的细节,因此这些训练数字不能代替完整实验配置。
GMM 解决另一个问题:只指定
已知维度记为
结果:恢复率的分母和容差都不能省略
重建实验在 24,000 张测试图像上得到平均 SSIM=0.892。它比较同一图像的重建与原图,和“只给条件生成新图像”的实验不是同一个任务。
论文式 18 将形态残差除以该描述量的固定区间宽度:
成功标准
| 描述量 | 重建:10% 容差 | 单参数生成:10% 容差 | 固定中位数基线:10% 容差 | 单参数生成:5% 容差 |
|---|---|---|---|---|
| 96.62% | 90.95% | 69.09% | 61.6% | |
| 97.14% | 94.92% | 88.74% | 72.1% | |
| 99.97% | 99.83% | 87.49% | 88.7% | |
| 97.22% | 87.81% | 78.58% | 56.3% | |
| 96.96% | 88.79% | 75.74% | 56.2% |
数值来自表 3。生成实验固定一个描述量,从 GMM 条件分布补齐其余四个,再检验被指定的那个量。每个单参数成功率都不能当成五个条件同时满足的概率。
固定中位数基线特别有用:它完全忽略输入条件,却因样本分布集中而获得较高恢复率。
输入输出分箱关系还显示回归中心:请求较低的值容易被高估,较高的值容易被低估。作者没有把这种压缩直接归因为某一种测量误差机制,只将其作为观察到的系统趋势。
联合条件实验更接近实际使用。作者每次随机扰动一个描述量,幅度不超过其区间宽度的 10%,其余四个不变,再按各自范围截断。这样每个分量都在合法区间内,但完整向量可能落到稀少组合。用 GMM 对数密度的经验分位数转换得到
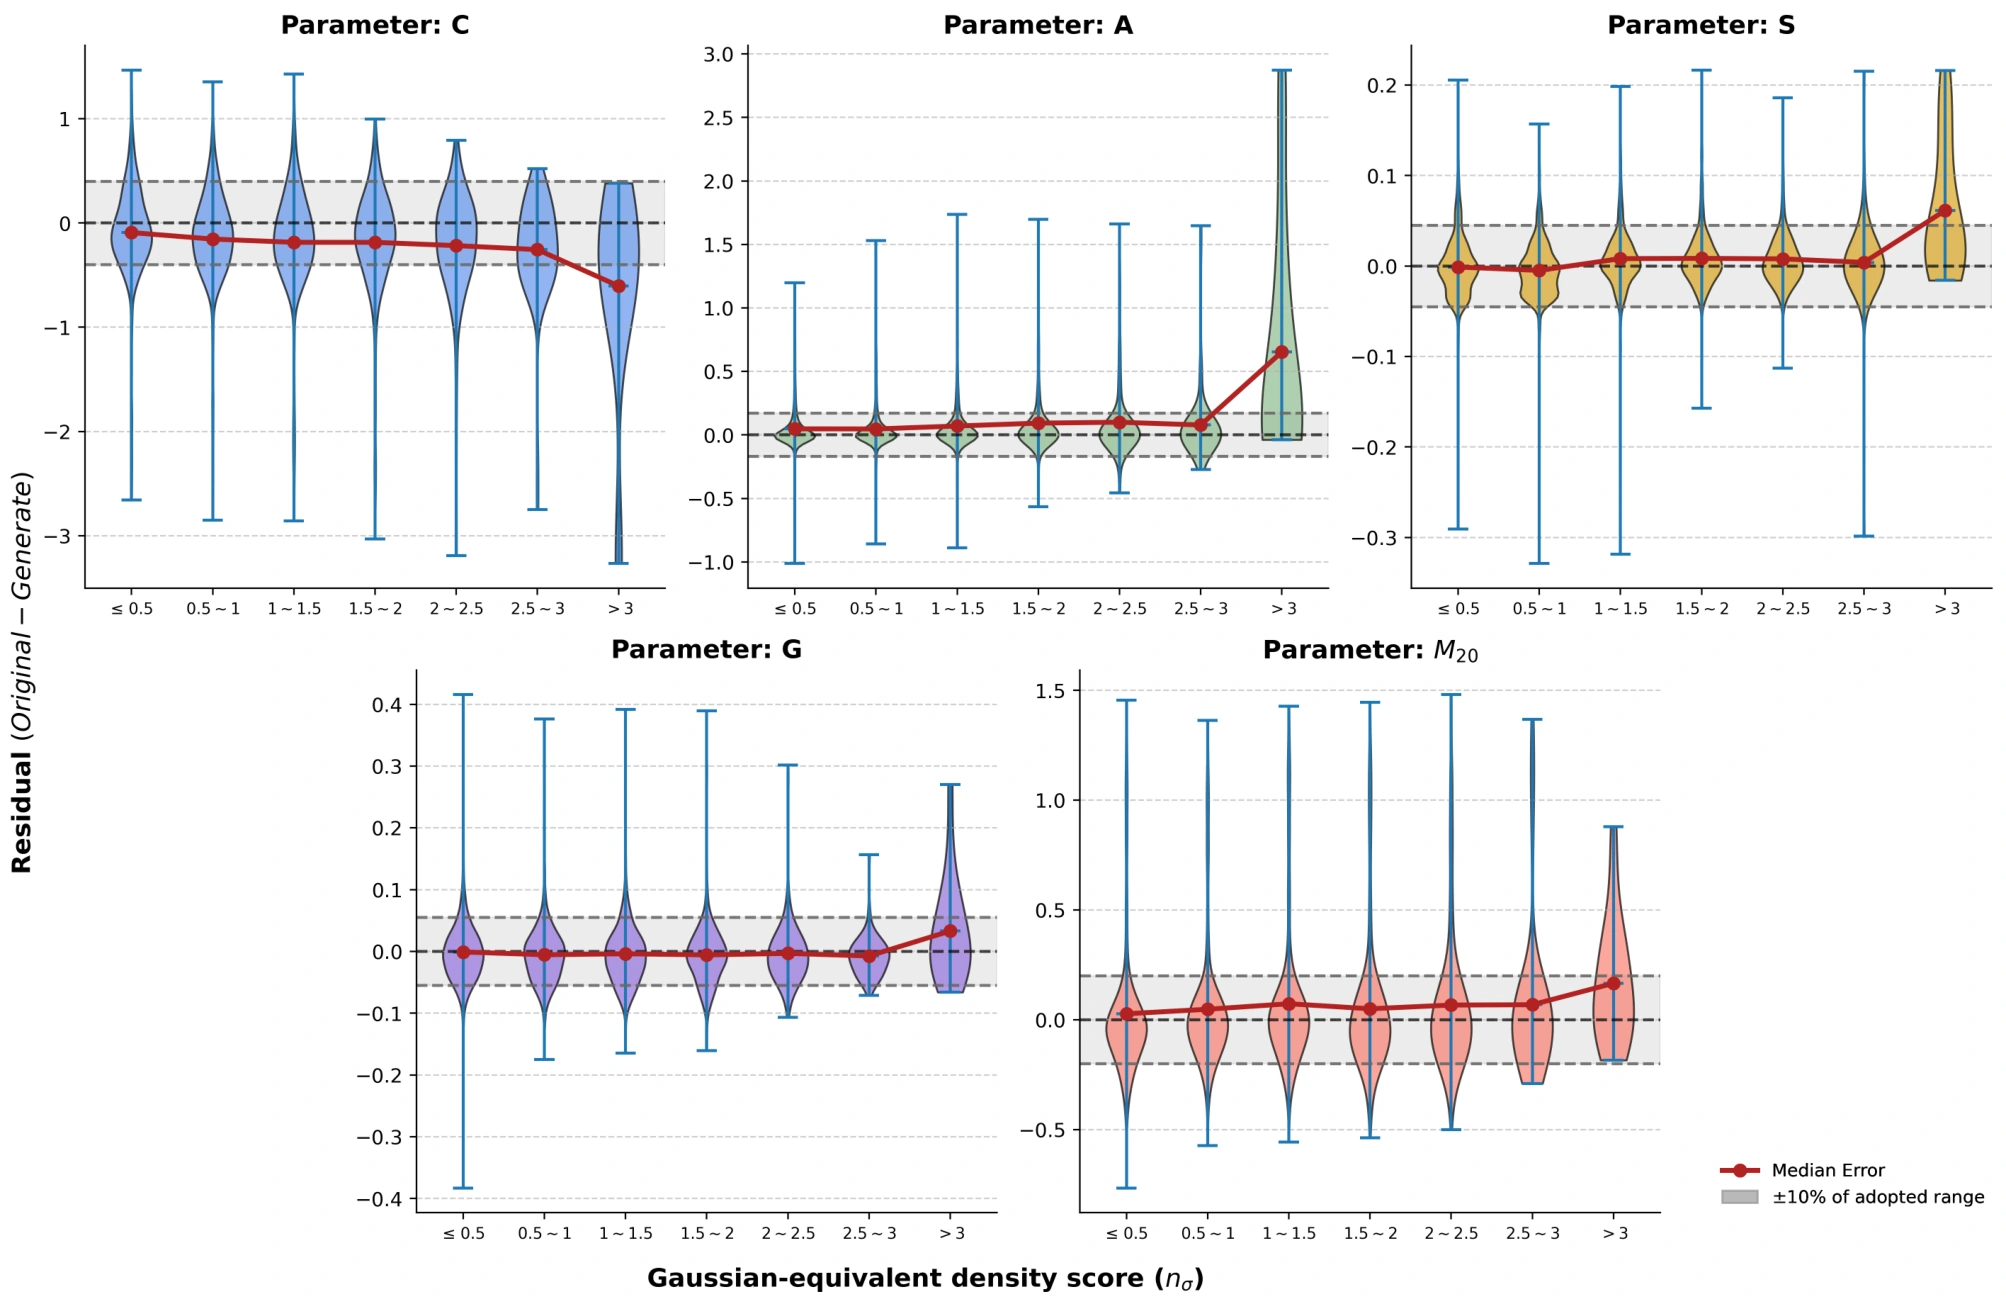
低支持条件下误差总体展宽,并出现系统偏移。即使各分量都没有超出训练区间,生成仍会偏向常见组合。
作者也检查了不参与条件输入的结构量。图 8 中真实与生成样本的半光半径、单 Sérsic 指数及模型分解的
证据评价与复现条件
对“在选定低红移样本和原测量分辨率下,模型可以控制常见形态描述量”的结论,本文给出中等偏高可信度:有独立测试图像、重新测量、恒定预测基线和联合支持度实验。对罕见联合形态的可靠控制,则仅有有限证据。本研究没有证明生成图像是真实无噪声亮度场,也没有验证特定旋臂、棒或潮汐结构的正确性。
观测条件是主要迁移边界。模型直接学习观测图像及其统计量,生成后测量前没有另加天空背景或噪声;像素重建损失也没有逆方差权重。PSF 平滑、背景、红移对应的物理尺度,以及固定小视场带来的截断,都可能进入学到的“形态”。这意味着不能直接将输出当作去卷积的内禀星系,再任意叠加另一套 PSF 与噪声而不检查重复计算观测效应。跨波段、高红移或更深巡天的使用都需要代表性数据验证。
代码核验日期为 2026-11-18。论文 Data Availability Statement 明确链接的作者仓库当时可访问,包含 conv_vae.py、train_flow_vae.py、多种训练入口、数据处理 notebook 和预测脚本;所读训练文件确实构造条件高斯基础分布与自回归流,并执行联合优化。
不过,仓库 README 主要介绍三波段、三个条件变量的较早实验;所读联合训练文件的默认值为 60 维潜变量、3 个条件、3 个通道、200 轮,与论文采用的 40 维、五个形态条件、单波段、100 轮不同。这些差异不证明代码不能配置为本文模型,却说明不能直接运行默认命令就声称复现了表 3。当前材料尚未把论文对应的数据清单、完整配置、GMM 补全及评分组件和权重版本逐一对应起来。附录生成示例也应作为方法示意核对,不能替代可执行的完整复现包。
阅读路线:先看第 2 节和表 2,确定生成总体;再看第 3.2–3.4 节及图 3,区分潜变量变换和条件补全;结果部分优先读表 3、图 6、图 7。最后阅读第 5 节和附录 A、B,明确观测分辨率、条件支持与代码接口的边界。
审稿人视角:最大问题与研究启发
最大的一个问题
对稀有联合条件的控制能力仍不足,而这正是用生成器构建少见形态样本时最关键的要求。第 4.2.2 节已经展示:各分量都在训练范围内的轻微扰动,也会造成联合密度下降、误差展宽和向常见组合回归;低支持区仅 22.5% 的有效输出同时满足五个描述量的宽容差。
这比普通平均重建误差更影响实际用途。若用生成样本研究罕见不对称对象、异常结构或形态选择效应,生成器把请求拉回常见区域,会改变本来希望检验的样本分布。高单参数恢复率和总体结构分布相似,都不能替代这项联合控制要求。
作者已明确承认回归中心与稀少条件性能下降,并提供 GMM 分数提示支持不足。这是有用的诊断,但它不会修正输出,也不能证明低密度条件在物理上不可行。因此,这项限制主要缩小了可靠使用范围,并不否定典型条件下的生成结果。
最小验证应针对预先定义的稀有联合条件分层,保留独立真实样本作参照,报告五个条件同时满足的比例、测量失败比例和条件偏差;再比较原训练与稀有条件重采样训练。只有确认联合偏差被降低,才适合把生成样本用于相应的稀有总体分析。
研究启发与可执行验证
可控生成需要检查“给定条件后是否正确”,而不只是生成总体是否像原数据。对其他天文图像生成任务,可复用三项检查:用相同且固定的观测测量程序重测输出;同时报告各参数和全部参数的成功率;按联合支持度分层,而非仅确认每个输入在最小值与最大值之间。
迁移前还应固定或显式建模 PSF、噪声和像素尺度,避免把观测条件变化误认为形态变化。稀有条件重采样会增加训练方差,也可能放大背景修正和标签噪声;这种代价需要通过重复训练及测量扰动实验评估。以上是面向新研究的验证建议,论文尚未证明其在其他巡天中有效。
四、跨论文结论与行动建议
两篇的共同价值在于把科学上可解释的量带回网络验证中,但它们的误差来源不同。TDSM 的局部响应由理论大气模型提供,可靠性取决于理论近似和真实谱标定;Flow-VAE 的条件来自观测统计,可靠性取决于测量流程与联合训练支持。一个更接近物理参数反演,一个更接近观测图像分布模拟,不能用同一种“生成得像不像”指标判断。
| 比较维度 | TDSM | Flow-VAE |
|---|---|---|
| 主要可复用思想 | 对前向模型加入参数响应监督,再验证逆问题结果 | 在潜空间做条件密度建模,生成后重新测量条件 |
| 证据最扎实处 | 理论谱插值、大规模实际应用与分层重复观测 | 常见条件下的描述量恢复,以及条件支持下降时的失败分析 |
| 最重要的单一问题 | 导数监督对最终反演的独立增益没有被隔离 | 稀有联合条件仍明显回归到常见组合 |
| 复现成本 | 理论谱和差分谱生成、数值拟合、外部标定;训练实现仍待核实 | 单卡训练规模可知,但论文配置与公开代码对应尚需补齐 |
- 优先精读 TDSM 的方法与误差检验。先复现一个小型“仅通量/通量加导数”的同条件对照,使用未参与梯度训练的参数点验证。若没有清晰反演收益,不宜仅凭梯度拟合漂亮就扩大理论计算。
- 将 Flow-VAE 作为可控形态模拟的方法储备。最先尝试的不是扩展到新巡天,而是在同一观测域建立联合条件分层评估,明确何处能用、何处会向均值回归。
- 先补齐一项复现材料,再启动大实验。TDSM 需要明确训练实现与目录版本;Flow-VAE 需要确认五条件、单波段模型的准确配置及对应 GMM 和权重。两者都不应从仓库默认命令或论文片段推断完整可复现性。
目前不宜据此断言:导数监督已被证明优于所有同容量通量模型;全部 LAMOST 温区的丰度都同样准确;或 Flow-VAE 已能按任意形态条件产生可信的内禀星系。两篇最大的限制都不妨碍阅读,但应直接决定先做哪一个最小验证实验。
本报告由 GPT 6.1Sol XHigh 整理分析,博客作者对分析内容不负责且不代表博客作者本人的想法。