一、本期总体分析
arXiv 论文时间范围:[2026-11-16 05:00:00, 2026-11-17 05:00:00)(Asia/Singapore) 各分类篇数:astro-ph 145、cs.CV 140、cs.LG 291、cs.AI 276、stat.ML 50(含跨类,分类间可能重复) 入选篇数:2
两篇论文都从模拟中学习可观测星系与暗物质结构的联系,再把这种联系用于新的数据域。第一篇以 HST 多波段图像和红移为输入,用 U-Net 预测星系团的投影总质量,进一步识别子结构。第二篇沿相反方向,从纯暗物质模拟的暗晕属性预测星系恒星质量的概率分布,扩充大体积星系目录。前者关注空间结构的恢复,后者关注总体分布及聚类统计的保持。
第一篇已有真实 HST 数据与独立模拟套件的应用,适合优先精读其数据构建、多波段融合和跨模拟检验,预计投入 45–60 分钟。它最需要补强的是细尺度质量结构的独立验证。第二篇适合作为概率预测和目标域验证设计的方法储备,预计投入 35–50 分钟。它对同一模拟物理设定内的目录扩充给出了多种统计检验,跨宇宙学参数的适用性仍待验证。两篇都应把“复现模拟中的关系”与“约束真实宇宙中的关系”分别评价。
二、入选论文概览
| 阅读优先级 | 英文标题 | 论文类型 | 核心贡献 | 数据或基准 | 代码状态 | 适用研究场景 | 一句话判断 | arXiv 链接 |
|---|---|---|---|---|---|---|---|---|
| 1 | Precise Deep-Learning Reconstruction of Galaxy Cluster Mass Maps and Substructures from Optical Observations | 天文交叉 | 红移条件化多编码器 U-Net,将模拟训练的质量映射应用于真实星系团 | The300、42 个 TNG-Cluster 星系团、21 个 CLASH 星系团 | 官方仓库含推理代码、归一化文件及权重指针,完整训练复现尚未确认 | 多波段图像回归、模拟到观测迁移、星系团子结构 | 图像到质量图的流程值得精读,新增细结构的物理真实性仍需独立检验 | 2611.18487v1 |
| 2 | Augmenting Galaxy Catalogues using Machine Learning in the FLAMINGO Simulations | 天文交叉 | 分箱概率树模型与面向纯暗物质域的特征选择,保持恒星质量散布和聚类 | FLAMINGO L1_m8、配对 DMO、2.8 cGpc FLAMINGO-10k | 本研究公开训练仓库未见,训练模型须联系作者 | 概率目录、星系—暗晕关系、模拟域偏移 | 目标域统计应参与模型选择,跨物理参数的迁移仍是主要边界 | 2611.17425v1 |
三、逐篇深度分析
1. 从 HST 光学图像预测星系团总质量与子结构
Precise Deep-Learning Reconstruction of Galaxy Cluster Mass Maps and Substructures from Optical Observations,作者为 Atulit Srivastava、Weiguang Cui、Daniel de Andres、Guillaume Bonnet、Romeel Davé、Stefano Ettori、Massimo Meneghetti、Carlo Giocoli、Gustavo Yepes。arXiv 版本为 2611.18487v1,首次提交于 2026 年 11 月 13 日 18:00:06 UTC,本次分析对应 v1。主分类为 astro-ph.CO,另列 astro-ph.IM。论文将星系团的光学发光分布映射为包含暗物质与重子的投影总质量图,适用于研究多波段图像回归、条件建模及模拟到真实观测的迁移。官方摘要页、HTML 全文、PDF
这篇值得精读的部分,是作者如何把模拟粒子变成接近真实 HST 数据的训练输入,以及如何检查图像回归结果能否支持后续天文统计。对模拟中总质量分布的重建已有直接真值检验,真实星系团中额外出现的细尺度结构需要更谨慎地解释。
科学目标、模拟与真实样本
星系团总质量主要由不可直接发光的暗物质贡献。强弱引力透镜可以约束投影质量,但质量模型的参数化与平滑处理会影响小尺度结构。本文学习模拟中恒星发光场与总质量场的关系,希望在缺少高质量剪切或多重像信息时,也能从光学图像得到质量代理,并研究子晕的空间分布和质量函数。输出包含气体、恒星、暗物质及黑洞的总质量,单独的暗物质图需要额外成分分解。
训练数据来自 The Three Hundred 项目的 Gizmo-Simba 重模拟。其母体为 MDPL2 中的大质量星系团区域,本文选出与 CLASH 质量、红移范围相近的 3,273 个暗晕,要求高分辨率粒子质量占比超过 0.99,红移覆盖
每个暗晕旋转生成 30 个视线方向。它们增加了投影多样性,统计上仍共享相同的三维对象。真实数据来自 HST 的 CLASH 计划,原计划含 25 个星系团,本文保留其中 21 个,其中五个有 CLASH-VLT 光谱成员目录,另外 16 个主要依赖 BPZ 测光红移。用于图像输入的五个 ACS/WFC 滤光片为 F606W、F625W、F775W、F814W、F850LP,覆盖可见光至近红端,具体响应曲线参与模拟合成,正文未列出各滤光片的数值波长边界。研究对象为单个星系团周围
从模拟粒子到可比较的图像
作者用 PyMGal 和 EzGal,根据恒星粒子的年龄、金属丰度和质量赋予恒星族光谱,采用 Bruzual–Charlot 恒星族模型与 Chabrier 初始质量函数,再通过五个 HST 滤光片合成观测者参考系的光度图。输入光度与目标质量沿相同视线、相同深度
仪器处理包括各滤光片 PSF 卷积,以及来自真实 CLASH 空白天空的相关背景噪声。作者先掩去天空小块中的残余源,进行均值扣除并建立噪声模板,再经物理单位转换,用 GalSim 为不同模拟图像生成噪声实现。所有输入和质量图最终守恒降采样到
附录 A 的式(5)将透镜会聚图乘临界面密度和像素面积,转换为每像素质量后比较。网络输出与透镜图的单位及像素物理面积需要保持一致,才能进一步计算面密度剖面。
真实图像也要经过成员筛选、污染源替换和光度单位转换。五个有光谱目录的星系团采用相对团红移的速度差不超过
训练和观测间还存在投影深度差异。模拟图像只积分到
网络、条件变量与训练
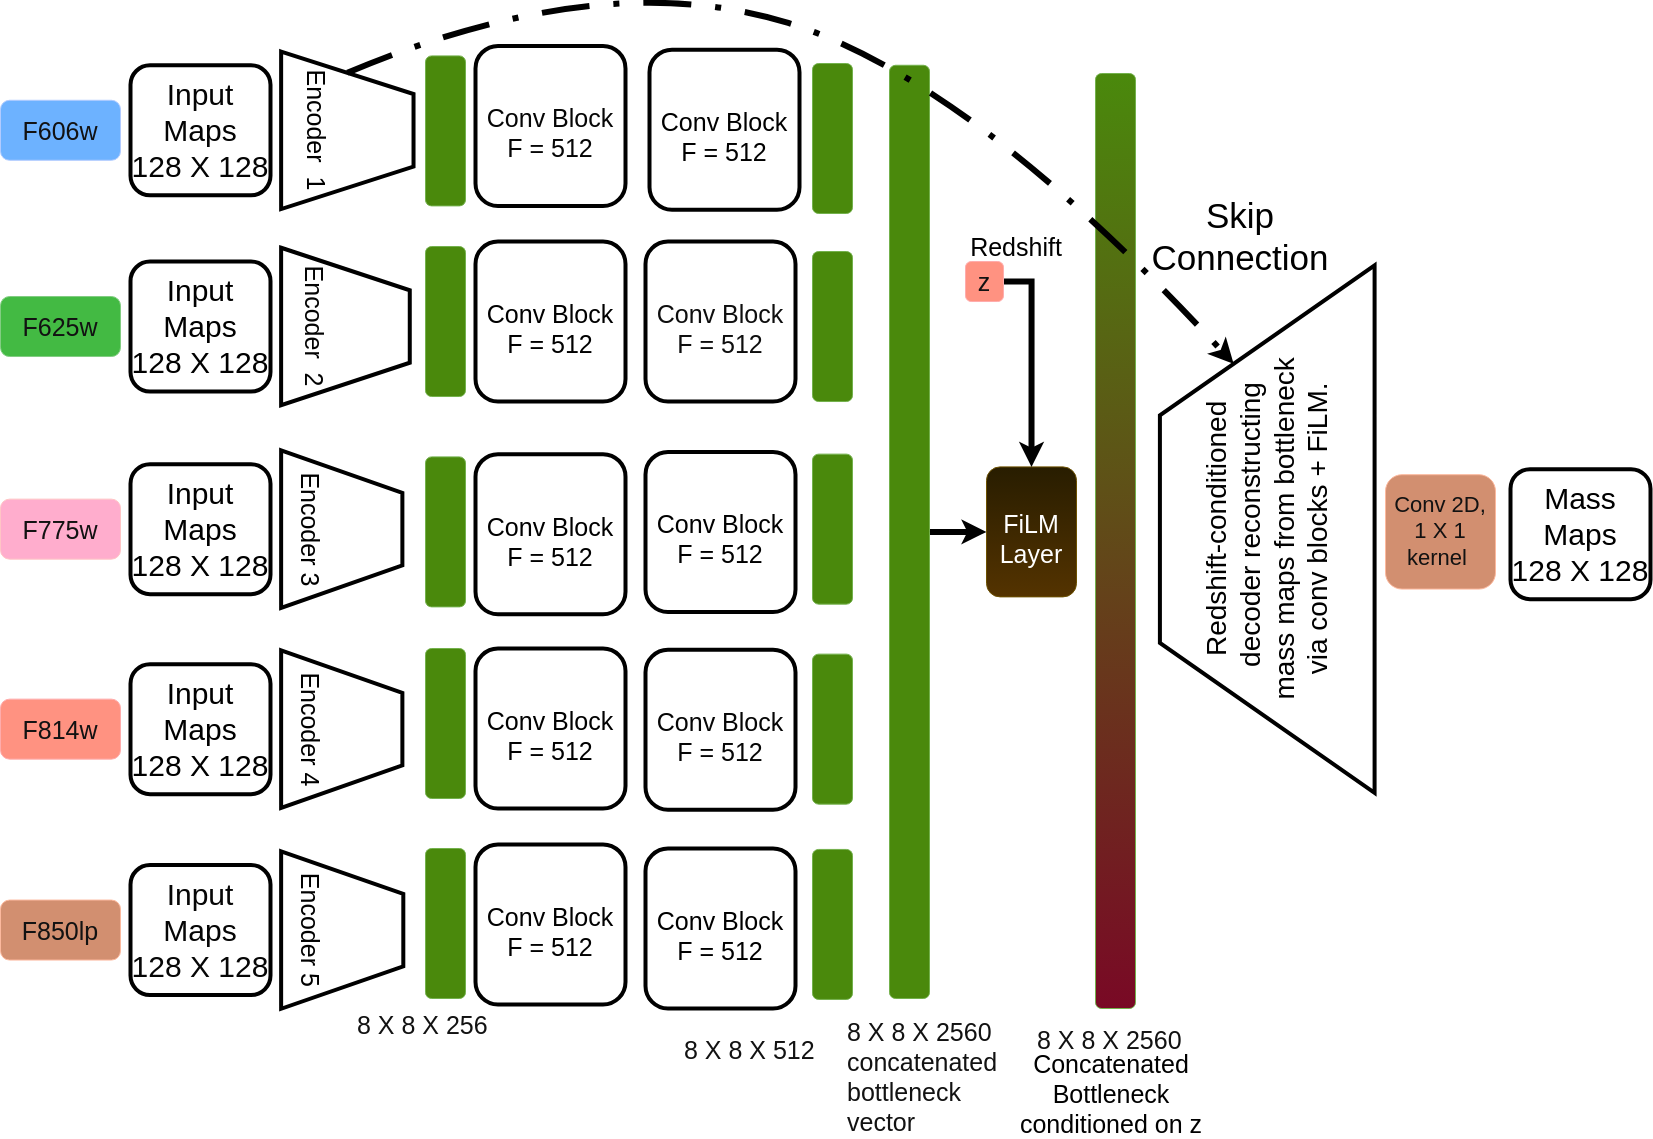
作者比较五个单滤光片 U-Net、一个五通道早期融合 U-Net,以及一个五分支多编码器 U-Net。单通道网络从
多编码器方案让各滤光片先独立提取特征,在瓶颈处拼接,再由共享解码器生成质量图。图 5 中五路
红移通过一个两层全连接网络生成逐通道尺度与偏置,在瓶颈和各解码阶段进行 FiLM 调制。
作者明确提出,光学发光场与质量场的关系会随红移变化,所以红移需要参与特征变换。本文没有给出保持其他设置相同的无 FiLM 消融,因而目前能够确认整个条件化模型有效,FiLM 的独立贡献仍待测量。第 4 节与图 3–5
输入光度采用论文式(2)的分段对数变换,分别处理正、负和零像素,质量采用对数变换,再使用训练集均值与标准差标准化。目标是在标准化对数质量空间最小化每图 MAE,推理时反变换回质量。训练采用 Adam、初始学习率
结果分别支持了什么
| 评价范围 | 可核实结果 | 解读边界 |
|---|---|---|
| The300 测试集 | 图 8 中不同模型的像素相对残差一倍标准差约为 19%–24% | 这是跨像素与对象的残差统计,各模型并未输出对应的后验区间 |
| 模型比较 | 图 7 中多编码器对径向剖面和功率谱的总体恢复最好 | 核心区和小尺度仍有偏差,高质量端还出现向均值回归 |
| 跨模拟检验 | 42 个未参与训练的 TNG-Cluster 对象,像素残差散布约 19%–22% | 附录 B 仍见中心剖面偏差及高频功率下降 |
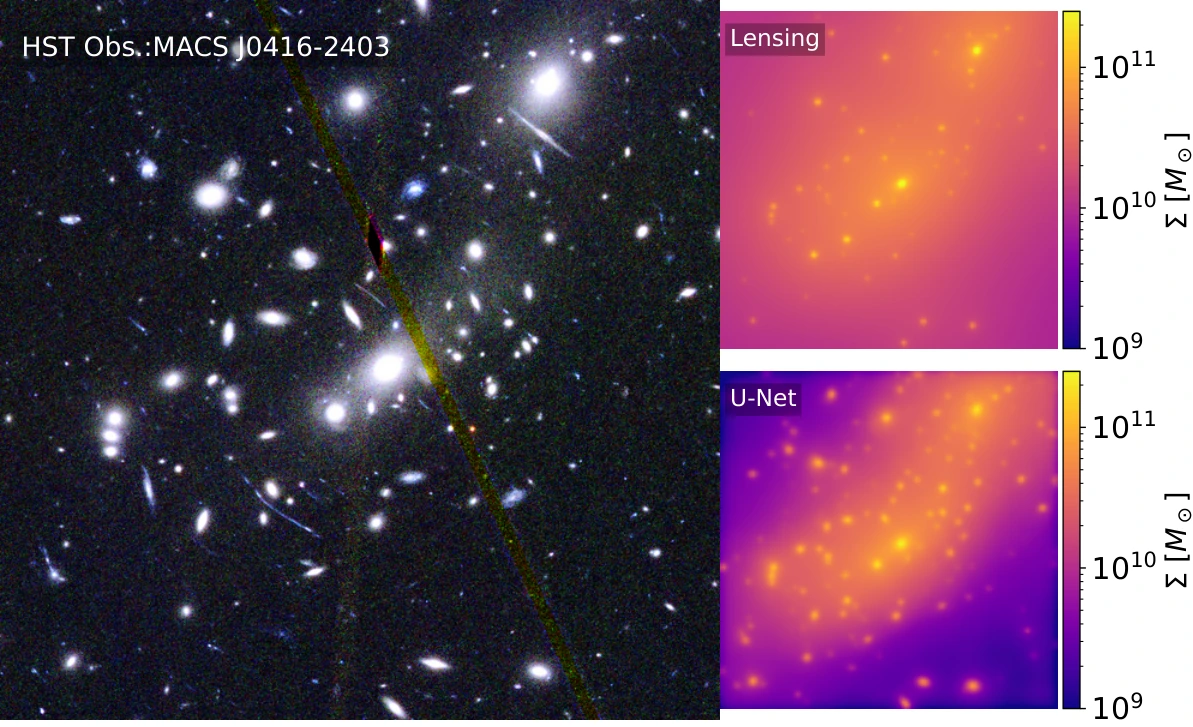
| 真实 CLASH | 21 个星系团的整体形态、部分径向剖面与透镜估计接近 | 不同星系团和半径上的偏差明显,比较模型采用 LTM 假设 |
| 子结构统计 | 五个有光谱目录的星系团,微分子晕质量函数平均对数斜率约为 | 该标准差描述团间差异,不能直接作为单个子晕质量的不确定度 |
The300 的区域级测试划分与 TNG 的跨模拟检验共同支持了整体形态和中、大尺度质量关联的迁移。它们也显示核心区和精细结构更依赖模拟物理。真实数据中,作者第 6 节指出 U-Net 与透镜图的功率谱、外侧径向剖面并非处处一致。该节还有将较大波长与高空间频率联系起来的措辞混用,解读尺度应依据
作者还用 Chandra X 射线分析补充质量剖面对照。JACO 在静水平衡假设下估计三维质量剖面,再经球对称投影转换,并采用统一约 20% 的静水平衡质量偏差修正。它提供了不同物理手段下的径向比较,无法定位和检验每个局部质量峰。第 6 节
后续子晕统计还依赖一个额外的测量流程。作者先去除平滑背景,在六个高斯平滑尺度上检查局部峰是否持续存在,再用局部信噪比筛选,最后根据峰对比度和最近邻距离给每个峰分配自适应孔径。孔径与探测阈值均用 The300 的 AHF 目录校准,其中孔径参数直接以累计及微分质量函数的一致性为优化目标。
附录 D 报告,全样本峰检测的中位召回率为
复现条件与证据评价
2026 年 11 月 17 日核查了正文链接的官方仓库。UNET-Models/Prediction_Maker.py 确有单波段、五通道、多编码器三种推理函数,读取各模型归一化统计,以光度及红移生成质量图。仓库还提供结果资料和模型文件条目。但已读取的多编码器 .h5 内容是 Git LFS 指针,指向约 1.10 GB 的权重实体,本次没有下载该实体或执行推理。所查目录与 README 未见完整训练入口、固定依赖和端到端数据准备说明。现有材料支持检查输入归一化和调用路径,完整重训复现仍需作者补充或进一步核验。官方仓库、已核查推理文件
整体证据可信度为中。模拟测试对总体质量映射的支持较强,真实数据上则更适合把结果用作有模拟先验的质量代理。模型没有给出像素级概率分布、预测区间覆盖率或域外拒识机制。恒星族、重子反馈、成员掩膜和沿视线深度的系统差异,仍会进入最终质量估计。作者在第 7 节明确承认这些域偏移来源,并提出更换模拟、投影深度和域适应作为后续方向。
审稿人视角:最大问题与研究启发
最大的一个问题
真实星系团中新增细尺度质量结构的验证,尚缺少充分独立于发光分布和 The300 校准的约束。
附录 A 明确说明,选择 LTM 透镜图作为比较对象,是因为其光追踪质量假设与本方法接近。附录 D 的孔径与峰检测又以 The300 子晕目录及质量函数为校准目标。因此,真实图的形态接近 LTM、质量函数斜率接近模拟,仍可能部分体现共同先验与测量流程的影响。TNG 测试已经缓解总体质量映射的域偏移疑问,但没有直接证明真实图中每一个额外峰对应正确的暗物质子结构。
这个问题最影响论文关于低质量子结构和真实子晕质量函数的科学解释。它对模拟中图像回归有效性的影响较小,对“更多峰代表更真实的子晕恢复”的影响较大。作者已承认模拟到观测的系统误差,尚未给出足以独立检验这些额外峰的观测对照。
最关键的补充实验,是固定训练、孔径与检测参数,用独立保留的强透镜多重像约束检验额外结构是否改善透镜可观测量的预测。对照应保持整体质量剖面一致,比较包含和移除这些局部结构后的预测误差,并使用尽量弱化光追踪质量假设的质量模型。这样可以直接检验额外结构是否获得独立数据支持。
研究启发与可执行验证
图像恢复任务应把像素重建能力和后续科学量的有效性分别验证。迁移到其他天文图像问题时,可以先按模拟区域、天体或观测场区分组,再在完全保留的域上检查空间尺度相关残差与科学量偏差。若后处理经过模拟校准,还应单独测量它对总体统计的影响。
本文的多波段独立编码与红移 FiLM 也值得作为迁移分析中的设计候选。一个最小实验是固定数据划分和训练预算,比较五通道早期融合、多编码器、移除红移调制三种配置,在各红移与信噪比区间同时测量质量偏差和功率谱误差。需要尽量匹配参数量或报告成本差别,额外分支会增加显存和训练需求,现有论文尚未提供可直接照用的成本基准。
阅读时优先看第 2–4 节的数据流、图 5 与图 7–8,再把附录 A 的 LTM 比较条件、附录 B 的 TNG 测试和附录 D 的子晕测量一起阅读。第 6 节的科学结论应放在这些校准条件下判断。
2. 用面向目标域的概率树模型扩充 FLAMINGO 星系目录
Augmenting Galaxy Catalogues using Machine Learning in the FLAMINGO Simulations,作者为 Elliot Scott、Marika Asgari、Joop Schaye、Matthieu Schaller、Markus Michael Rau。arXiv 版本为 2611.17425v1,首次提交于 2026 年 11 月 12 日 19:00:12 UTC,本次分析对应 v1。分类为 astro-ph.CO。研究关注暗晕属性到星系恒星质量分布的映射,适用于大体积模拟目录扩充、概率预测和星系聚类研究。官方摘要页、HTML 全文、PDF
最值得精读的设计,是作者直接用纯暗物质目标域中的统计表现选择超参数和特征。对于训练域中很有预测力、目标域中却发生物理偏移的变量,这种验证能够发现其负面作用。论文还用离散概率分布保持恒星质量的散布,避免只输出条件均值所造成的总体分布收缩。
数据来自配对模拟
该论文不使用巡天数据作为机器学习输入。主要数据来自 FLAMINGO 的高分辨率流体模拟 L1_m8、相同初始条件与随机种子的纯暗物质配对模拟 L1_m8_DMO,以及用于目录扩充的 FLAMINGO-10k。前两者盒长为 1 cGpc,后者为 2.8 cGpc,两个 DMO 运行的暗物质粒子质量均为
暗晕与子晕由 HBT-HERONS 跟踪,属性通过 SOAP 计算。输入除当前束缚暗物质质量,还包括不同孔径内质量、速度、半质量半径、形成红移及历史最大圆周速度等,历史特征需要读入此前快照。最终模型训练和评价位于
作者剔除暗物质粒子数少于 100 的暗晕,因为部分属性在该分辨率下不能可靠计算。图 1 显示,这也损失低恒星质量对象,在约
流体模拟按 75% 和 25% 划分训练、测试,再留出训练部分的 10% 作为验证,即总样本的 7.5%。DMO 数据另留出 10% 用于目标域超参数验证。文中没有给出这些筛选后中央与卫星样本的明确总数,也未明确说明是否按空间区域或共同宿主分组,因此共享环境造成的数据相关性还不能定量评价。中央暗晕可以利用粒子 ID 在流体与 DMO 运行之间匹配,卫星子晕缺少这种可靠匹配,这决定了两类对象采用不同训练办法。第 3.1 节
从标量回归改为恒星质量概率分布
若用均方误差训练标量回归器,它倾向于输出给定暗晕属性下的平均恒星质量。逐个采纳这样的输出会压缩星系分布的散布,进而改变按恒星质量选择的样本和相关统计。作者将
这里
树模型有两层优化。树内部按分类纯度进行划分,外层高斯过程优化树数、深度、质量箱数和训练数据比例等超参数。外层目标
中央模型的关键是直接用匹配 DMO 暗晕的输入属性与对应流体星系的恒星质量训练,从源头对齐输入域。卫星模型仍用流体模拟训练,但把 23 个特征的保留与否也作为二元超参数,让目标 DMO 验证域决定哪些变量可迁移。连同六个常规超参数,共优化 29 个量。
这一步有清楚的物理动机。重子反馈会改变暗晕内区,10 kpc 内的质量虽然与恒星质量高度相关,其流体与 DMO 分布却显著不同。模型若依赖这样的变量,训练域内可以表现很好,应用到 DMO 后就会产生系统偏差。最终卫星模型保留当前暗物质质量、历史最大暗物质质量、1000 与 3000 kpc 内暗物质质量、暗物质质心速度和宿主质量,共六个变量。第 3.2 节、图 3 与表 3
卫星输入还要处理 DMO 粒子质量包含原重子质量份额的差别。作者对相关质量和角动量变量乘 0.84,对圆周速度变量乘约 0.92。这个比例来自两种粒子质量的换算,不能消除重子反馈对内部结构的影响。中央模型直接以 DMO 属性训练,因此不采用这项卫星输入修正。
训练配方、结果与消融
| 项目 | 中央模型 | 卫星模型 |
|---|---|---|
| 最终树数 | 775 | 4,223 |
| 恒星质量箱数 | 222 | 770 |
| 表 3 所列数据比例 | 0.505 | 0.512 |
| 高斯过程搜索 | 128 个初始点,再评价 824 点 | 1,024 个初始点,再评价 1,023 点,随后检查特征翻转 |
| 目标域处理 | 匹配 DMO 输入与流体标签 | 流体训练、DMO 统计验证及特征选择 |
最终训练还采用表中数据比例的 80%,以对应搜索时的留出办法。搜索中若模型内存超过 100 GB,目标函数给予强惩罚,这表明大规模分类树的存储成本也参与设计。论文未报告可直接比较的完整训练耗时、推理吞吐或最终模型内存,不宜仅从算法名称判断资源需求。
复现时需要先澄清表 3 的内部不一致。表中最大深度搜索上限写为 50,卫星最优值却是 72,恒星质量箱数上限写为 500,卫星最优值却是 770。附录的其他表使用了更大的范围,但不能据此自行替换主模型的搜索配置。这些冲突影响对搜索配方的精确重建。
最有说明力的对照是 HYDRO-opt。它只用流体数据和全部特征训练,再应用于 DMO。图 4 中,它在
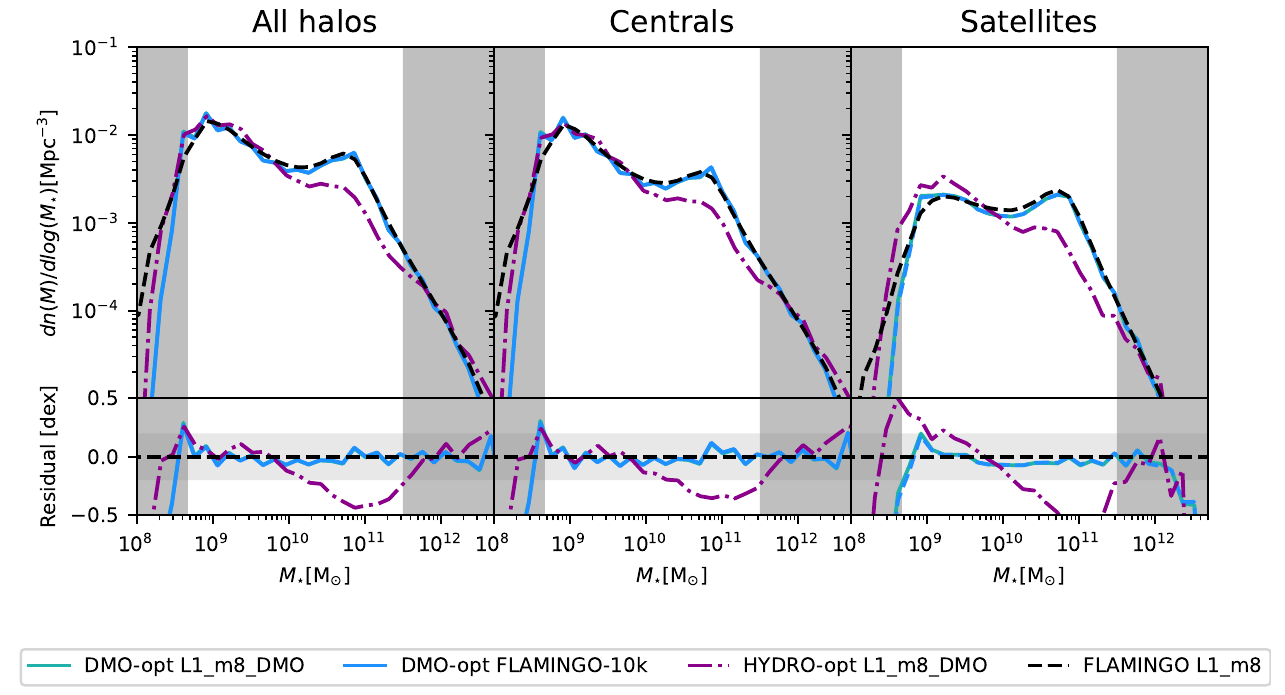
其他统计检验提供了互补证据。图 5 在
图 7 进一步检查恒星质量残差与环境质量、浓度、半质量半径等属性的相关性,多数关系得到较好保持,历史最大圆周速度仍有偏差。图 8 从预测概率中抽样目录,在四个恒星质量箱中计算 1–100 Mpc、20 个距离箱的三维二点相关函数,多数尺度残差小于 0.1 dex。这里尚未检验小于 1 Mpc 的聚类,也未报告与真实巡天选择、红移空间效应或观测投影完全对应的端到端比较。图 5–8 与第 4 节
附录 B 用相同超参数的分类与回归模型比较恒星质量分布,发现回归结果更集中在分布主峰、对尾部的恢复更差。这个对照支持保留概率输出的动机。附录 C 还显示,树数与质量箱数需要一起选择,增加分箱精度而不给足概率分辨率,会影响分位数的稳定性。各项结果支持同一模拟物理设定内的目录扩充,尚未给出不同宇宙学之间的误差响应测试。
复现条件与证据评价
作者第 2 节说明基础 FLAMINGO 模拟数据已发布,结论部分则将本研究新增的 FLAMINGO-10k 星系目录描述为计划随论文发表纳入数据发布,训练模型可联系作者索取。正文及附录没有给出本研究公开训练代码的仓库地址。方法使用 scikit-learn 与 scikit-optimize,训练、插值、特征构建和目录抽样的精确实现仍需额外材料。不能把基础模拟公开等同于本研究整条流水线已经可复现。第 5 节
整体证据可信度为中。质量函数、条件分位数、属性相关性与二点聚类共同支持模型在同一物理设定内扩充目录的能力。与只看单一回归误差相比,这些检验更贴近目录的科学用途。不过,统计符合目标流体模拟,仍继承该模拟的反馈、恒星质量定义和观测校准。本文的概率分布也没有单独给出逐对象校准检验或跨物理设定的覆盖率保证。
审稿人视角:最大问题与研究启发
最大的一个问题
模型对宇宙学与反馈参数变化的响应尚未验证,因而其用于宇宙学聚类推断的适用范围仍不清楚。
表 1 中的训练、配对测试和 2.8 cGpc 应用都采用 D3A 设定。扩大模拟体积检验了同一关系在更多对象上的应用,却没有测量改变宇宙学或反馈后,恒星质量选择与二点聚类如何响应。第 5 节也将中分辨率、不同宇宙学运行上的测试列为未来工作。
这比单个质量区间中较大的残差更影响宇宙学用途。参数推断需要前向模型在参数变化时给出可靠的统计响应,即使基准参数处的质量函数与聚类接近真值,也不能据此判断参数导数是否正确。当前结果仍支持基准设定下的目录扩充,跨设定应用需要额外检验。作者已经承认这一扩展方向,现有实验尚未覆盖它。
最小而直接的补充,是固定 D3A 训练模型,应用于另一个具有配对流体真值的宇宙学或反馈运行,不重新调参,并比较恒星质量选择后的二点相关函数变化。报告相对基准的统计差值能否恢复,以及误差是否足以偏移目标参数,比只重复展示另一条质量函数更能回答这个问题。
研究启发与可执行验证
模型选择应面向最终部署域和最终科学统计。对于难以逐对象配对的模拟迁移,可以把目标域中可获得的总体统计纳入验证,同时保留完全未参与调参的物理设定,检查条件分布和空间统计是否一起保持。
一项可执行的迁移分析是,将特征选择目标从单一预测分数扩展为按质量、环境或红移分组的分布偏差,记录每个特征在源域和目标域中的漂移,再比较保留与移除该变量的结果。前提是目标域有可信的验证统计,代价是需要更多配对模拟或外部约束。若目标统计本身有系统误差,优化也会继承这些偏差。
阅读顺序建议为图 3–4、第 3.2 节的目标函数和中央/卫星两条路径,再看图 5–8,最后核对附录 B–C 的概率输出与量化误差。对图 8 的解读要始终保留其 1–100 Mpc、同一宇宙学与三维相关函数的条件。
四、跨论文结论与行动建议
第一篇可优先用于理解多波段图像到物理场的完整数据流,第二篇适合借鉴目标域验证与概率目录设计。前者已有可检查的推理路径,但训练资料与权重实体仍需进一步核实。后者的预测器形式较简单,历史特征构建、目标域搜索和作者模型的获取构成主要复现成本。
两篇的最大问题都影响科学解释的范围。质量图论文应先区分整体质量关联与局部结构真实性,再决定是否开展子晕统计。FLAMINGO 论文在基准物理设定内已有较完整的总体统计检查,跨参数用途应等待响应检验。这样的边界不妨碍精读各自的数据处理和验证设计。
可优先开展三项一般研究实验。
- 为图像到物理量任务建立单位、成员选择、PSF 与背景处理的对照表,逐项改变预处理,检查偏差集中在哪些空间尺度和对象子样本。
- 在同一数据与划分上比较条件均值回归和离散概率预测,除点误差外,联合评价分位数、分布尾部、按预测量选样后的总体统计。
- 将域内测试、跨模拟测试和独立观测检验分别保留,固定后处理参数后再测量科学量,避免把后处理校准所保持的统计重复当作泛化证据。
这些建议属于迁移分析。额外质量峰能否提升暗物质约束、概率目录能否保持宇宙学参数响应,都需要相应实验给出结果。两篇预印本目前最值得复用的,是把物理域差异显式放进数据准备与评价流程的做法。
本报告由 GPT 6.1Sol XHigh 整理分析,博客作者对分析内容不负责且不代表博客作者本人的想法。