一、本期总体分析
arXiv 论文时间范围为 [2026-11-15 15:07:04, 2026-11-16 15:07:04)(Asia/Singapore) 各分类篇数为 astro-ph 145、cs.CV 140、cs.LG 291、cs.AI 276、stat.ML 50(含跨类,分类间可能重复) 入选篇数为 2
两篇论文分别处理 Euclid 强引力透镜工作流中的候选排序与建模准备。第一篇固定 ConvNeXt-Base,研究模拟预训练、真实样本微调、困难负例和图像表示怎样改变有限目检预算下的回收量。第二篇把已训练的透镜识别编码器转用于分量分解,再从预测图生成建模中心、区域、共轭像点和污染源掩膜。两者都围绕实际观测数据组织学习目标,技术价值集中在数据与科学任务之间的接口。
第一篇更适合优先精读。其消融揭示了一个会影响模型选择的现象——全局平均精度更高的模型,在高召回区间和固定候选预算下可能表现更差。第二篇适合作为自动化建模的方法储备,尤其值得关注少样本监督的构造、连续分量图的损失,以及输出如何接入物理拟合。第一篇建议投入约 45–60 分钟,第二篇约 35–45 分钟。
证据评价需要沿着各自的测量口径展开。第一篇直接验证了已识别目录中的排序与回收,母体透镜完整性仍依赖额外的选择函数测量。第二篇验证了分割输出对建模流程的可用性,下游质量参数的偏差和区间覆盖仍需专门实验。两篇都值得借鉴其工程设计,科学样本统计和精密参数推断则需要对应的校准。
二、入选论文概览
| 阅读优先级 | 英文标题 | 论文类型 | 核心贡献 | 数据或基准 | 代码状态 | 适用研究场景 | 一句话判断 | arXiv |
|---|---|---|---|---|---|---|---|---|
| 1 | Euclid Data Release 1 (DR1). Enhancing deep-learning models: the impact of image processing and training data selection for strong-lens detection | 天文交叉 | 两阶段训练、困难负例及 VIS/近红外表示的巡天级消融 | Euclid Q1、DR1,约 6700 万 cutout | 完整研究实现与权重未核实 | 稀有天体候选排序、多波段检索 | 应把模型选择落实到高召回区间与目检预算 | 2611.17420v1 |
| 2 | Euclid Data Release 1 (DR1). AstroVink-TREX: Automated strong gravitational lens segmentation as input for mass modelling pipelines | 天文交叉 | 连续分量图及自动建模初始化接口 | 377 个 Q1 系统、750 个 DR1 开发测试系统及约 3000 个专家检查系统 | 完整研究实现与权重未核实 | 强透镜分量分解与批量质量建模 | 建模可用性已获验证,精密测量偏差仍待校准 | 2611.17894v1 |
三、逐篇深度分析
1. Euclid Data Release 1 (DR1). Enhancing deep-learning models: the impact of image processing and training data selection for strong-lens detection
作者为 Euclid Collaboration、M. Fogliardi、P. Holloway、S. Schuldt 等。论文编号为 2611.17420v1,分类为 astro-ph.CO、astro-ph.GA,首次提交于 2026-11-12,本次分析对应首个版本。论文的研究场景是大规模强透镜检索,涉及模拟与真实图像之间的迁移、极端类别不平衡以及多波段模型集成。摘要页、HTML 正文、PDF
值得精读。 最有借鉴价值的是把训练设计与巡天使用方式放在同一个实验框架中。模型在训练集上的判别能力、在高召回区间的排序质量,以及在实际候选预算内找回多少已知透镜,分别回答不同的问题。
科学目标、数据与监督来源
星系尺度强透镜通过弧、环和多重像约束前景星系的质量分布,也为暗物质研究和高红移源的放大观测提供样本。Euclid 最终巡天预计覆盖约 14,000 平方度,作者引用的预期透镜规模约为十万个。论文实际处理的是约 2000 平方度的 DR1,分类器需对约 6700 万个 cutout 排序,之后只有有限数量的对象能够接受目检。少量假阳性率变化在这一规模下就会转化为大量人工工作。正文 §1、§5
观测来自 Euclid VIS 的可见光
初始透镜训练样本以模拟为主。星系团环境的 5011 个模拟透镜由已有质量模型生成,并通过 HST2EUCLID 对 HST CLASH/Frontier Fields 图像实施 PSF 匹配、采样和噪声调整。场透镜来自两套生成流程,其中一套利用观测前景星系和高分辨率背景源,另一套结合 Flagship 与 COSMOS 目录构造质量和源光分布。参考训练配置使用 2585 个 S1 场透镜与 2500 个 S2 场透镜。
负例带有明确的发现历史。XX 类对象通过过往机器学习筛选后,被公民科学检查排除。X 类对象更难辨认,经过公民科学检查仍进入专家检查,最终被判为非透镜。作者另加入衍射尖峰、仪器伪影及类似透镜的星系形态。这样的负例能够覆盖分类器高分尾部常见的混淆对象,负例难度与引入阶段成为后续消融的重要变量。正文 §2.1–2.2
真实正例来自 Q1 和 DR1 中一个约 200 平方度的先行搜索区域。DR1 先行候选经过 14 位专家的分级,并将平均等级重新检查、筛去标签不明确的对象。作者明确指出,将 A、B、C、X 编码后取平均是一种实用汇总,等级间隔具有主观性。因而标签仍包含目检选择和不确定性。
| 数据用途 | 透镜 | 非透镜 | 总数 |
|---|---|---|---|
| Stage 0 模拟驱动预训练 | 10,096 | 11,296 | 21,392 |
| Stage 1 真实数据微调 | 1478 | 4672 | 6150 |
| 两阶段共用验证集 | 127 | 816 | 943 |
以上采用正文表 1 的参考配置。Stage 1 正例包括 953 个先行 DR1 系统和 525 个 Q1 系统。验证集决定训练检查点,最终保留验证 PR-AUC 最好的模型。论文提供了样本来源与数量,但复核训练、验证和完整目录测试之间的对象重叠,仍需要对象级划分清单。正文 §2.3、§3.4,表 1
从像素到透镜分数
模型以 Zoobot-Euclid 的 ConvNeXt-Base 为主干,约有 8750 万个可训练参数。其形态表征先在约 81.4 万个 GZ Evo 星系及约 17.4 万个 GZ Euclid 星系上学习,再进入本研究的透镜训练。1024 维主干特征经过
VIS-only 分支将同一幅 VIS 图像转换成三个输入通道。第一通道把 Sobel 梯度幅值以 0.3 的系数加回图像,再做百分位拉伸,用于突出细弧与边界。第二通道以第 99 百分位作亮度参考,采用参数 0.1 的 arcsinh 拉伸,兼顾暗弱结构与明亮核心。第三通道使用多种裁剪设置的 CLAHE,并混合局部对比度增强结果。三个通道分别提供不同强度区间和空间结构的视角。
Pseudo-RGB 分支把
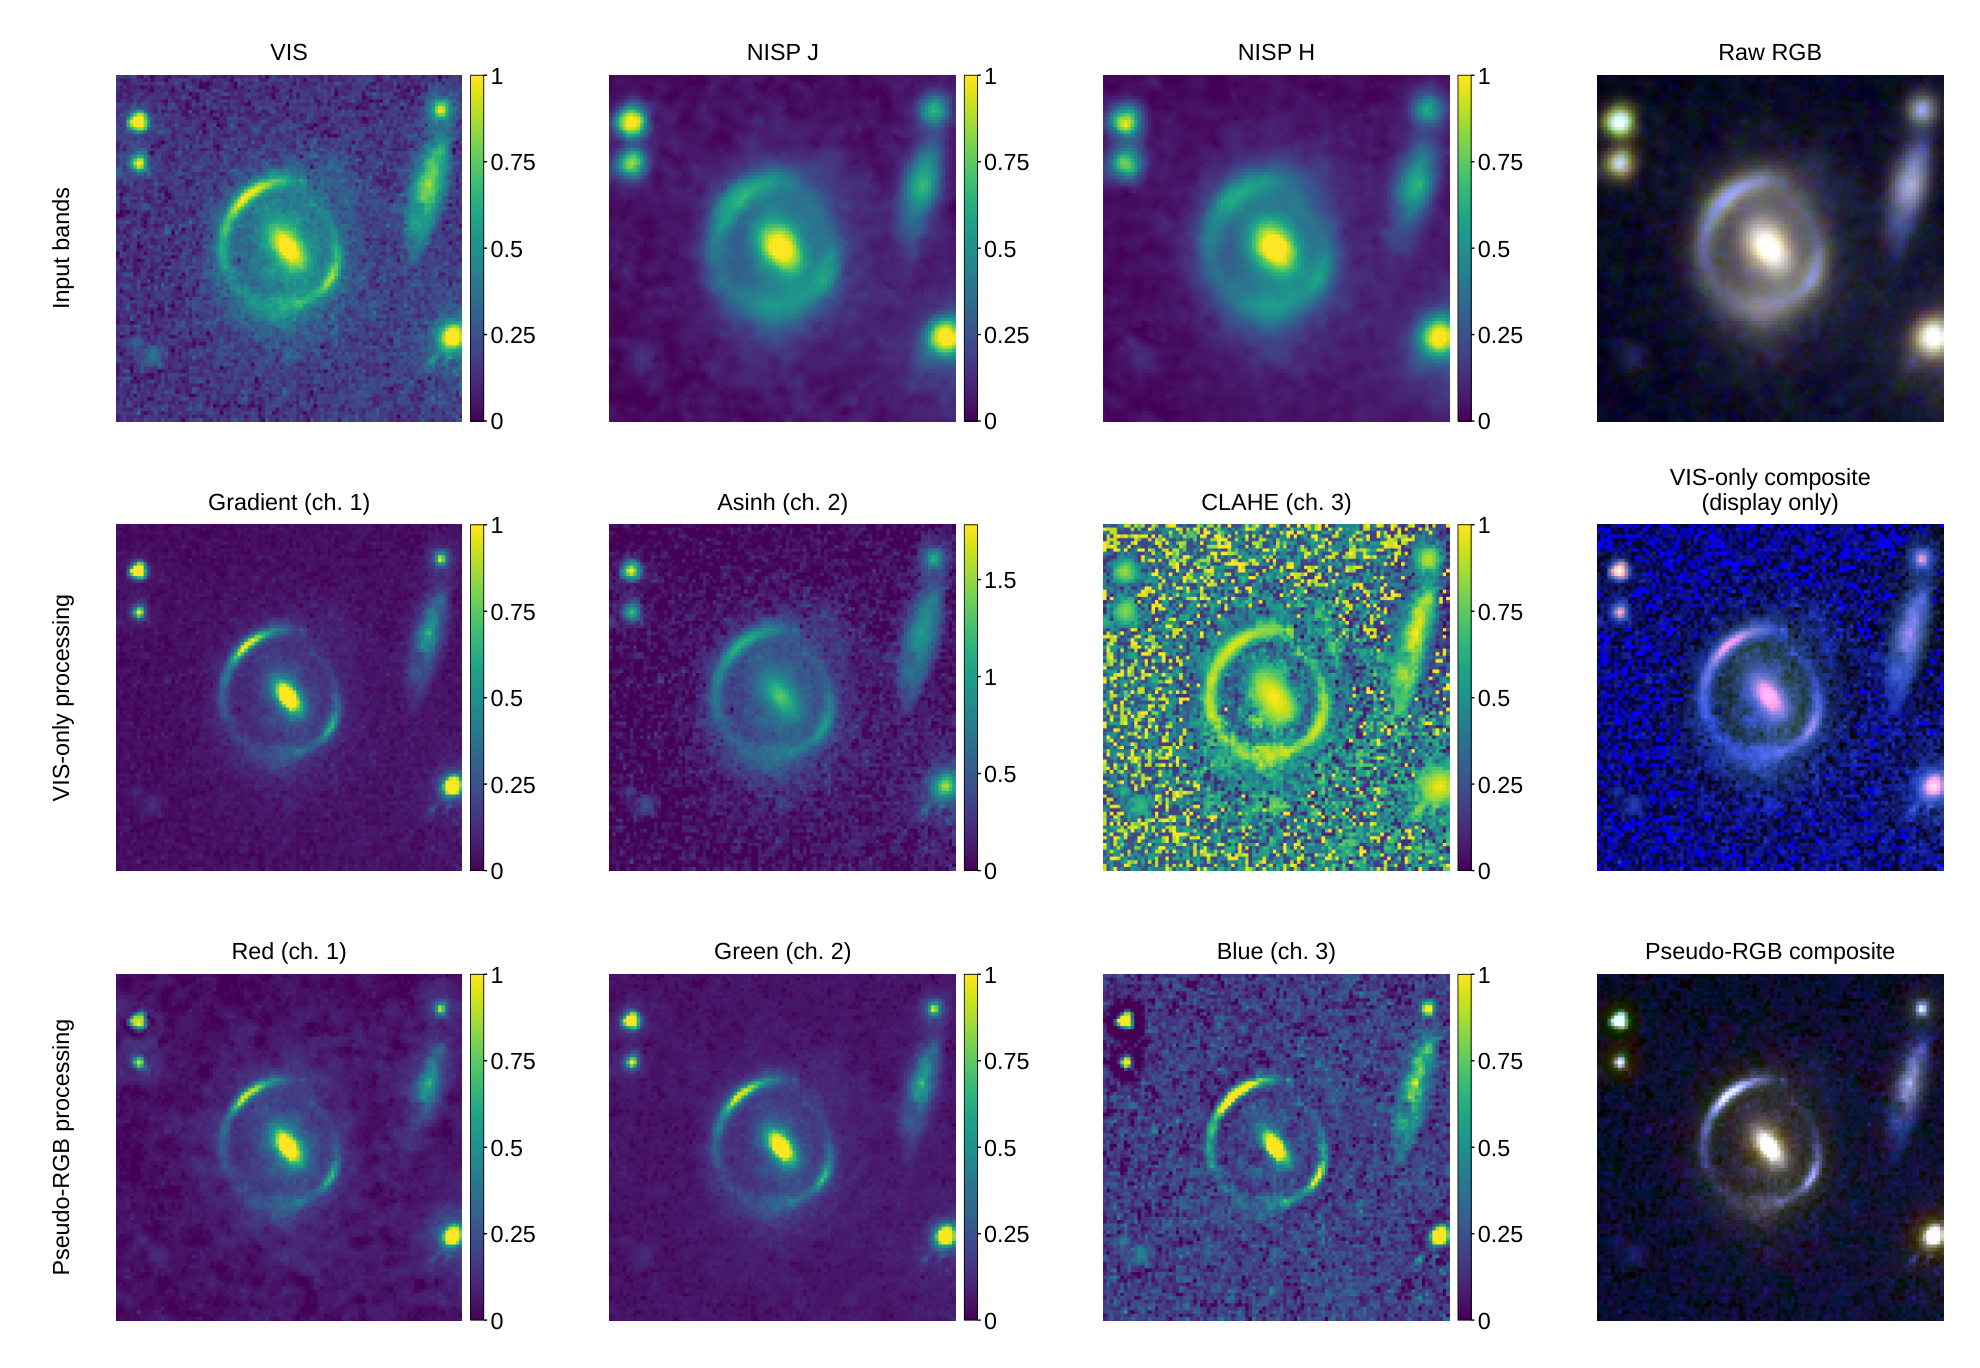
预处理后,各通道使用训练划分计算的均值和标准差进行标准化。Stage 0 对两类样本都做随机水平、垂直翻转。Stage 1 正例使用八种正方形旋转/反射变换,负例继续使用随机翻转。Stage 0 的两个分支都用交叉熵,Stage 1 的 VIS 分支改用 focal loss,取
训练使用 AdamW,batch size 为 100,weight decay 为
消融为何会改变模型选择
消融集包含 15,070 个 ECLIPSE A/B 级正例和 19,999 个经目检的 DR1 负例。作者给每个负例 3300 的权重,将负例计数放大到约 6600 万,近似巡天的类别比例。用于主要比较的高召回指标为
它只在召回率 0.75–1 的区间平均加权精确率。全区间 AP 还受到低召回区间的影响,因此两者可能偏好不同训练方案。下表取自表 5,所有数值均属于上述加权消融集。
| 表示与训练方式 | 加权 AP | 高召回加权 AP | 召回率 0.75 时的加权精确率 |
|---|---|---|---|
| VIS,两阶段参考模型 | 0.5954 | 0.0656 | 0.2544 |
| VIS,省去 Stage 0 | 0.3868 | 0.0107 | 0.0260 |
| Pseudo-RGB,两阶段参考模型 | 0.2974 | 0.0576 | 0.1758 |
| Pseudo-RGB,省去 Stage 0 | 0.4055 | 0.0147 | 0.0471 |
Pseudo-RGB 省去模拟预训练后,全局 AP 增加,高召回 AP 却下降 74.5%。VIS 对应下降 83.7%。这些结果支持保留模拟阶段,以覆盖真实微调集较少见的透镜配置。关于覆盖机制的解释仍属于作者的分析,现有消融直接验证的是训练方案与最终排序的关联。正文 §4.1、§4.3.5,表 5
困难负例也存在阶段效应。较早加入 X 类负例可改善部分 Stage 0 指标,但这种优势在后续微调中消失。另一个实验只增加 280 个较难判断的负例,就使 Pseudo-RGB 的高召回 AP 从去除这些对象后的 0.0385 降到 0.0216。其影响取决于负例背景和输入表示,适合用分层实验检验。作者同时承认,部分消融同时改变样本数与形态多样性,或同时改变正负例组成,现有结果不足以单独归因于某一种样本属性。正文 §4.2–4.3
FITS/JPEG 对照提供了另一个量级参考。JPEG 相对 FITS 的高召回 AP 下降约为 VIS 的 1.8% 和 Pseudo-RGB 的 4.3%,小于省去模拟阶段造成的变化。FITS 集成模型的高召回加权 AP 为 0.1133,JPEG 为 0.1077。论文所用“有效位深”指标根据离散强度级数量计算,可描述数值粒度变化。关于压缩损失的任务影响,应以这些分类实验为依据。正文 §3.3、§5.1
完整 DR1 上的集成与回收
两个分支分别预测透镜分数,作者比较算术平均、几何平均与 logit 平均。最终采用
该规则允许一个分支的高置信预测补偿另一个分支较弱的支持。它对 VIS 形态信息与近红外信息的互补尤其有意义。论文进一步按爱因斯坦半径、红移和各波段星等分析排序差异,发现两个分支的偏好随天体属性变化。
实际候选深度为 68,021 个 cutout。ECLIPSE 的 15,070 个 A/B 级系统中,有 14,237 个能够与本分析的完整打分目录匹配。表 6 的回收率以这 14,237 个唯一系统为分母,每个透镜的多幅 cutout 合并计数。
| 完整 DR1 排序模型 | 回收的唯一透镜系统 | 目录回收率 |
|---|---|---|
| VIS-only | 9650 | 67.8% |
| Pseudo-RGB | 10,395 | 73.0% |
| logit 平均集成 | 11,256 | 79.1% |
集成分别增加 1606 和 861 个系统,对应约 11.3 和 6.0 个百分点。其完整目录 AP 为 0.2784,两个单模型为 0.2175、0.1990。算术/几何平均的全局 AP 为 0.2881,而 logit 平均在实际候选深度提供了最高回收量。加权消融与完整巡天评估呈现的相对表现不同,也说明有限负例样本只能近似真实污染源分布。正文 §5,表 6、图 8–10
可信度、复现条件与阅读路线
对给定目录与候选预算下的排序改善,本文给出高可信度判断,依据是完整打分目录上的直接比较和对应的唯一系统计数。对训练机制的单因素解释,可信度为中等,部分样本变化存在混杂,论文也未提供足以估计所有模型训练随机性的重复实验统计。作者改变负例权重至 3000/3600 后,Stage 1 高召回排序保持一致,这验证了结果对适度类别比例变化的稳定性。
复现时还需核对样本构成。表 3 的若干 Stage 0 消融把 S2 样本记为 3737,而 §2.1.2 和表 1 的参考配置采用 2500,正文又将参考配置概括为在 train1 上加入伪影。不同配置是否另做了抽样,需要实际样本清单说明。完整研究代码、最终权重及对象级划分清单,本次未能从论文正文核实。论文也没有给出可直接换算的完整训练 GPU 时与双模型巡天推理成本。
建议按 §3.2 的输入表示、§3.4 的两阶段配方、§4.1 的评价定义、表 5、§5 和表 6 的顺序精读。附录 B 的图 13 适合对照实现输入通道。迁移到其他稀有天体检索时,可先固定主干与目检预算,对模拟预训练和负例组成做大小匹配的消融,再检查不同波段分支在红移、角尺度与亮度分层中的互补性。这些属于迁移分析,效果需要对应巡天验证。
审稿人视角:最大问题与研究启发
最大的一个问题
评价参照由参与发现的机器学习模型与目检共同建立,尚缺独立于发现流程的透镜真值,因此无法据此量化整个母体的完整性。证据锚点在 §4.1 的正例构成,以及 §5、§6 对 ECLIPSE 目录选择过程的说明。表 6 能检验已识别系统的回收,其中未被这些发现流程覆盖的形态和参数区域仍缺少参照。
这一限制最直接影响的是将目录回收率用于总体透镜丰度、红移分布或选择函数的科学解释。固定已知目录上的增益仍然成立。作者已经明确承认该边界,并使用多种发现模型扩大样本覆盖,仍需要独立观测或注入校准来测量遗漏总体。
最小而关键的补充是开展一次盲化、独立场区的注入—回收实验,在真实背景中覆盖不同角尺度、源亮度、颜色和形态,再以统一的候选预算报告分层回收。它能直接检查当前目录遗漏的参数区域,并为科学样本分析提供选择函数。
研究启发与可执行验证
稀有天体检索应将候选预算和选择函数纳入模型设计。可执行的检查包括保留独立场区、按物理属性统计回收、保存各波段分支的原始排序,并对负例难度做大小匹配的对照。代价主要在盲化标注和足够丰富的注入样本。推广到不同仪器时,PSF、噪声、波段及模拟真实性都需要重新建立,跨仪器增益仍有待实验。
2. Euclid Data Release 1 (DR1). AstroVink-TREX: Automated strong gravitational lens segmentation as input for mass modelling pipelines
作者为 Euclid Collaboration、S. H. Vincken、N. E. P. Lines、J. W. Nightingale 等。论文编号为 2611.17894v1,分类为 astro-ph.IM、astro-ph.GA,首次提交于 2026-11-13,本次分析对应首个版本。其适用场景是为物理透镜拟合自动生成图像分量、掩膜和初始化条件。摘要页、HTML 正文、PDF
值得作为自动化建模方法精读。 核心设计是把透镜识别网络已有的形态表征转用于连续分量图,再把输出落实为拟合程序能够读取的输入产品。
为什么需要连续分量图
强透镜图像中的前景透镜光、背景源的多重像和视线污染源会重叠。质量建模需要识别弧、确定拟合区域,并遮蔽无关对象。源的一小段暗弱像若被遮蔽,可能改变后续拟合所利用的约束。论文因而以三个连续通量图表示 lens、source、contaminant,允许多个分量在同一像素位置出现。
训练数据来自 377 个已成功使用 PyAutoLens 建模的 Q1 系统,包括主 SLDE 的 336 个和 SLDE-F 的 41 个。观测输入是 Euclid VIS 的
监督目标的生成值得仔细阅读。作者先计算每像素的观测通量与 RMS 之比,将负信噪比一侧镜像,估计均值为零的对称噪声分布。随后采用 Benjamini–Hochberg FDR 方法,以参数
PyAutoLens 的透镜光和源光重建提供各分量的空间位置。作者用这些位置掩膜与阈值化后的观测信号相交,构造 lens、source 目标图,其余需要排除的信号归入 contaminant。由此,监督像素取自观测,分量归属仍依赖已有拟合的空间分解。DR1 测试比较则直接使用 PyAutoLens 重建的透镜光和源光,污染分量缺少对应的 DR1 参考图,只能通过验证集与下游专家检查评价。正文 §2.1–2.4、附录 A
输入图经过 arcsinh 拉伸,复制为三通道,调整到
编码器、局部分支与损失
AstroVink-TREX 冻结已训练的 AstroVink ViT 编码器。全局自注意力将相距较远的弧段联系起来,卷积解码器把 patch 特征恢复为图像尺度。并行的卷积分支直接读取原图,为细弧和边界保留局部信息。两路信息按像素汇合,输出三个连续分量图。冻结编码器使 302 个训练系统主要承担新输出任务的适配,保留先前大规模透镜预训练形成的表征。正文 §3、§3.3
损失同时考虑遗漏结构与通量误差。对分量
按论文公式 3,
从
| source 相关系数 | lens 相关系数 | |
|---|---|---|
| 0.1 | 0.863 | 0.927 |
| 0.5 | 0.913 | 0.970 |
| 1.0 | 0.900 | 0.977 |
| 1.5 | 0.871 | 0.977 |
较大的通量权重有利于明亮透镜分量,却会使暗弱弧段丢失,源分量因此偏好中等权重。单用结构项或通量项都弱于组合损失。图 4 的阴影表示不同
训练使用 AdamW,初始学习率
从三张图生成物理拟合输入
预测图继续经过确定性处理。系统中心取预测 lens 通量大于零的像素坐标的算术平均。拟合半径取预测 source 像素到该中心的最远距离,再加
这些定义使输出接口可以被逐项检查。例如,若一段弧被漏检,受影响的不仅是分量图,还可能包括最大拟合半径和共轭像点。因而分割误差能够沿接口传播到物理拟合,应对产品分别保留诊断信息。正文 §3.4
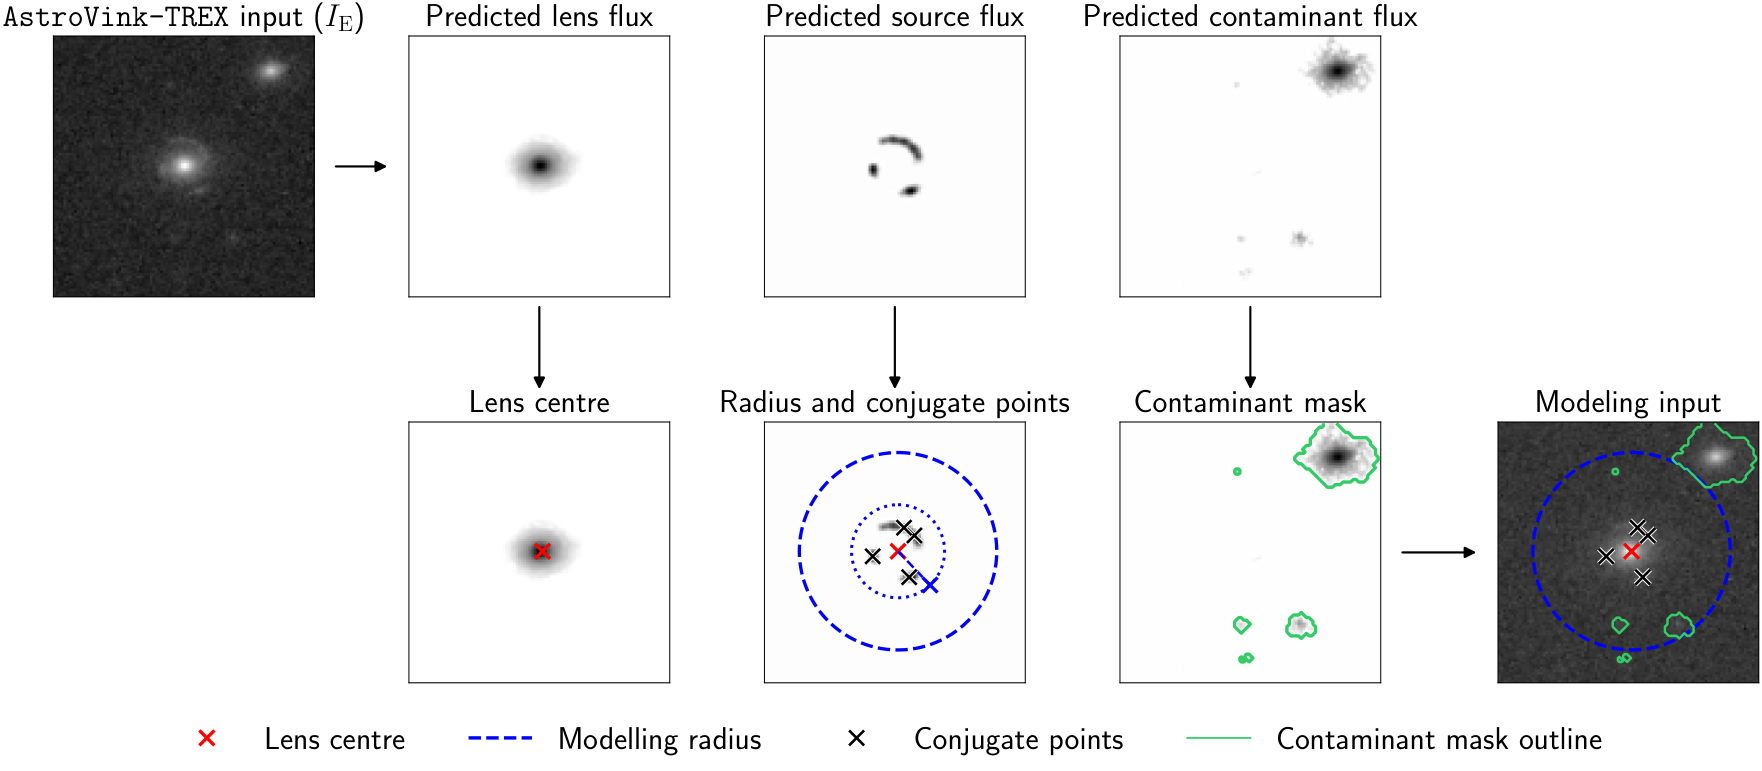
实际可用性、失败模式与成本
独立于前述 750 个开发测试对象,专家检查活动评估了约 3000 个使用自动分割产品建立的 PyAutoLens 模型。采用 75% 检查者一致的规则时,共有 210 个系统被判为失败,占样本约 7.0%。其中 39 个失败归因于分割,占全部系统约 1.3%、失败系统的 18.6%。共识阈值变为 100% 和 50% 时,可归因于分割的失败比例分别约为 0.4% 和 3.4%。这些数字随判定规则变化,适合衡量该工作流中被专家识别的失败负担。
作者明确限定了该统计的覆盖范围,计数对象是导致建模失败的分割错误。仍可得到可接受拟合的分割偏差,需要进一步的量化检查。常见失败包括暗弱源像被当作污染源遮蔽、污染对象残留,以及复杂形态中的分量混淆。污染通道缺少 DR1 分量真值,使下游检查在这里尤其重要。正文 §4.3
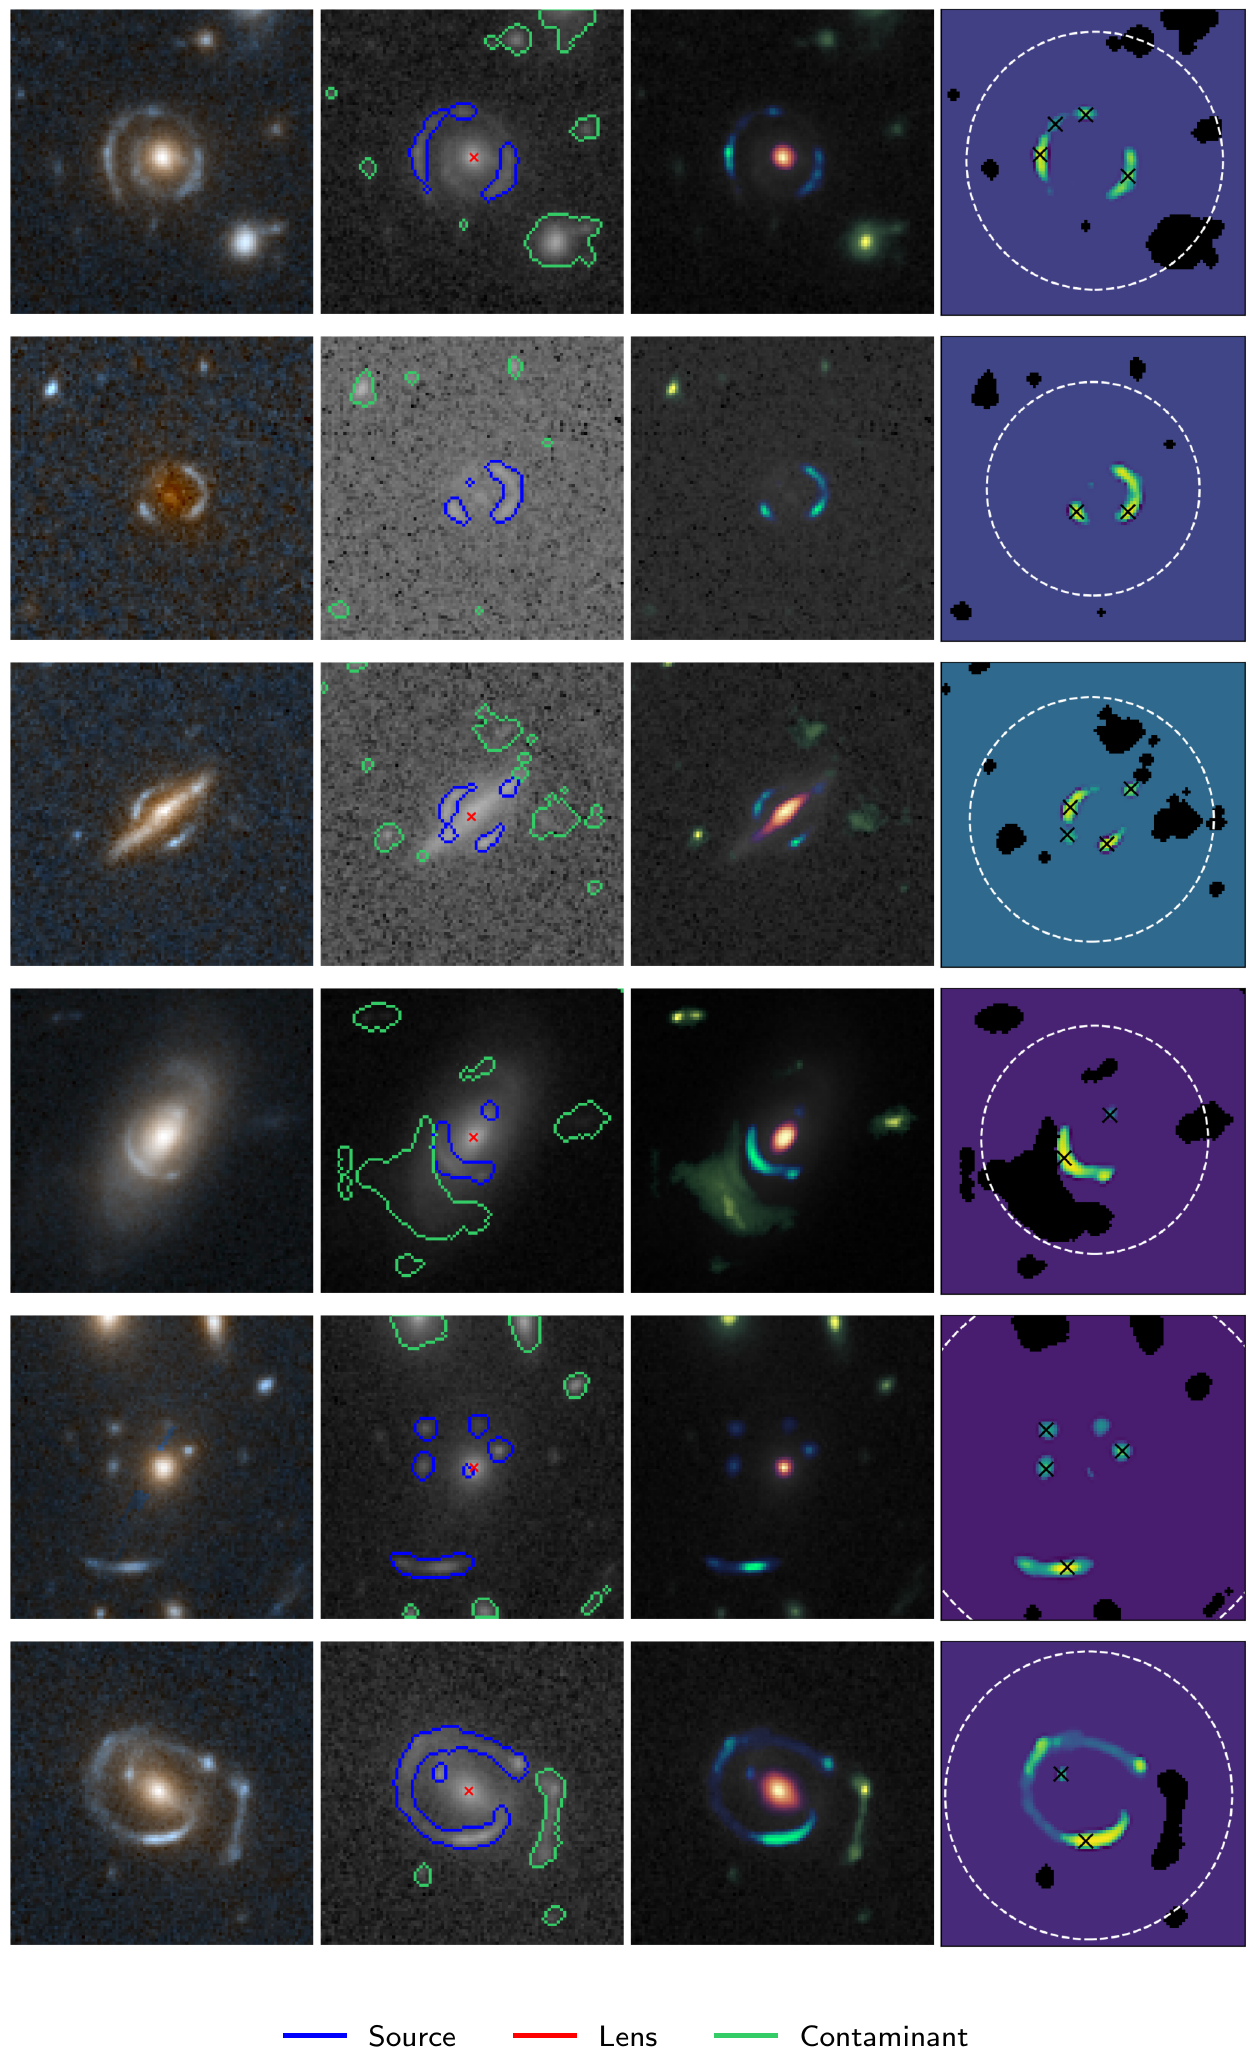
成本实验在一台标准笔记本 CPU 上逐个处理 50 个系统,网络平均推理为每个 0.34 秒,加上预处理和输出处理约为 0.35 秒。按这一均值线性外推,15,000 个系统约需 1.5 小时。作者以其他透镜建模工作的人工经验估计,同等数量的手工准备约需 300 小时。两项数字分别来自小样本基准与人工经验估算,实际批处理还要计入数据读取和复杂系统的复查成本。正文 §5
证据评价、复现与阅读路线
对给定 Euclid 样本中降低人工准备负担、生成可用建模输入的判断,可信度为中高。依据包括独立 DR1 对象的比较、专家检查和明确的输出接口。对绝对分量通量及质量参数无偏性的判断,现有证据有限。Pearson 相关系数主要评价亮度结构,且对正比例整体缩放保持不变,精确测光与后验区间覆盖需要相应指标。
少量成功建模的 Q1 系统决定了监督分布,极暗弧、多源面、邻近星系和复杂群环境需要专门验证。作者建议用新建模系统继续生成标签、扩充困难样本,并指出单波段输入的限制。近红外扩展需要重新适配编码器与训练分布,其增益在本篇尚待验证。
本次未能从正文核实完整研究实现、最终训练权重及对象级数据清单。网络各层宽度、具体融合实现和环境版本也需要实现材料补齐。论文给出的冻结策略与小样本训练时间,足以帮助设计原型实验,端到端结果复现仍依赖这些材料。
建议优先阅读 §2.1–2.3 的目标图生成、§3.1 的支持集损失、§3.4 的产品定义和 §4.3 的失败检查,再看图 7、图 9 与附录 B。迁移分析可先保留物理拟合程序,分别替换污染掩膜或区域初始化,测量哪种自动化输入最容易引入参数变化。对不同巡天,信噪比阈值、PSF、像素尺度和标签生成流程都需要重新校准。
审稿人视角:最大问题与研究启发
最大的一个问题
下游验证以可接受拟合和可见失败为主要终点,尚未量化自动分割对科学质量参数的偏差与区间覆盖。§3.2 的相关系数、§4.3 的专家判定及 §5 的效率测量,能够支持流程可用性。精密质量测量还需要检查自动掩膜、源像遗漏或初始化变化对最终参数的影响。
这比进一步提高图像相关系数更影响科学使用。一个可接受的拟合可能仍对掩膜与保留像素敏感,进而改变爱因斯坦半径、源重建或其他质量模型参数。这里提出的是需要验证的可能性,论文没有证明实际发生了系统性偏差。其自动化和效率结论仍然成立,精密物理推断的适用范围需要额外校准。
作者承认专家统计只覆盖造成建模失败的分割错误,并提出用重建图与分割图的差异标记困难系统。这有助于发现明显异常,参数层面的偏差仍需已知真值的实验。最小补充是对一组盲化注入透镜,固定物理模型和采样设置,分别用人工与自动产品拟合,直接比较质量参数偏差及可信区间覆盖,并覆盖低信噪比和复杂污染条件。
研究启发与可执行验证
科学图像自动化的评价应一直延伸到最终物理量。实际实现可为每个分量图保留来源和置信诊断,记录掩膜变化前后的参数差异,再把高风险系统交回检查。迁移的前提是建立与目标仪器一致的注入或外部参照,额外代价主要来自重复物理拟合。连续分量图、仅在信号支持集上计算损失,以及从图像产品生成建模输入的接口,都可以作为一般设计思想继续验证。
四、跨论文结论与行动建议
两篇论文的迁移学习策略分别适应了各自的监督规模。检测研究用较大的模拟和真实集合做全网络微调,分量分解研究在数百个标签系统上冻结编码器、学习新的输出任务。采用哪种策略应由任务、标签覆盖和验证实验决定。检测端的选择偏好还会影响进入建模端的样本分布,后续科学分析需要追踪这一传播。
- 优先精读检测论文的表 5 和表 6,建立高召回指标、固定候选预算与唯一系统回收之间的对应关系。分量分解论文随后作为输出接口和小样本适配的方法储备。
- 对稀有天体检索,可在独立场区固定主干和目检预算,做样本数匹配的模拟阶段与负例难度消融,并按亮度、角尺度和颜色测量选择函数。这是迁移实验建议。
- 对自动物理建模,可先建立盲化注入集合,固定拟合程序,测量自动掩膜与初始化对最终参数和区间覆盖的影响。图像层面的相关性与专家失败负担应一并保留。
- 第一篇最大的限制影响母体完整性解释,第二篇最大的限制影响精密参数推断。它们均保留了较高的阅读价值,复现实验应优先补齐对应的独立参照和科学终点,再扩大样本或增加网络复杂度。
本报告由 GPT 6.1Sol XHigh 整理分析,博客作者对分析内容不负责且不代表博客作者本人的想法。