一、本期总体分析
arXiv 论文时间范围:[2026-10-27 05:00:05, 2026-10-28 05:00:05)(Asia/Singapore) 各分类篇数:astro-ph 223;cs.CV 483;cs.LG 697;cs.AI 711;stat.ML 106(含跨类,分类间可能重复) 入选篇数:2
本期两篇论文都围绕资源分配,但节省的对象不同。FastPM把昂贵模拟之前的学习交给廉价模拟,比较达到同一后验评分需要多少高保真样本;BUTR则把检测器的查询数量随图像变化,检验复杂的查询筛选究竟贡献了什么。共同值得学习的是:先明确资源单位与控制变量,再评价模型效果,不能把样本数、FLOPs和实际运行时间互相替代。
建议先读FastPM,约25–35分钟,重点看三类物质功率谱、训练成本曲线和后验覆盖率。它的迁移实验比较直接,但只覆盖同一高保真模拟家族。再读BUTR,约40–60分钟,连同附录和训练代码一起看。它的查询机制干预很有启发,不过公开训练流程存在测试集参与检查点选择的问题,因此更适合作为机制分析和实现储备,不能直接把小幅AP领先当成独立测试结论。
二、入选论文概览
| 优先级 | 英文标题 | 类型 | 核心贡献 | 数据或基准 | 代码状态 | 适用研究场景 | 一句话判断 | arXiv |
|---|---|---|---|---|---|---|---|---|
| 1 | FastPM: Fast Pretrained Model for Cosmological Simulation-Based Inference | 天文交叉 | 廉价粒子网格模拟预训练,少量高保真模拟微调后验估计器 | FastPM、CAMELS IllustrisTNG | 本文专用训练代码未能确认公开 | 多保真模拟、概率参数推断、仿真预算规划 | 节省训练模拟成本的证据明确,不能外推为真实观测可靠性 | 2610.33955v1 |
| 2 | Dynamic Query as Budgeting for Tiny Object Detection | 纯CV检测 | 解耦查询数量与查询身份,用无学习参数的预算器替代复杂筛选 | AI-TOD-v2、VisDrone、Sorghum-Grain-Count、COCO | 官方核心实现、训练和评估路径齐备 | 密集小目标检测、DETR查询分配 | 控制实验比小幅排行榜增益更有价值,复现应先重做验证划分 | 2610.33430v1 |
三、逐篇深度分析
1. FastPM:高保真模拟之前,先让廉价物理模型承担预训练
基本信息:Masaya Yamamoto、Adrian E. Bayer;arXiv:2610.33955v1;astro-ph.CO、astro-ph.IM;首次提交与本版日期均为2026-10-24,具体时间23:53:46 UTC。可访问摘要页、HTML正文和PDF。摘要页未列正式期刊接收信息。正文链接了CAMELS官方文档,但未能确认这项研究专用的模型权重、训练配置或代码仓库已经公开。
适用研究场景与一句话结论:对于可获得低保真模拟、却难以大量生成高保真标签的天文概率推断,值得精读。最有用的结论不是“低保真可以替代高保真”,而是低保真预训练能减少后续适配所需的高保真训练样本,且最佳方案取决于计算预算。
科学问题、数据来源与贡献边界
宇宙学模拟既要演化引力聚集,也可能要处理气体、恒星形成和活动星系核反馈。后几项物理过程改变小尺度物质分布,不能简单从纯引力模拟中删除而不付代价。本文希望由物质功率谱推断总物质密度参数
该论文不使用巡天数据。引言中的弱引力透镜巡天只是动机;实验输入是模拟三维物质分布的功率谱,不是巡天图像、星系测光,也不是实际观测的剪切功率谱。因此没有观测波段、天空覆盖、曝光条件或天体交叉匹配步骤。这里的“模拟—模拟迁移”不能改写成“模拟—真实迁移”。
高保真数据来自CAMELS的IllustrisTNG Latin hypercube(LH)集合,包含1,000次流体模拟及其匹配的纯N-body模拟。模拟盒子边长为
LH集合变化的宇宙学参数范围为
低保真数据由Fast Particle-Mesh求解器生成。论文也把预训练模型缩写为FastPM,阅读时需要区分“模拟器”和“由其数据训练的后验网络”。作者保持盒子尺度、粒子数及宇宙学先验与CAMELS一致,用
独立相位使实验不是靠逐个复制高保真模拟的空间实现来完成迁移。不过两端共享先验、盒子尺度和部分物理设定,仍属于较受控的迁移。已有工作研究过FastPM到N-body、N-body到流体模拟的迁移;本文的具体增量是直接跨越到流体总物质功率谱,并把低保真模拟的步数、数量和生成成本同时纳入比较,而非首次提出迁移学习。
输入到联合后验:没有复杂新架构,关键在初始化与成本对照
数据流为:模拟输出物质功率谱
训练使用神经后验估计(NPE)的负对数似然目标:
模拟参数是真值标签;网络学习某种功率谱对应哪些参数组合,以及这些组合的相对概率。概率流负责表达联合后验形状,不是另加一个误差回归头。低保真预训练后,以得到的网络权重初始化高保真训练,网络架构沿用预训练配置;正文没有报告冻结某个子模块,因此不能把方法描述成“冻结编码器、只训练预测头”。第III节、式1–3
作者采用
从头训练时,作者同时优化训练轮数、one-cycle峰值学习率、嵌入维数与MLP结构、样条流宽度、变换数、残差块数和dropout;微调时只优化轮数与学习率。每种优化使用Optuna的100次trial。各方法共享100次高保真模拟构成的验证集,该集合不参与梯度更新;另有同样的200次模拟作为测试集。高保真训练数量取10、25、50、100、200、400、600、700,论文所称训练数量不包含验证集与测试集。
这个对照允许两类方法分别寻找适合自己的超参数,较固定一个不合适基线更合理。但从头训练搜索架构、微调继承架构,两者搜索问题不同;论文也没有把100次搜索的GPU成本纳入CPU小时曲线。公开证据支持的是训练模拟生成成本,不是端到端项目总成本。
核心结果:样本节省、成本节省和校准应分别理解
主要指标NLTP是200个测试模拟真参数处的平均负对数后验密度。越低,表示给真值分配的密度越高;它不是参数相对误差,也不是置信区间覆盖率。由于密度依赖参数坐标与尺度,论文使用同样的
| 输入任务 | 2,000次、20步预训练后达到NLTP=1所需高保真训练样本的减少幅度 | 训练模拟生成成本节省倍数 |
|---|---|---|
| 纯N-body物质功率谱 | 约90% | 8.8倍 |
| 流体模拟中的冷暗物质功率谱 | 约85% | 6.8倍 |
| 流体总物质功率谱 | 约80% | 4.7倍 |
以上是作者在第IV节、图2和图3报告的同一目标评分比较,不是每一个训练规模都具有这些倍数。摘要中的“只需5%–15%高保真模拟”对应更大的预训练集合,不能与最廉价2,000次方案拼接成一个同时实现的结果。
表1给出单次模拟成本:20步FastPM约1 CPU小时,200步约9.5 CPU小时,CAMELS N-body约250 CPU小时,流体模拟约3,000 CPU小时。因此2,000次廉价预训练共约2,000 CPU小时,确实低于一份流体模拟的成本,但绝不是轻量笔记本实验。10,000次200步预训练则约95,000 CPU小时,已高于N-body基线达到NLTP=1所需的约70,000 CPU小时;在这一预算目标下,保真度更高反而不划算。
另一面是最终可达到的评分:高保真训练数约400及以上时,基线与20步预训练模型都接近NLTP约0.7;10,000次200步预训练达到N-body约0.5、两种流体任务约0.6。这说明在本文探索的预算内,昂贵预训练不只提前达到同一水平,也能达到更低的评分。它没有证明继续扩大或改进从头训练后仍必然无法追平。
后验可靠性用TARP覆盖率诊断检查。图4只展示2,000次20步预训练这一配置:高保真训练数10或25时,两类方法均有一定过度自信;达到50及以上后,曲线较接近对角线。结果取三次独立网络初始化的均值,阴影为模型间标准差,而非测试样本覆盖率的完整置信区间。平均覆盖接近标称值也不保证先验边缘、特定反馈强度或稀疏参数区域的条件覆盖都正确。图4
证据评价、复现风险与阅读路线
可信度为中等偏高,限于本文受控模拟任务。训练规模扫描、三个物理输出、两种低保真精度、三次初始化和覆盖率诊断共同支持迁移有效。尤其是总物质任务中仍有收益,说明预训练学到的引力依赖并非被重子差异完全破坏。将其解释成“先学共通引力结构,再修正物理差异”是合理迁移分析,但论文没有通过表示探针或模块消融直接证明网络内部学到的就是这些因素。
复现仍缺本文专用代码、完整搜索空间和最终超参数、明确可下载的FastPM预训练集合及模型权重。CAMELS本身有公开资源,不等于本文所有产物都已经可下载。正文也未说明不同训练规模的子集是否严格嵌套,三次重复是否同时改变数据子集;目前只能确认重复的是网络初始化,不能把误差条当成模拟样本抽取不确定性。
阅读时建议精读II节确认两端共享与不同的物理设定,再读III节的验证、测试与成本口径,最后结合图2–4判断训练效率和概率可靠性。引言中的基础模型愿景可以选读;本文训练的是面向两参数和功率谱的专用后验估计器,还不是已经验证多观测、多任务能力的通用天文基础模型。
审稿人视角:最大问题与研究启发
最大的一个问题
最大的限制是高保真端始终来自同一IllustrisTNG家族,当前实验不能判断节省的样本是否足以适应不同反馈实现带来的真正模型差异。第II.1节明确仅取IllustrisTNG,训练、验证、测试均来自其LH集合;第V节把SIMBA或跨CAMELS套件迁移列为未来工作。三种功率谱增加了物理难度,却不构成三个独立模拟家族的验证。
这比少报某个网络超参数更影响科学适用范围:高保真训练数很少时,网络可能在既有模拟家族内部恢复良好,但在另一套反馈规律下留下偏置。它不推翻表中成本收益,也不是作者已经证明存在偏置;它限制的是把这些收益推广到未知物理模型、乃至真实观测的可信程度。作者已经承认跨套件验证尚未完成,现有TARP测试仍是同家族检验,不能替代它。
最小关键补充是固定一个廉价预训练模型和预算,在另一高保真套件上以相同训练数量比较“从头训练”和“预训练后微调”,把测试参数点、初始实现和评估流程固定,并同时报告NLTP与条件覆盖率。重点不是要求模型完全不微调就通用,而是检验迁移后仍能否以较少样本获得无明显偏置的后验。
研究启发与可执行验证
可借鉴的是把物理保真度当成可分配的训练资源,同时保留独立的高保真评估预算。迁移到光谱、图像或其他模拟推断时,可先做两个小型检查:其一,固定高保真验证与测试集合,只改变预训练保真度和高保真训练数量,避免成本收益来自改变评估难度;其二,对主要物理参数及模拟器差异分层检查覆盖率,防止整体校准掩盖局部失真。
这里的前提是低保真模型保留目标参数的相关变化,而不仅仅生成视觉相似的数据。低保真误差若与待推断参数退化,迁移可能变成负迁移。计算预算应分列预训练、微调数据生成、独立评估数据和模型训练搜索,不把本文4.7–8.8倍直接作为新任务的预期收益。这些是迁移建议,尚未在其他天文模态上由本文验证。
2. BUTR:动态查询的收益,究竟来自数量还是筛选规则?
基本信息:Yi Zhang、Di Xiong、Ge Gao、Xiangyue Zhang、Yihang Qiu、Yuxuan Zhou、Shuo Chen;arXiv:2610.33430v1;cs.CV;首次提交与本版日期均为2026-10-24,具体时间04:07:43 UTC。摘要页、HTML正文、PDF、官方实现。仓库自述NeurIPS 2026接收;本文分析依据的是arXiv v1及下述固定代码提交,并未独立核验会议录。
适用研究场景与一句话结论:适合研究两阶段DETR、密集小目标和输入自适应计算。值得带走的是“先把查询数量与查询身份分开做对照”,而不是默认采用某个新模块;正式复现时必须先修正独立验证的设置。
问题与控制实验:复杂筛选可能只是间接扩大了预算
DETR的查询是供解码器输出类别与框的候选槽位。固定较少查询对稀疏图像便宜,但在含数百个目标的图像上可能限制召回;对所有图像统一增大查询数又会增加冗余。动态查询方法因此让数量随输入改变,但经常同时改变查询的选择规则,难以区分二者作用。
本文以Dome-DETR的PAQI流程为诊断对象。它先保留较大的候选集合,再通过Split保护最靠前的候选,使用预测的窗口掩膜和NMS筛选其余候选。作者在同一训练权重上分别关闭这些操作,而不把重训练带来的差异混进第一轮机制分析。第3节、表1
AI-TOD-v2上,完整PAQI平均630个查询、35.1 AP;普通Top-600达到35.0 AP,Top-900达到35.1 AP。VisDrone上完整流程平均388个查询、29.3 AP,Top-400同样为29.3 AP。去掉Mask或NMS但保留Split时,总体AP不变;失去对高置信候选的保护后则可能明显下降。这支持复杂后处理在这些设置下并非必要,但不能推出“查询身份任意选都一样”,因为Top-K依然依赖学到的分类排序。
总体指标还掩盖了长尾。AI-TOD-v2测试集中,目标数超过600的极密集子集只有26张图,占0.19%,却含24,692个标注。该子集上,PAQI为29.9 AP,Top-600为23.4 AP;提高到Top-1500才回到29.9 AP。其余13,992张图,两者已经接近。VisDrone的密集子集只有7张图,最大461个目标,因此动态预算的额外空间更小。表2、图2
这组结果把贡献定位得很清楚:动态方案可以在少数拥挤图像上提供更大容量,同时避免每张图都付相同代价。附录A进一步分别训练固定数量、使用Top-K或DDQ式空间去重初始化的D-FINE-L,两数据集总体AP分别都相同,为解释增加一项独立于PAQI开关的对照;它仍不覆盖所有检测器与所有查询选择方法。
完整数据流与设计动机
实现以HGNetV2提取多尺度特征,经HybridEncoder做高层特征交互与跨尺度融合,再由编码器候选的分类分数决定查询数量。以公开L配置为例,HGNetV2-B4输出步长4、8、16、32的四级特征,通道数128、512、1024、2048;混合编码器统一到256通道,在最深一级使用一层、8头的Transformer编码,再进行跨尺度融合。800×800输入对应四级空间尺寸200×200、100×100、50×50、25×25。后者是按配置步长推得,不是新增实验测量。L配置
预算器对每个有效编码器候选取最大类别sigmoid分数,并将所有候选的分数求和:
随后按分数取Top-
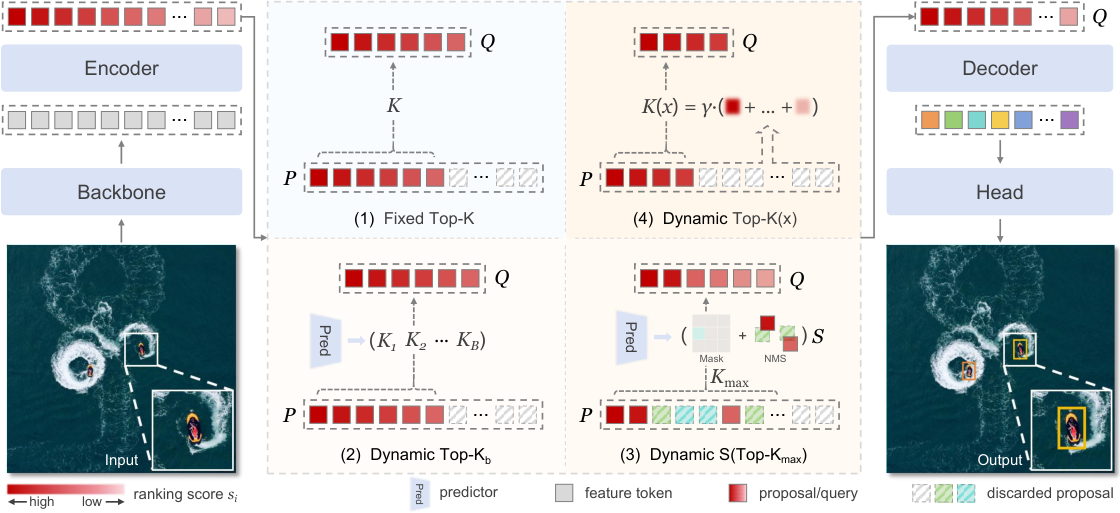
置信度总和不是无偏的目标计数器:同一天体或物体可能对应多个高分候选,背景也可能贡献分数。作者需要的是密度排序和足够的保守预算,而不是精确计数。其相关性实验中,AI-TOD-v2的Pearson相关为0.94、Spearman为0.82,VisDrone分别为0.82和0.79,支持该代理量在这些数据上的作用,却不是跨域单调性的数学保证。
解码器继续进行自注意力、多尺度可变形交叉注意力、类别预测与框细化。公开L配置在AI-TOD-v2用4层、VisDrone用6层,因此两套L模型参数数目不同,不能看到不同参数量就认定统计错误。训练保留去噪查询以及Hungarian匹配;公共配置给出的类别、L1框、GIoU匹配成本权重为2、5、2,损失权重为VFL 1、框L1 5、GIoU 2、FGL 0.15、DDF 1.5。后两项继承原有细粒度定位及分布蒸馏训练,不是BUTR新提出的预算损失。
代码还有一个重要实现条件:butr_decoder.py实际取一个batch内所有图像预算的最大值作为统一解码长度。因此按图自适应的平均查询统计最直接对应batch size 1;将稀疏与密集图像放在同一大批次里,计算节省会被稀释。无参数不等于无运行开销,动态Top-K和引擎间同步仍会增加延迟。
训练配方、主结果与比较公平性
两套遥感基准均将trainval用于训练、test用于评估。输入800×800,总训练batch为16,训练设备为8张RTX 4090;论文训练时间包括每个epoch的验证。AI-TOD-v2训练160轮,VisDrone训练120轮。公开配置采用ImageNet初始化的HGNetV2、AdamW,主学习率
数据增强包括随机颜色扰动、zoom-out、IoU裁剪和水平翻转,再缩放、转浮点至
| 数据集、模型 | AP | 参数量 | 平均查询数 | GFLOPs | 训练小时 | T4延迟毫秒 |
|---|---|---|---|---|---|---|
| AI-TOD-v2,D-FINE-L | 35.2 | 31.9M | 600 | 329.6 | 43.0 | 20.34 |
| AI-TOD-v2,Dome-DETR-L | 35.1 | 33.4M | 630 | 379.8 | 83.6 | 33.30 |
| AI-TOD-v2,BUTR-L | 35.7 | 31.9M | 316 | 326.1 | 39.8 | 20.94 |
| VisDrone,D-FINE-L | 29.6 | 34.5M | 400 | 329.5 | 11.9 | 22.06 |
| VisDrone,Dome-DETR-L | 29.3 | 36.0M | 388 | 379.0 | 22.4 | 34.47 |
| VisDrone,BUTR-L | 29.8 | 34.5M | 398 | 329.5 | 11.8 | 23.76 |
数值来自表3–4。BUTR相对Dome-DETR在精度和速度上均有优势;相对强固定查询基线D-FINE,AP只增加0.5和0.2点,部署却分别慢0.60和1.70毫秒。AI-TOD-v2的查询数近乎减半,整网FLOPs只减少约1%,说明大部分计算仍在共享特征提取部分。不能据查询数声称整网加速两倍。
模型尺度方面,AI-TOD-v2表3的BUTR-S/M/L分别为32.6/34.6/35.7 AP,参数量11.6/22.3/31.9M;VisDrone为26.7/29.4/29.8 AP。仓库README把AI-TOD-v2的S模型写成32.7,与论文32.6不同,本报告保留论文表值,不把较新仓库数字无说明地覆盖论文结果。表3与表5的L模型部分细分AP也有小差异,不能将两表不同设置的细分指标拼成一行“最佳结果”。
比较设置有明确限制:固定查询基线被改为600/400查询,训练轮数与BUTR对齐;DEIM的MAL因该设置下训练不稳定被替换为VFL。因此表中的DEIM是适配版本,并非原方法默认训练结果。DQ-DETR只训练36轮,且保持五层特征结构,跨它的训练时间与AP比较不能解释为单一预算模块的贡献。
消融表5显示,在AI-TOD-v2上把安全系数从1提高到2,平均查询由303变为316,总体AP由35.5变为35.7,极密集AP由28.9变为29.8;提高到3后总体和极密集AP不再增加。Max、Max-sigmoid、Sum-prob、Union-prob四种代理量都能工作,说明无需把特定分数公式神化。附录F中,种子0/1/2的极密集AP均值与样本标准差为BUTR-L
跨场景实验也要分清协议。Sorghum-Grain-Count先按原图划分trainval/test,再裁成800×800、步长640的重叠patch,并只保留非空patch,得到1,859个训练和433个测试patch。BUTR-L用平均378查询达到58.0 AP,与固定1,100查询的DEIM-L相同;该实验没有验证空背景误报或原图合并后的计数准确性。COCO则完全不重训练,只替换官方权重的查询初始化。例如D-FINE-S的AP为48.5→48.6,查询300→232,但延迟3.63→4.24毫秒。这里的小幅AP变化是同权重配对结果,不能由遥感任务的重训练方差直接解释。附录G、表6
延迟测试采用T4、TensorRT 10.4.0、FP16、batch size 1,每轮1,000次warmup与同序1,000张图像,平均三轮;包含动态预算、同步和后处理,但不包括图像读取、预处理和输入传输。附录H明确主AP不是完整测试集FP16部署评估;AI-TOD-v2的DEIM-S还存在未解决的部署精度不一致,VisDrone的DEIM-S/M计时使用同尺度D-FINE权重配DEIM推理结构。因此不能宣称所有AP与延迟都已经在同一部署产物上联合复现。
开源代码核验卡
核验日期为2026-10-28(Asia/Singapore),固定提交为e90f918cc4be10d0256385de6acfc9768df94d47。官方性依据是arXiv摘要与正文直接链接此仓库,README列出的作者和论文一致。检查为源码与文档阅读,没有安装环境、训练或声称跑通作者指标。
| 核验项 | 关键资源 | 结论 |
|---|---|---|
| 核心模型 | budget.py、butr_decoder.py | 包含真实分数聚合、截断、Top-K及解码接入,不是薄封装 |
| 训练 | train.py、configs/models、src/solver/det_solver.py | 有分布式训练命令、优化器与数据配置、实际fit路径 |
| 评估 | train.py的--test-only、src/solver/det_engine.py及评估器目录 | 有独立调用评估的入口、数据集指标配置与多GPU汇总说明 |
| 配置与文档 | requirements.txt、docs/environment.md、docs/data.md、docs/usage.md、docs/tensorrt.md | 依赖、数据准备、运行和部署文档齐备;代码为Apache-2.0 |
满足实质性开源门槛。这表示可以审查并按公开路径尝试训练与评估,不表示实验划分已经合格,也不表示所有权重已齐备。README仍有重训权重将发布的说明,不能把部分checkpoint链接推广为所有尺度都可直接复现。
证据评价与阅读路线
可信度为中等:固定权重干预、足量Top-K对照和密度分层较有说服力;“预算比复杂筛选更重要”在本文指定检测器和数据上成立的证据强于“BUTR有普遍、稳定的小幅AP优势”。分数尺度变化、极密集样本很少和实际部署边界限制推广;更关键的验证独立性问题见下一节。
精读顺序建议为第3节表1–2、第4节算法、表3–6,随后附录F/H和训练solver。若只收藏模块,至少先读公开数据配置,避免直接复用其test作为训练期验证的路径。将方法迁移到天文拥挤场属于未验证建议;只有检测器确实以查询数量限制召回时,这个模块才可能解决主要瓶颈,不能替代对PSF、混叠和低信噪比的处理。
审稿人视角:最大问题与研究启发
最大的一个问题
最大的一个问题是公开复现流程让名为test的数据参与检查点选择及训练反馈,使小幅AP领先缺乏独立测试保障。这不是仅凭“论文没写验证集”推断泄漏:第5.1节写trainval训练、test评估,附录F写每次选择总体AP最高的检查点;aitod_detection.yml将val_dataloader明确指向test目录和aitodv2_test.json;det_solver.py每轮用它评估、保存best检查点,并在持续不改善时调整EMA和重新加载检查点。
据当前代码,测试反馈不仅用于最终展示,也能影响返回训练的状态。无法仅凭这些文件断言论文每一次历史实验都与当前重构代码完全相同,但所发布路径的依赖关系是明确的。0.2–0.5 AP的小幅比较尤其需要避免这种选择偏差;所有方法共享相同问题也不能保证偏差相互抵消,因为不同方法的训练波动和被选中的时刻不同。
这一问题比查询数减少却不一定更快更重要,后者已被延迟表直接展示;前者影响的是怎样解释性能证据。它不抹去同权重Top-K干预所揭示的容量效应,也不说明代码不能训练,但需要下调对排行榜差距和跨种子最佳检查点结果的信任。在已核查的第5节、附录F/H和公开使用说明中,作者报告了选择规则,未给出独立验证集合如何隔离test反馈的补充证明。
最小修正是从原训练资源中保留独立验证集,只在那里选择轮次、安全系数和EMA策略,然后固定所有决策,对未参与选择的测试集评估一次。对BUTR与D-FINE、Dome-DETR使用相同划分和种子,报告配对差值即可,不必先增加新架构。若原实验事实上用了另一套未公开划分,则应先提供其样本清单和代码路径,而不是按当前默认配置重跑后宣称消除了问题。
研究启发与可执行验证
评价自适应计算方法时,验证集负责决定“怎样分配”,测试集只负责回答“分配是否有效”。最小实验可拆成同一方案中的两个对照:固定权重时,只改变查询数量或选择规则,观察密度分层AP与实际延迟;重新训练时,在独立验证协议下做相同种子的配对比较,区分模块效果与检查点选择收益。
若接入天文源检测,可按独立天区或原始曝光分组,防止相邻裁块跨集合;按拥挤度、信噪比及PSF条件分层评价,除AP外同时报告固定误报率下的召回和耗时。样本量足够时按原图而不是单个框bootstrap,以保留同图目标相关性。代价是留出验证会减少训练样本,但这比通过反复观察测试集获得难以解释的零点几个AP更有研究价值。以上天文迁移未由本文验证。
可复用模块或设计思想
- 无参数置信度预算器。最值得复用的是
budget.py的compute_query_budget:输入形状为批次×候选×类别的logits及有效掩膜,输出每图整数预算。它将最大类别概率求和、乘安全系数、向上取整并裁剪,解决固定查询数无法兼顾稀疏和密集场景的问题。表5支持多种聚合方式均可工作;接入点在编码器候选产生后、Top-K初始化前。新增参数量为0,但仍要遍历候选分数,动态运行还可能增加同步成本。最小验证是冻结现有检测器,比较固定K与预算K的配对AP、长尾召回和毫秒延迟,再决定是否值得重训。 - 把预算匹配作为机制对照。这不是额外神经模块,而是表1–2和附录A的研究设计:同权重、近似匹配平均查询数量,并在密度分层内继续对照较大固定K,避免把“多给了槽位”误判成复杂筛选的贡献。官方实现的
_select_topk及BUTR解码器预算入口支持实现这种对照,仓库tools/diagnostics亦提供候选统计工具。它适用于两阶段、置信度排序的检测器;不应直接推广到没有编码器候选的所有模型。成本主要是重复前向评估,DDQ式训练期对照还需要额外训练。最低要求是同时报告平均预算和密集尾部,不能只匹配全数据均值。
四、跨论文结论与行动建议
FastPM优先精读,原因是它把低保真数据量、保真度和高保真适配成本放在同一实验框架下,能直接帮助设计仿真预算。BUTR优先作为方法与控制实验储备:代码可读性和接入路径较好,但训练协议应先整改,再判断小幅AP增益是否稳定。
两篇最大的单一问题影响不同:FastPM的跨模拟家族证据不足,限制科学外推,不否定同家族节省;BUTR的测试反馈参与选择,影响当前性能差值的解释,因而降低直接照搬复现配方的优先级。
可立即转化为小型研究设计的行动有三项:
- 固定独立高保真验证与测试资源,绘制同一概率评分下的“全部数据生成成本—性能”曲线,同时报告覆盖率,而非只比训练样本数。
- 冻结一个两阶段检测器,做固定K、动态K和匹配预算的选择规则对照;把实际延迟列为独立指标,不以FLOPs替代。
- 在所有自适应超参数和检查点选择中记录数据来源,先保证最终测试未参与选择,再分析稀有场景的收益。
暂时不应据此声称廉价模拟预训练已经解决真实巡天的模型系统误差,也不应声称无参数预算器普遍加速检测,或复杂查询选择在所有任务中都没有价值。两篇工作真正提供的是可检验的分解方式,而不是无需条件的性能保证。
本报告由 ChatGPT Dots 整理分析,博客作者对分析内容不负责且不代表博客作者本人的想法。