一、本期总体分析
arXiv 论文时间范围:[2026-10-26 05:01:07, 2026-10-27 05:01:07)(Asia/Singapore) 各分类篇数:astro-ph 112;cs.CV 205;cs.LG 321;cs.AI 321;stat.ML 60(含跨类,分类间可能重复) 入选篇数:1
本期聚焦一项实际的巡天扩展问题:已有单波段星系结构模型,怎样在不为整个样本重新运行昂贵拟合的情况下,补齐其他波段的结构参数,并给出可供科学分析使用的不确定性?Sarkar 等把 GaMPEN 迁移到 HSC 的新波段,贡献主要在大规模应用、标签构建和概率预测检验,而不是提出新的 骨干网络。
值得精读的是它把“拟合少量样本”“学习参数间协方差”“独立测试覆盖率”“主动舍弃失效波段”连成了一套具体流程。证据也有清晰边界:模型主要学习 GALFIT 所定义的结构参数,测试集经过拟合质量筛选;与这些标签一致,不等于对所有真实星系的物理结构都无偏。论文摘要所说的近千万星系,也不是近千万个对象都有完整三波段测量。
建议先读数据与训练的 §II–IV,再对照表 2、表 3 和图 12–16,最后读附录 A 的数据开放说明,预计投入 45–60 分钟。当前更适合借鉴方法和评价设计,不能把本次新增星表当成已经核实可下载的数据产品。
二、入选论文概览
| 阅读优先级 | 英文标题 | 论文类型 | 核心贡献 | 数据或基准 | 代码状态 | 适用研究场景 | 一句话判断 | arXiv 链接 |
|---|---|---|---|---|---|---|---|---|
| 优先精读 | Complete Multi-Band Structural Characterization for 10 Million Galaxies in the Hyper Suprime-Cam Wide Survey using Deep Learning | 天文交叉 | 跨波段迁移 GaMPEN,联合预测核球光占比、有效半径和流量的后验 | HSC-SSP PDR2;GALFIT 标签;两个外部结构星表 | 基础框架公开;本次新权重和星表按附录 A 尚待审稿结束后开放 | 多波段星系结构测量、少标签迁移、概率回归 | 学习的是有明确模型假设的结构测量,校准范围必须随标签选择一起解释 | 2610.32913v1 |
三、逐篇深度分析
GaMPEN:用少量跨波段拟合扩展星系结构后验
基本信息与研究定位
英文标题:Complete Multi-Band Structural Characterization for 10 Million Galaxies in the Hyper Suprime-Cam Wide Survey using Deep Learning。
作者:Milind Sarkar、Aritra Ghosh、Andrew Connolly、C. Megan Urry、Andrew Coli、Joshua S. Speagle、Rhythm Shimakawa、Charles Willard、Diego Lockyer。
版本与分类:arXiv:2610.32913v1,astro-ph.GA;首次提交为 2026-10-23 17:17:09 UTC,本版本无后续修订。摘要页注明已投稿 ApJ,不能据此视为已经同行评审。摘要页;HTML 正文;PDF;官方代码;项目文档。
适用研究场景:需要比较同一天体在不同波段中的核球显著程度、半光半径及总光度,或把已有图像回归模型扩展到新的观测条件。不同波段强调不同恒星族群与尘埃影响,结构随波长变化本身具有科学意义,不能把所有变化都当成需要消除的域偏移。
一句话结论:值得精读其少标签迁移与后验检验流程,但必须把“重现筛选后的 GALFIT 测量”与“恢复无模型依赖的真实结构”分开。
科学问题、样本与波段覆盖
预测量为核球占总光的比例
作者使用 Subaru 8.2 米望远镜 HSC-SSP PDR2 Wide 层的光学
样本要求对应波段星等小于 23,使用 extendedness_value 区分星系与恒星,剔除 cleanflags_any 标记的问题图像。约 3.1% 的对象有光谱红移,其余采用 Mizuki 测光红移,并要求 photoz_risk_best < 0.1。该量是红移可靠性筛选指标,不应等同于已测得的实际离群率。图像来自巡天合成图,作者把基础图像处理归于 HSC 管线;未逐项重新说明背景、消光、坏像素和 PSF 的全部处理,不能据此补写一条自定义预处理链。
表 1 的计数尤其需要分清:
- 合并旧工作后共有 9,587,923 个不同星系、18,141,936 次对象—波段测量,后者包含未计划发布的高红移
波段。 - 其中 8,005,645 次测量来自旧工作;新增 10,136,291 次,计划发布新增部分中的 9,252,759 次。
- 原始三波段共同样本为 2,237,300 个;去掉高红移
后,真正保留完整 的低、中红移对象为 1,622,931 个。 - 文中“约 390 万完整覆盖”实际是 3,945,048 个具有其红移段全部发布波段的对象,另含 2,322,117 个高红移、仅有
的对象,不能统称三波段完整样本。
还有一项外部一致性问题。本文 §II 将 PDR2 Wide 描述为约 1,400 平方度全滤镜全深度;但 PDR2 官方发布论文给出约 300 平方度达到五波段名义曝光、约 1,100 平方度至少有一个滤镜一次曝光。1,400 平方度与巡天总体设计相符,不能直接作为本文实际有效覆盖面积。本文未提供足以消除这一冲突的足迹核验材料;用于面密度或选择函数研究时,应等待对象表与天空掩膜,而不是直接用 1,400 作分母。
标签如何产生,训练和测试怎样划分
作者先做亮度分层抽样,避免真实样本中大量暗源淹没较少的亮源。低红移段按
标签不是人工形态分类,而是 GALFIT 的参数估计。Source Extractor 提供邻源分割掩膜与初始参数;GALFIT 用两个 Sérsic 分量拟合,盘固定
作者目视检查约 1,800 个拟合,主要剔除不合理轴比、核球与盘中心过度分离,以及大残差或数值问题。表 3 中低红移两波段剔除约 31%,中红移约 32%–36%,高红移 max_iters_flag 与较大约化卡方联合触发,不应改述成凡卡方大就一概删除。
清理后的每个组合按 70%/15%/15% 用于训练、验证和测试。旋转及水平、垂直翻转提供约六倍增强,但不增加独立天体数量。论文说明测试集不参与本轮训练与调参,然而没有给出按天空场区的独立测试,也未明确新测试对象与旧预训练样本是否对象级互斥;这属于尚未核实的隔离条件,不是已经证实泄漏。跨波段迁移的严格复现应保留对象 ID,使旧预训练、当前微调、验证和测试的交集可检查。
方法数据流:迁移的是测量模型,不只是一个点估计器
图像裁片按低、中、高红移采用约 vgg16_w_stn_oc_drp.py采用 VGG16,并由一个标量设置仿射矩阵的两个对角元素,也就是绕既定中心的等比例缩放,不应把该文件说成能自由平移、旋转的六参数变换。本次新权重尚未公开,无法进一步确认其与该基础实现的逐项对应。
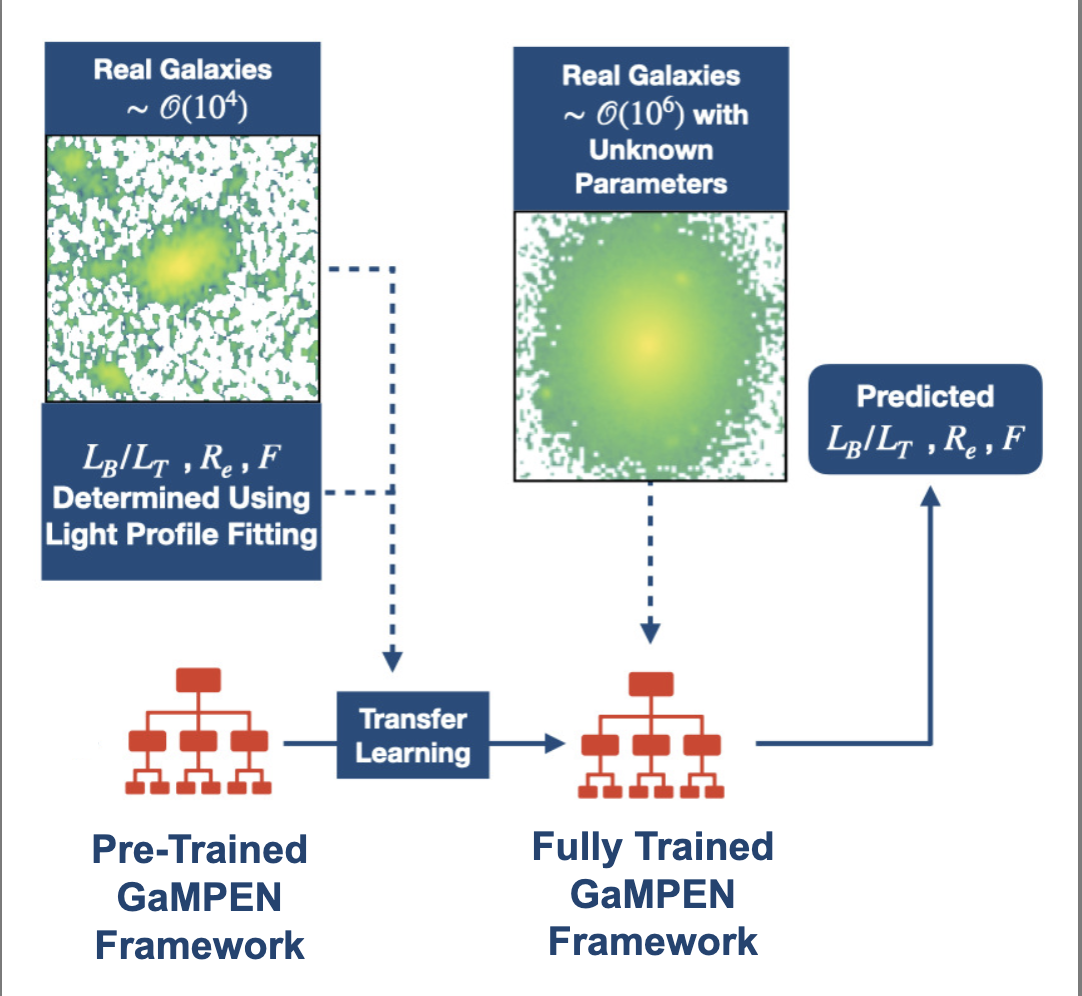
网络在变换后的空间预测三维高斯分布。目标先变成
再按训练集统计量标准化。反变换确保
核心损失是含完整协方差的高斯负对数似然,忽略与优化无关的常数可写为
这里 aleatoric_cov_loss.py通过
推断时继续开启 dropout,针对每张图做 500 次前向传播,并从各次预测的多元高斯抽样。高斯协方差表达数据条件下的随机不确定性,dropout 引入近似的模型不确定性;两者合成样本后,再反标准化和反变换。该近似不保证涵盖所有模型错设与域外偏差。作者用 KDE 形成边缘密度,报告众数和最高概率区间;联合分布则用于描述参数间相关性。图 11 的单个示例中,
微调从同一红移段的旧波段模型出发,不重新从模拟数据预训练。附录 D 给出的 SGD 动量均为 0.99、L2 系数为
实验结果:一致性成立,但校准不能只看平均数
作者在验证集上搜索 dropout,使预测区间对 GALFIT 标签的覆盖率接近名义水平,再在独立测试集报告表 2。这是合理的校准—评价分离,不能批评为直接在测试集上调 dropout。以下保留每个组合跨三个参数的平均覆盖率:
| 组合 | 名义 68.27% 区间 | 名义 95.45% 区间 | 名义 99.73% 区间 |
|---|---|---|---|
| 低红移 | 72.06% | 95.69% | 98.68% |
| 低红移 | 73.13% | 95.25% | 98.68% |
| 中红移 | 72.42% | 96.37% | 99.09% |
| 中红移 | 74.29% | 96.08% | 98.94% |
| 高红移 | 72.44% | 96.94% | 99.02% |
| 高红移 | 74.58% | 94.55% | 98.24% |
出处为表 2。它支持“大体校准”,不支持“每个参数和每个区间均精确校准”。常用 68.27% 区间偏宽,尾部区间仍有欠覆盖;高红移
图 12–13 显示多数波段的预测众数接近 GALFIT。作者给出的低红移
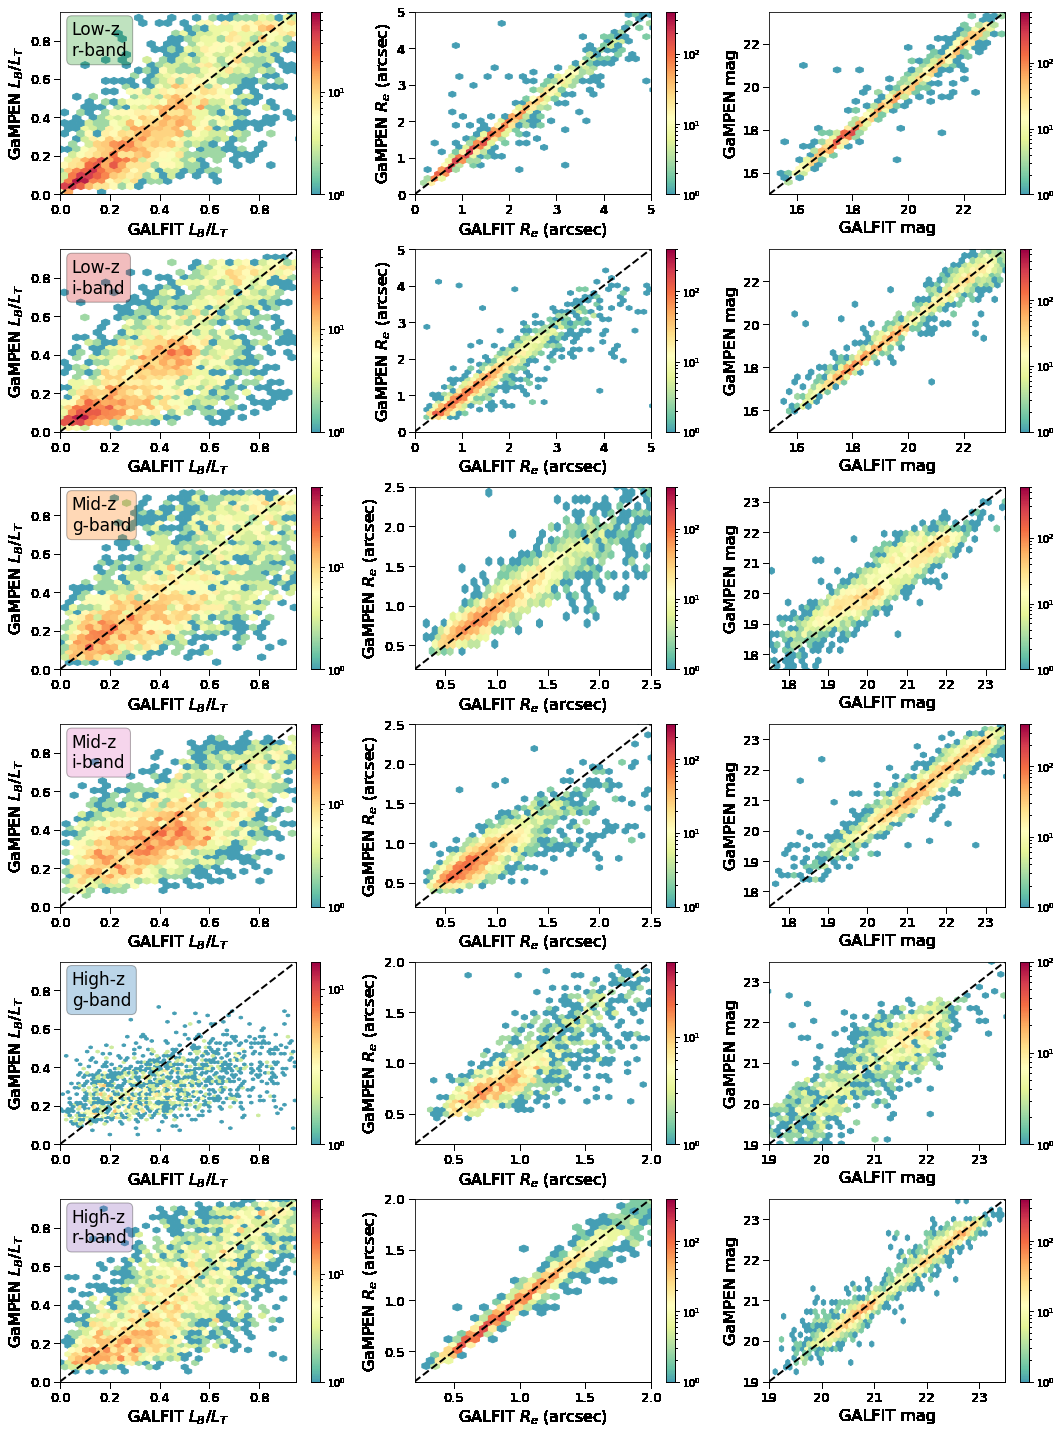
两个外部目录提供了额外支持,但不消除所有参考模型依赖。与 Simard 等的约 19,000 个共同对象比较,主要覆盖
论文没有在本次六个组合上提供完整的“从零训练/不微调/微调”匹配消融,也没有重新量化对角协方差与完整协方差的差距。因此,结果支持该迁移方案可用,但不能精确分解性能究竟来自初始化、样本构造还是概率头;“协方差必不可少”的因果证据仍主要依赖既有框架工作。
证据可信度:中等。同源独立测试、分参数覆盖率和外部目录比较使一致性结论较扎实;对整个巡天母样本的绝对校准、特殊形态及跨巡天迁移,证据则不足。
失效边界、代码与数据可用性
高红移
对于
截至 2026-10-27,官方 GitHub 可访问。论文附录 A 明确链接该仓库,官方性有直接依据。模型和协方差损失实现已核验;训练入口为 ggt/train/train.py,推断入口为 ggt/modules/inference.py,依赖与使用说明见 requirements.txt 及 Using_GaMPEN.md。这是实质性的既有代码,不是本次实验已经独立复现。
新数据尚不能按已发布使用。结论部分称公开新模型与目录,但附录 A 末尾明确说,新权重、形态目录、后验与光度拟合结果将在审稿完成后开放。核验时数据手册列出的仍是旧工作对应的三个红移—波段产品,未核实到本次新增产品。应保留这个文本冲突,以具体发布限制为准,不能拿旧目录冒充新增多波段目录。
还须区分“模型能生成”与“目录实际提供”:附录 A 计划发布每参数边缘 PDF,联合后验不包含在标准发布中,需向作者索取。若要传播
审稿人视角:最大问题与研究启发
最大的一个问题
最影响核心科学结论的单一限制,是校准评价以成功通过参数拟合质量筛选的样本为条件,却缺少对被筛掉母样本的同等级验证。
证据锚点是 §IV、表 3 与 §V.2:多数新组合先移除约三分之一拟合实例,随后训练和测试都从保留下来的集合中抽取。于是覆盖率更接近“在能被这个核球加盘模型合理描述的对象中,预测区间覆盖其拟合标签的比例”,而不是所有巡天星系的覆盖率。若困难的并合、团块或不规则目标更容易被剔除,在容易拟合的测试集上校准良好,不能排除它们应用时的系统偏差。这比某个单项平均误差偏高更重要,因为它决定整个概率解释可以推广到谁。
作者已经在 §IV 明确认可这一限制,并计划发布完整 GALFIT 结果及质量标记;高红移
最小关键补充应是一项预先固定的、按拟合质量分层的盲审测试:从通过和未通过原筛选的母样本中按亮度、角尺寸抽取对象,统一使用更深图像或独立拟合方案建立参考,并分别报告偏差、区间覆盖与拒绝预测比例。对确实没有稳定二分量解释的星系,应标记“不适用”,而不是强行赋予唯一真值。这个实验直接检验被选择掉的对象能否继续沿用概率解释,不需要先训练更大的模型。
研究启发与可执行验证
可复用的主要思想是:把标签生成、选择效应和概率预测作为同一个测量问题检查,而不只比较网络总误差。迁移到其他天文图像任务时,可先在原有预测上按亮度、半径与 PSF 的比值、拟合标记分层,同时画偏差和覆盖率;若某层失效,再判断是标签模型不适用、观测信息不足,还是网络泛化不足。这些解释需要不同的修正,不能统一用增强或换 骨干网络 代替。
实现上,完整协方差概率头和参数可逆变换最容易单独验证。以同一编码器、同一对象划分比较对角与完整协方差,除各参数 MAE 外,再检查联合概率评分和由参数组合得到的科学量误差。它额外引入协方差输出和数值稳定性要求;若只有边缘区间变好而联合推断没有改善,不能声称协方差已经提高科学可靠性。跨波段效果、最优 dropout 与 500 次抽样数量都需重新校准,而非照抄本文数字。
阅读路线:精读 §III.2–III.3 的变换与校准、§IV 与表 3 的标签选择、§V.2 与表 2 的独立测试,再看图 14–16 的条件失效。需要使用数据时,附录 A 的发布状态和联合后验限制应先于下载操作核实;需要实现时,结合官方损失文件阅读,不必先复刻千万对象推断。
四、跨论文结论与行动建议
本期只有一篇,优先级集中在测量定义和验证设计,而不是模型规模。最值得采用的是少量高质量拟合支持跨波段适配的流程,以及在失效区间明确限制输出用途的做法。
- 优先精读:表 3 与表 2 联读。先弄清测试样本是如何留下来的,再解释覆盖率。
- 可以立即设计的验证:在对象级隔离的数据上做固定配方的跨波段微调对照;对同一批预测同时检查亮度、角尺寸和拟合质量分层的误差与覆盖率;比较完整协方差与对角概率头对同一个派生科学量的误差传播。以上均为迁移建议,不是本文已验证的额外收益。
- 暂不应得出的结论:近千万对象均有完整三波段数据、新目录已可下载、平均覆盖接近名义值就意味着所有子群可靠,或邻近波段迁移已证明适用于其他巡天。
- 复现顺序:先用已公开框架做小样本验证,再等待并核对新增权重、目录、划分和足迹。本文最大的选择效应问题不会降低方法精读价值,却应降低直接将其全样本后验用于精密种群推断的优先级。
本报告由 ChatGPT Dots 整理分析,博客作者对分析内容不负责且不代表博客作者本人的想法。