一、本期总体分析
arXiv 论文时间范围:[2026-11-05 04:58:29, 2026-11-06 04:58:29)(Asia/Singapore) 各分类篇数:astro-ph 155;cs.CV 241;cs.LG 402;cs.AI 359;stat.ML 56(含跨类,分类间可能重复) 入选篇数:2
两篇工作都在处理一个常见问题:图像模型优化的目标未必就是天文学真正需要的量。PAU Survey 论文直接把孔径测光和重复曝光一致性写入去噪训练,适合先读,尤其适合关心低信噪比图像与测光误差的研究者。JWST 小红点论文则在训练时使用光谱约束图像表示,部署时只保留图像分支,适合关注多模态监督和稀有天体检索的读者。
前者在重复观测和下游光谱指数上给出较完整的诊断,但真实通量准确度仍需独立参考;后者给出了有光谱支持的新候选,但分类性能主要来自内部验证集,跨场区泛化尚待检验。建议先花约 30–45 分钟阅读前者的方法与结果,再用约 25–40 分钟阅读后者的数据、训练及验证部分。
二、入选论文概览
| 优先级 | 英文标题 | 论文类型 | 核心贡献 | 数据或基准 | 代码状态 | 适用研究场景 | 一句话判断 | 论文 |
|---|---|---|---|---|---|---|---|---|
| 1 | The PAU Survey: Self-supervised image denoising for flux-preserving photometry | 天文交叉 | 自监督去噪结合通量约束与重复曝光一致性 | PAUS COSMOS,NB645 及 40 个窄带 | 作者提供代码、权重及产品 | 低信噪比图像、窄带测光 | 诊断方法有价值,真实通量偏差仍需独立验证 | arXiv |
| 2 | Spectroscopy-informed Deep Learning Searches for Photometric Little Red Dots in JWST Surveys | 天文交叉 | 以图像—光谱对齐辅助仅图像推理 | JWST NIRCam、NIRSpec | 未能确认官方实现 | 光谱稀缺的图像分类和候选筛选 | 思路直接,独立场区验证是关键 | arXiv |
三、逐篇深度分析
1. PAUS:为自监督去噪加入测光约束
基本信息:J. Chen、M. Eriksen、D. Navarro-Gironés、P. Renard、E. Gaztanaga、J. Carretero、R. Casas、F. J. Castander、E. Fernandez、J. García-Bellido、R. Miquel、C. Padilla、E. Sánchez、I. Sevilla-Noarbe、P. Tallada-Crespí;arXiv:2611.05447v1;分类 astro-ph.IM、astro-ph.CO、astro-ph.GA;首次提交及本版更新日期均为 2026-11-03。 摘要|HTML 全文|PDF|作者代码。
适用研究场景:窄带或宽带巡天的低信噪比图像预处理,特别是最终需要保留通量、颜色或谱能量分布的任务。值得精读的不是某种更复杂的图像网络,而是作者如何把测光量接入损失,并检查视觉去噪是否改变科学测量。
问题、数据与测量
图像看起来平滑,并不保证孔径积分得到的通量更接近真实值。常规 Noise2Void(N2V)在没有干净图像标签时,通过遮挡像素并利用邻域预测其数值学习去噪;如果噪声与背景特征不满足理想假设,或者输出分布受到截断等处理影响,它仍可能改变星系光度。论文在模拟和真实 PAUS 图像中检查这一风险,并报告标准 N2V 对星系通量存在低估,暗源更明显(§3–4)。
观测数据来自 Physics of the Accelerating Universe Survey 的 PAUCam;论文使用 COSMOS 场 MEMBA v821 处理产品及 PAUS 类模拟图像。PAUS 40 个窄带覆盖约 450–850 nm。输入是经过巡天处理的图像,论文引用的处理包括偏置、平场、天体与测光标定及背景扣除;这不意味着文中独立重做或逐项验证了这些步骤。作者使用星表定义的固定孔径,估计包围约 62.5% 的源通量,背景环内外半径为 30 和 45 像素(§2.3)。因此报告的通量属于这一测量约定,不能直接当作总通量。
关键训练数据为 NB645 的约 3 万张 cutout、约 1.5 万对重复观测,并分别对亮源和暗源训练。§4.4 的多波段分析从可用测量中抽取 15%,以星系观测对构造训练和评价数据。作者说明评价曝光对未用于 LoRA 微调,但这一描述不足以单独证明同一天体的所有曝光均按对象完全隔离。对真实巡天应用,需进一步核对重复观测、天区及预处理参数是否跨集合共享。
方法:从像素重建到通量保持
数据流为:校准后的图像 cutout 输入 N2V 式 U-Net,模型生成去噪图像,再通过可微孔径测光得到通量;训练目标除去噪项外,还衡量去噪前后测光偏差和重复曝光间的一致性。作者先限制输出的负值范围,缓解标准 N2V 的系统性通量低估;再冻结基础去噪器,利用低秩适配(LoRA)调整少量参数。LoRA 阶段的两个测光项分别约束输出与输入的通量尺度,以及同一目标不同曝光的通量差(§3.4–3.5)。
这两个约束解决不同问题:前者防止模型为了平滑而随意改变平均尺度;后者利用独立曝光对压低重复测量之间的波动。它们不是对真实通量的直接监督,因为原始图像仍然有噪声。作者报告在 V100 上进行 200 轮 LoRA 微调约需三小时;这是论文的训练记录,不能代表其他数据或硬件的运行成本。
实验结果与证据评价
论文先用 PAUS 类模拟检查图像质量与通量偏差,再在真实巡天图像上检验通量分布、重复曝光和下游科学量。§4.3 的 NB645 结果中,以原始 PAUS 误差为共同尺度归一化的重复曝光通量差,其
在 §4.5,作者分析 5,664 个具有完整 40 波段测量、光谱红移为 0.562–0.967 的星系,这些对象不在 LoRA 微调样本中。使用原测光误差作为波段权重,去噪后的 D4000 分布中位数约下降 7%;逐对象的去噪前后 D4000 比值中位数为 0.958。两种统计量的定义不同,不能把 0.958 直接等同于总体中位数下降比例。论文还报告蓝至红不同波段的通量比存在变化,说明单波段整体通量保持并不能自动保证颜色或光谱指数保持。
对“该方法能改善本数据上的重复观测一致性”,证据可信度为中:有真实重复曝光及多波段诊断,但独立真值不足;对“输出足以无偏替代真实巡天测光”,证据仍不足。模拟使用的背景条件较简化,真实图像中的空间相关噪声、邻源、背景残差和形态依赖值得进一步检查。论文公开 PAUS 数据入口、代码及权重和中间产品;这些资源有助于复现,本文没有实际重新训练或验证其可用性。
审稿人视角:最大问题与研究启发
最大的一个问题:现有核心验证主要依赖带噪观测本身,尚不能判定去噪后的通量是否更接近独立真值。§3.5 的通量损失以原始测量和重复曝光为约束,§4.3 的差值宽度能证明一致性改善,却不能排除共同偏差或收缩;§4.5 的 D4000 变化又表明跨波段相对通量可能改变。相比单独讨论网络结构,这一限制更直接影响论文的科学测光主张。
最小补充实验是在未参与训练的场区进行盲注源,或使用更深的独立曝光作为参考,按亮度、表面亮度、波段及邻源距离报告通量偏差、散度和不确定度覆盖率,并比较原始测光、标准 N2V 与完整方法。作者已讨论有噪参考及模拟背景的限制;这些讨论降低了误读风险,但不能替代独立参考。该问题限制的是准确度和泛化范围,并不推翻重复曝光一致性改善的观测结果。
研究启发与可执行验证:图像复原任务应把下游物理量纳入验证,而不只比较视觉质量。可先固定对象级和场区级划分,在同一测光管线中比较原图、去噪图及注源真值;再分别移除通量项和重复曝光项,检查两者对颜色、孔径通量和误差覆盖的作用。此建议适用于存在重复曝光或可信模拟的数据,计算成本及对其他巡天的收益均需实测。
阅读路线:精读 §2.3–2.4、§3.4–3.5、§4.3–4.5 和附录 C;先看重复曝光诊断,再看不同波段与 D4000 的结果。具体图表可在论文正文对应章节查看。
2. JWST:用光谱指导图像模型寻找小红点
基本信息:Chenxuan Zhang、Huanian Zhang、Qingwen Wu;arXiv:2611.06026v1;分类 astro-ph.GA;首次提交及本版更新日期均为 2026-11-04。 摘要|HTML 全文|PDF。未能从已检查材料确认官方代码仓库,不能假定该模型可直接复现。
适用研究场景:训练阶段有部分配对光谱,而大规模应用阶段只有多波段图像的稀有源分类。论文值得精读,但内部验证的高 AUC 不能代替独立巡天上的完备率与纯度评估。
科学问题与样本
Little Red Dots(LRDs,小红点)是 JWST 发现的一类紧致、高红移红色源,常见 V 形光谱能量分布;一些源的宽发射线支持活动星系核解释,但不同目标的物理性质仍需光谱研究。颜色筛选依赖具体阈值,可能遗漏分布边缘的对象。论文希望把配对光谱提供的判别信息用于训练图像编码器,之后仅凭 NIRCam 图像提出候选,而非用图像直接证明其物理本性。
论文整合已有光谱确认的小红点、高红移非 LRD 星系、高红移静寂星系和棕矮星等样本(§II)。共有 127 个已标记正例;分层后训练集 6,079 个源,其中 102 个正例;验证集 1,462 个源,其中 25 个正例。负类包含不同来源对象,且未确认的真 LRD 不一定能完全排除,因此“标记负例”不能无条件等同于物理上确定的非 LRD。目标选择和光谱可用性也影响样本代表性。
图像来自 JWST NIRCam,采用 F115W、F150W、F200W、F277W、F356W、F410M、F444W 七个通道,覆盖约 1–5 微米;cutout 为
数据流与训练
图像经过共同的尺度归一化和
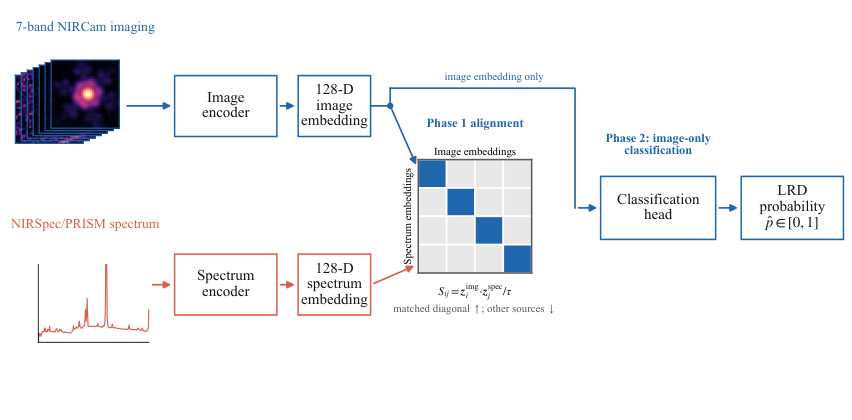
训练分两阶段。第一阶段,配对图像与光谱通过双向 InfoNCE 对比损失对齐,匹配样本的相似度被提高,批次内不匹配样本作为对照;分类头冻结。第二阶段冻结编码器,只训练图像分类头,目标为 focal loss 加权排序损失,排序项权重 0.2。推理时丢弃光谱编码器,仅使用图像分支及分类头。训练增强包括翻转、旋转、中心外遮挡、通量扰动、噪声和随机波段丢弃;光谱增强包括按不确定度加噪、波长位置小幅移动和连续波段遮挡。
两阶段均使用 AdamW、学习率
性能、候选与边界
在内部验证集的 25 个已标记正例中,该阈值识别出 23 个,同时有 6 个标记负例被判为正;作者报告 precision 0.79、recall 0.92、AUC 0.998。图像单模态对照的召回率为 0.84(§V.1)。这些是用于模型选择的内部验证结果,样本尤其是正类较少,不能称为独立测试集表现,也不能直接视为全体候选的纯度或完备率。AUC 高并不消除阈值选择、样本构造及场区相关性的影响。
模型还在先前归为非 LRD 的光谱样本中提出 35 个候选;其中 13 个有中高分辨率 NIRSpec 光栅光谱,10 个显示宽 Hα。作者在 Dawn JWST Archive 图像及另外两项 JWST 成像巡天中分别报告 357 和 23 个额外候选(§V.3–V.5)。这些对象需要后续光谱和选择函数分析,不能把候选数当成确认数;13 个光谱可复核对象也不是对全部候选进行无偏抽样。
“配对光谱监督可帮助构造可用的图像分类器”有中等偏低的证据:文中有单模态对照和真实候选的光谱线索,但缺少独立场区、代表性标注及不确定度充分估计。尤其是缺测波段的零填充可能暴露观测项目或覆盖模式,模型是否使用了这类信息需要控制实验;这是一项待验证风险,不能据此声称模型已经使用了捷径。光谱与图像对齐也不自动证明模型学到了可解释的光谱物理机制。
审稿人视角:最大问题与研究启发
最大的一个问题:核心分类性能没有由独立场区、具有代表性标签的测试集确认。§IV.3 的分层划分和 §V.1 的 25 个验证正例支持内部比较,但同源观测与模型选择难以衡量面对新场区、不同深度和不同波段覆盖时的变化。它比单纯增加一次模型消融更关键,因为论文的实际用途是从其他图像中筛选候选;性能若不能迁移,新增候选的数量便不能直接转化为可靠的科学样本。
最直接的验证是预先固定一个独立观测场区,冻结模型和阈值,按可获得光谱的目标选择规则建立测试样本,报告召回率、精确率及置信区间,并按星等、红移和波段覆盖分层。需要同时说明未获得光谱的对象如何影响结论。作者在 §VI.3 承认样本和选择偏差及后续光谱确认的必要性;当前补充候选的光谱证据有价值,但仍不足以估计完整独立样本中的普适性能。这一限制不否定它发现值得跟进候选的能力。
研究启发与可执行验证:训练时使用丰富模态、部署时仅用常见模态,是处理光谱稀缺的一种可检验设计。可在同一对象和场区划分下比较图像单模态、配对对比学习及随机配对对照;再按信噪比、缺失波段和观测项目分层报告性能与校准。迁移时需要足够可靠的配对关系,额外光谱选择偏差和训练成本可能抵消收益,实际效果必须独立测量。
阅读路线:精读 §II–IV 的样本构建、数据和两阶段训练,以及 §V.1、V.3 和 VI.3;附录 A 可检查候选光谱。原文中候选及验证图表见官方全文。
四、跨论文结论与行动建议
- 优先阅读 PAUS 论文:它直接展示图像处理如何改变科学测量,并给出重复曝光及多波段诊断。小红点论文可作为训练期多模态监督的补充阅读。
- 可先建立对象级、场区级隔离的数据划分;对去噪结果使用注源或独立深曝光测试通量偏差,再检查颜色和下游参数。
- 对多模态模型,在相同划分和计算预算下加入单模态、配对打乱与缺失波段对照,并用独立场区评估置信区间及校准。
- 暂不应将重复曝光散度下降等同于对真实通量误差的同等下降,也不应将内部验证集的分类指标用于估计全部新候选的纯度。
- 两篇论文各自的主要限制分别是缺少独立通量真值与缺少代表性的独立场区测试;前者影响测光准确度判断,后者影响实际筛选的泛化判断。二者都适合作为实验设计参考,均不应直接视为已通过同行评审的最终结论。
本报告由 ChatGPT Dots 整理分析,博客作者对分析内容不负责且不代表博客作者本人的想法。