一、本期总体分析
arXiv 论文时间范围:[2026-10-12 05:03:55, 2026-10-13 05:03:55)(Asia/Singapore) 各分类篇数:astro-ph 117;cs.CV 237;cs.LG 413;cs.AI 313;stat.ML 65(含跨类,分类间可能重复) 入选篇数:2
本期两篇论文都把额外结构引入学习过程,但解决的问题不同。The Fast & Fourier 用便宜的解析物理量帮助神经算子学习昂贵的辐射转移,随后保留显式似然和贝叶斯采样;JMT-YOLO 用像素级分割监督和遮挡一致性约束,改善检测器在目标域中的表征。前者值得优先精读其“模拟、代理模型、后验验证”的完整流程,后者适合作为跨域检测的实现储备。
两篇的证据也需要分开理解。第一篇的消融、逐波段误差和合成后验检验较完整,但高光学深度下的模拟参考本身可能未收敛,代码与训练网格尚未公开。第二篇有可训练、可评估的官方实现,工程入口较清楚;然而新增像素标注与新增模块同时出现,当前消融不足以完全分离两者的贡献。可以借鉴它们如何构造监督,也应把“监督是否可信、比较是否等信息量”放在模型结构之前。
建议先用约 45–60 分钟阅读第一篇的方法、表 2/7 与第 6.4 节,再用约 30–45 分钟对照第二篇第 3 节、表 4–6 和训练代码。预计投入是阅读建议,不包含复现实验。
二、入选论文概览
| 优先级 | 英文标题 | 论文类型 | 核心贡献 | 数据或基准 | 代码状态 | 适用研究场景 | 一句话判断 | arXiv |
|---|---|---|---|---|---|---|---|---|
| 1 | The Fast & Fourier: Using neural operators to speed up radiative modeling of protoplanetary disks | 天文交叉 | 物理输入嵌入、混合分辨率 FNO 与显式似然后验推断 | RADMC-3D 模拟;ESO-Hα 569、HH 48 NE 测光 | 作者明确暂不公开模拟器、训练数据与代理代码 | 昂贵前向模型、光谱模拟、概率物理参数反演 | 方法闭环值得精读,不能把同源模拟校准当作真实物理无偏保证 | 2610.12632v1 |
| 2 | JMT-YOLO: Multi-task Domain Adaptation via Segmentation-Guided Consistency Learning | 纯 CV 检测 | 多尺度分割辅助头与 teacher–student 遮挡一致性 | VOC→Clipart1k;Cityscapes→Foggy;KITTI→Cityscapes | 官方核心实现、训练、评估与配置均可访问 | 有源域标注、无目标域检测标注的跨域目标检测 | 可复用训练思想,性能增量须在等标注预算下重新验证 | 2610.12901v1 |
三、逐篇深度分析
1. The Fast & Fourier:把昂贵光谱模拟变成可反复调用的前向模型
基本信息:Lukas Welzel、Melissa K. McClure;arXiv:2610.12632v1;分类 astro-ph.EP、astro-ph.IM、astro-ph.SR;首次提交及本版本日期为 2026-10-08 18:55:11 UTC。官方摘要页注明“Accepted for publication in A&A”,本文依据 arXiv v1 分析,不将它当作已核对的期刊排版终稿。摘要页|HTML 全文|PDF。全文 Data availability 明确模拟器、训练数据和代理代码暂属非公开资料,尚未提供可直接复现的官方项目包。
适用研究场景:任何需要反复调用昂贵物理模拟、再从观测反演参数的任务,都可以参考本文怎样组织代理误差与后验检验。这里的模型输入是物理参数和解析物理场,输出是光谱;它不是直接将观测光谱回归成参数的网络。
一句话结论:值得精读,最有价值的是将解析物理、神经算子和显式统计推断分开设计,并用独立模拟点检查它们拼接后的后验是否可靠。
科学问题与数据:冰吸收深度不能直接翻译成冰丰度
近侧向原行星盘的中平面遮住中央恒星,观测到的红外辐射经过多条散射路径,不同光子穿过的冰柱密度不同。吸收带深度会随真实冰柱密度非线性增长并趋于饱和;盘质量、倾角、尘埃沉降和粒径改变散射与遮挡,也会改变谱带形状。因此,仅拟合吸收深度难以分离几何效应和丰度变化。作者需要包含多次各向异性散射的辐射转移模型,而完整后验通常要求大量前向计算。第 1、3.1 节
训练集来自 RADMC-3D 数值模拟,不是巡天观测样本。盘模型采用轴对称密度参数化,包含大小两类尘埃、内腔、H₂O/CO₂/CO 冰及中央恒星照明。温度先在无冰条件下求解,再放置冰并重新计算;随后得到光学至毫米波段的谱。气尘质量比固定为 100,大颗粒最大粒径固定为 1000 μm,冰的垂直边界固定为
参数通过扰乱的 Sobol 序列覆盖先验范围。最初计算 43,008 个模型,低、中、高分辨率分别使用 21、42、103 个波长点,覆盖 0.55–2830 μm;高分辨率在冰和硅酸盐特征附近加密。低分辨率占原始网格 76.19%,高分辨率仅占 4.76%。剔除超时、计算一致性错误及谱形被噪声主导等情况后,保留 41,658 个模型,总成本约 120 CPU 年。附录 A 给出了一个明确的谱质量规则:近、中红外相邻点的平均绝对对数通量差若超过全谱对数通量范围的 0.68 倍,则拒绝该谱。这意味着样本已经过数值可用性选择,不能假设它仍对先验空间完全均匀。表 4、附录 A
数据随机划为 70% 训练、20% 验证、10% 测试,归一化只在训练部分拟合。这样的测试能评估同一模拟器、同一物理假设下的插值,不等于跨模拟代码或真实观测的域外验证。论文未报告独立空间区域、巡天或真实天体构成的训练测试划分,因为网络训练对象本来就是模拟模型。
真实应用是 ESO-Hα 569 的历史宽带 SED,并以 HH 48 NE 为额外参考。表 1 汇集光学、近红外、WISE/Spitzer、Herschel 及毫米测光,并加入 ALMA 890 μm 与 1330 μm 资料。四个 160–500 μm Herschel 弱检测可能受云背景污染,仅画作上限,不进入似然;1330 μm 测量发表于分析之后,也未用于拟合。这里使用的是目标测光汇编,不是一次统一巡天的新发布数据;不存在可由本文概括为全天覆盖的选源函数。原始测光校准沿用引用文献,本文不重新处理所有曝光图像。模拟只使用谱,因此没有施加图像 PSF 卷积。第 2 节、表 1
方法数据流:参数先变成有物理含义的输入场
第一步是统一数值尺度。跨度大的物理参数取对数,再用训练集均值和标准差标准化;波长以对数坐标表示。通量的对数使用训练集全部谱点共有的一组均值和标准差,而非每个波长各自归一化,因为混合分辨率网格并不在每个位置都具有同样的样本。
第二步构造三组条件输入。全局参数沿波长方向广播,并乘以正弦坐标嵌入,让一个标量能够影响不同尺度的谱结构。恒星黑体谱本来就是波长函数,可以直接作为输入通道。粒径分布、径向密度与几何投影却定义在其他坐标上,作者分别用浅层 FNO 编码器将它们映射成波长域的潜在通道,再拼接送入主网络。解析量由同一组参数计算,不包含额外观测信息;它们的作用是减少网络重新学习已知关系的负担。第 3.3.2 节、附录 B 式 3–5
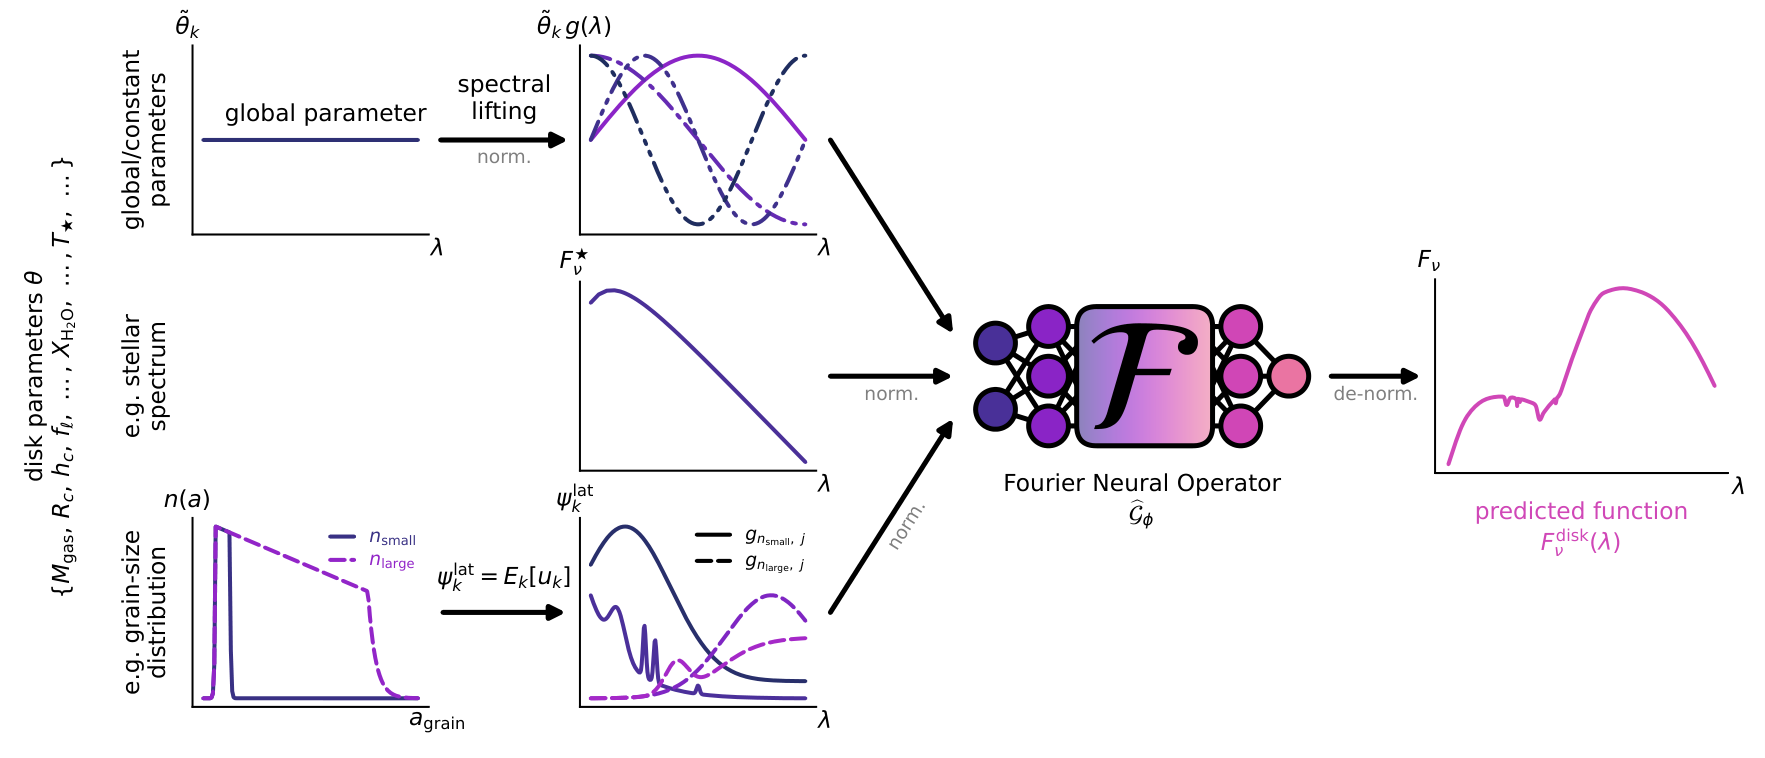
主 FNO 结合傅里叶域的全局卷积与局部非线性混合,用 8 层、64 个隐藏通道和 12 个傅里叶模式处理谱。有限区间补边缓解非周期谱的边界伪影,GroupNorm 用于稳定训练。最后另接固定、可微的前景消光模块,并在推断时应用距离平方反比缩放。消光规律可替换而不必重训辐射转移网络,但这种可替换性不意味着所有盘物理假设都可以任意更改。
第三步处理不等分辨率监督。傅里叶层工作在均匀内部坐标上,通过预设单调映射对应非均匀波长网格;样本未计算的波长被掩膜,不进入损失。论文式 1 同时约束对数通量的
这种处理值得借鉴,但“任意波长查询”需要限定:它是对已学函数重新取样,不会凭空恢复训练网格未解析的窄线。作者在第 6.3 节明确承认模式截断、混叠和低分辨率样本占多数的问题。
从代理谱到后验:保留测量误差,也要计入模型误差
作者用 UltraNest 在 18 个物理参数之外联合采样距离与消光,共 20 维。似然在通量空间假设各波段独立高斯误差,并将代理误差加入方差:
这里的误差系数由测试集逐波长 RMS 的中位数校准,不能直接拿摘要的 4.84% 每谱误差中位数代替,二者聚合方向不同。作者忽略波段协方差,并使用常数相对误差,等于在所有波长上给出同一比例的容差。由于冰带误差大于连续谱,这种模型会高估部分连续谱误差、低估冰带误差;论文已经在第 6.3 节承认这一点。网络支持 MC dropout 不等于其预测方差已经进入似然,本文没有这样做。第 3.4、6.3 节
实验结果:总体误差、谱带误差与反演误差必须分开
| 检验 | 正文结果 | 可以支持的判断 |
|---|---|---|
| 测试集每谱相对 RMS | 中位数 4.84%,均值 6.88%;最差 5% 的阈值为 18.79% | 典型谱拟合较好,但误差长尾不可忽略 |
| 对数波长均匀重采样后的冰带误差 | 均值 13.34%,中位数 12.62% | 决定丰度的特征区域明显比全谱摘要困难 |
| 表 7:仅保留参数的谱坐标嵌入 | 6.09% | 解析物理输入组合具有增益 |
| 表 7:移除视角嵌入/移除 | 5.35%/5.22% | 几何条件与谱形监督均有贡献 |
| 表 7:MLP/DeepONet | 18.77%/12.86% | 在该实现和配方下 FNO 更有效 |
| 两组合成反演,各 512 个样本 | TARP 曲线面积偏差 ATC 为 0.0111、0.0136 | 在作者的同源模拟与误差模型下未发现显著失准 |
这些数值分别来自表 2、表 7 与图 6,不能相互替换。MLP 和 DeepONet 匹配了数据划分、归一化、复合损失、优化器及近似参数量,但未进行各自专门的超参数搜索;FNO 则进行了搜索。因此,表 7 支持当前实现的优势,尚不足以证明所有充分调优的同容量替代模型都会落后。附录 C
合成推断一组使用最高分辨率网格加 1% 相对高斯观测噪声,另一组模拟 ESO-Hα 569 的波长和误差配置。热结构明显未收敛的 9 个样本被检查后重抽。这项检验覆盖的是清理后的同源分布。所谓“高分辨率”最高仅约
ESO-Hα 569 的质量后验为
计算成本需要同时报告一次性和边际两部分。约 40 万参数的代理在 RTX 5090 上训练约 8 小时,使用 AdamW、初始学习率
证据评价与阅读路线
对“在规定先验内快速模拟这一类 RADMC-3D 谱”的可信度为中高:有留出测试、架构消融、分波段误差和合成后验检验。对“真实目标冰丰度已经精确、无偏”的支持较低,论文自己也没有给出这样的结论。非公开训练网格使外部复现成本很高;披露使用哪些通用库,不等于已经开放关键数据与实现。
优先精读第 3.3 节、表 2/7、图 6 和第 6.4 节;附录 B 用来理解物理嵌入,附录 E 用来理解后验检验。对机器学习研究而言,第 6.4 节比摘要中的巨大加速倍数更值得停下来核查。
审稿人视角:最大问题与研究启发
最大的一个问题
最影响物理推断可信度的根因,是最难参数区间的训练与检验参考尚未建立充分的数值收敛保证。 第 6.4 节承认,极高光学深度盘的热蒙特卡洛阶段可能让深层网格得不到光子,且平滑的有限光子偏差可以被代理一并学习。图 9 中更平滑的谱因此不能自动解释为更正确的谱。
作者并未回避问题:他们给一个热阶段已收敛的长尾模型增加光子数,图 10/11 显示,在 2.5–17.5 μm 相对最高光子数参考计算时,训练光子数对应的模拟 RMS 约 23%,代理约 17%,支持代理减少了一部分随机噪声。但这只是一个模型,且参考计算仍有有限精度;它不能覆盖热阶段本身未收敛的最极端情况。这个问题比单一平均误差高低更重要,因为监督目标若有系统性偏差,模型可以同时取得漂亮的同源预测和同源覆盖率,却保留错误的物理关系。
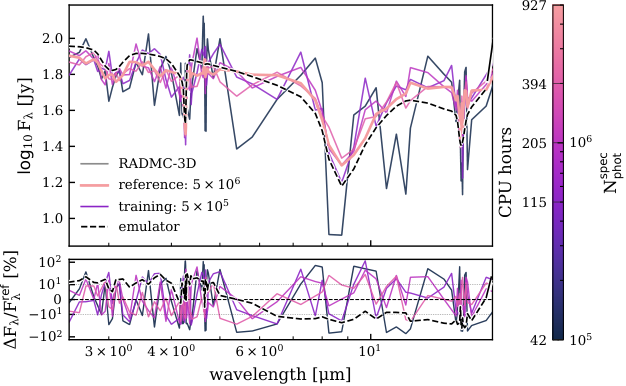
最小而关键的修正,是从真实目标后验的高概率区域及高不透明度长尾各取少量点,先检查热结构收敛,再进行独立随机种子和逐级光子数收敛计算,用这些未参与训练的高保真谱检验代理偏差以及后验位置是否改变。这不是要求重算整个网格,而是验证最可能改变科学结论的区域。当前限制不会推翻代理加速的价值,但会限制其物理推断的可靠范围。
研究启发与可执行验证
最值得借鉴的是:把标签生成过程也纳入误差预算。迁移到其他天文光谱或图像模拟时,可以先做一个小规模、多随机种子的参考集,把模拟噪声、代理逼近误差和观测噪声分别记录。若高保真参考改变了网络的系统残差,应优先修正训练目标;若只是随机散布下降,再考虑谱形正则化是否确实有效。
另一个可执行方向是比较常数误差膨胀与按波段校准的误差模型,但只在独立校准集上估计,再保留新的合成样本做最终覆盖率测试。成本是额外模拟与协方差估计,收益尚需验证。物理嵌入适合解析变换便宜且可信的场景;对缺乏可信物理先验的任务,不能把任意手工特征包装成同等强度的归纳偏置。
2. JMT-YOLO:辅助分割如何参与跨域检测训练
基本信息:Zhenhua Yu、Jiahao Zhang、Wenchao Zhang、Ou Ye、Hengxiang Zhao;arXiv:2610.12901v1;分类 cs.CV;首次提交及本版本日期为 2026-10-09 02:47:52 UTC。摘要页|HTML 全文|PDF|官方代码。未从摘要页核实接收或正式发表记录,以下按预印本评价。
适用研究场景:源域有目标框及部分分割监督、目标域可以取得未标注图像,且外观变化比对象语义变化更显著的检测任务。它适用于领域适应,不是训练后完全不接触目标域数据的域泛化。
一句话结论:适合作为辅助结构监督的实现储备;应优先验证简单分割辅助头是否已经带来相同收益,再决定是否移植 DenseRFB 与完整训练组合。
问题设定与完整数据流
作者针对两类不足:风格迁移可以拉近全局外观,却不一定保留细粒度边界;全局特征对齐也不必然让每个对象的特征对齐。方法建立在 SSDA-YOLO 和 Mean Teacher 之上,而不是重新提出一个从零开始的检测器。
源域图像首先通过预训练 CUT 风格迁移得到目标风格图像,目标域图像反向转换成源风格图像。源图及其风格变体共享目标框和源域分割标签。目标图没有检测真值,teacher 在源风格目标图上生成伪标签,student 学习原始目标图,同时还学习其随机遮挡版本。前提是风格迁移不改变空间语义;正文可视化提供了示例,但没有系统量化所有翻译图的几何或标注保持误差。第 3.1–3.2 节、图 1
共享网络是 YOLOv5-L。官方配置使用 Focus 起始层,随后以卷积、C3 和 SPP 形成分辨率逐级降低的特征,再经 FPN–PAN 自顶向下与自底向上的融合。按已核验 YAML 的通道与步长,960×960 输入对应主检测输出的 120×120、60×60、30×30 三个尺度,通道分别为 256、512、1024;这些尺寸是由配置推导,非新增实验结果。检测分支保留分类、目标置信度和框回归,训练时使用源域真实框与目标域筛选后的伪框,推断时进行 NMS。
辅助分割头先将不同尺度的输入压到相同通道数,上采样到 1/8 分辨率后拼接,再进入 DenseRFB。要注意实现细节:论文将它概括为接收 neck 的多尺度特征,实际 yolov5l_city_seg.yaml 中分割头接的是层 16/19/22,而检测头接的是层 17/20/23;复制实现时不要把两个分支的连接点想当然地写成完全一样。模型配置
DenseRFB 将 1×1/3×3 主分支与膨胀率 2、3 的卷积分支串成带密集信息传递的结构。后续分支除自身输入外,还接收先前分支输出;另有一个 1×1 直接分支,最后拼接并压缩通道。作者明确希望同时保留局部细节与更大范围上下文,让分割监督引导共享特征关注对象结构。该动机合理,但“从结构监督获得收益”与“该特定密集连接最优”是不同主张,需要不同对照。第 3.3 节、式 8–15
一致性损失真正约束了什么
源域原图与风格转换图都计算检测损失和 Dice 分割损失。源域一致性项约束两种输入的检测损失差异,不能直接把它等同于逐实例特征距离。teacher 参数由 student 的指数移动平均更新,EMA 系数为 0.99。目标框先按置信度 0.8 筛选,再以 IoU 0.3 做 NMS,然后作为 student 的硬伪标签。
分割分支则用 teacher 的类别概率作软监督,让遮挡目标图的 student 输出接近未遮挡、源风格目标图的 teacher 输出。直观上,它要求网络利用周边结构预测被遮住区域,而不是只依赖局部纹理。不过这并不保证 teacher 的错误消失;稳定而错误的伪分割也会被传给 student。
论文式 18 写成每像素类别交叉熵,总损失以检测与分割权重组合。官方 train.py 的具体实现对像素和类别总元素数一起归一化,且直接在整张输出概率图上计算,并没有额外仅选择被遮挡像素的索引。因而正文“masked regions”的说法不宜理解成损失只作用于遮挡位置。改变分割类别数时,代码中的归一化还会改变该项相对尺度,迁移时需检查权重。训练实现
数据、训练配方与结果
论文使用 VOC→Clipart1k、Cityscapes→Foggy Cityscapes 和 KITTI→Cityscapes 三组设置。Cityscapes 为 2975 张训练、500 张验证;Clipart1k 为 500/500;KITTI 检测部分使用 4717/520,另称像素标注子集为 140 张训练、60 张验证。VOC 检测划分报 8218/8333。正文在 KITTI 主结果及表 5 又用“200 GT masks”描述有限标注方案,与此前 140/60 的训练验证表述需要对应澄清;目前不能把 200 全部当作已确认的训练掩膜数。第 4.2–4.4 节
默认输入 960×960,SGD 初始学习率 0.003、momentum 0.937、weight decay 0.0005、batch size 2;普通设置训练 200 epochs,跨相机设置 50 epochs。硬件是单张 RTX 3090 24 GB,软件为 Ubuntu 20.04、Python 3.8、PyTorch 1.10.0、CUDA 11.1。README 给出了从 weights/yolov5l.pt 开始的命令,源权重、CUT 翻译数据及分割掩膜均需准备。论文未完整报告学习率时序、全部数据增强开关、各模型训练种子与重复次数,复现时应记录实际配置,不能只照着几项主超参数声称同设置。
| 任务/指标 | Source Only | SSDA-YOLO | JMT-YOLO | 对 SSDA-YOLO 的变化 |
|---|---|---|---|---|
| VOC→Clipart1k,[email protected] | 27.5 | 44.3 | 46.9 | +2.6 个百分点 |
| Cityscapes→Foggy,[email protected] | 35.9 | 55.9 | 57.3 | +1.4 个百分点 |
| KITTI→Cityscapes,仅 car [email protected] | 58.3 | 59.6 | 61.0 | +1.4 个百分点 |
结果来自表 1–3。第三行不能写成全部类别 mAP,且 61.0 低于同表 VT 的 61.9,故摘要对现有方法的概括不应扩写为“三个基准全部最优”。VOC 的监督 Oracle 为 45.8,低于方法的 46.9,也不意味着突破任何理论上限:Oracle 与适应模型的训练数据组成不同,源域数据仍可能有帮助。
表 4 的 Foggy 消融更能反映真实增量:基线 55.9,加入遮挡为 56.8,加入 DenseRFB 分割辅助为 57.2,两者组合为 57.3。完整方法相对 source-only 的 21.4 个百分点中,已有基线贡献了 20.0 个百分点;而在已带辅助分割的模型上加遮挡,仅增加 0.1 个百分点。论文称组合具有加性增强,但这些点估计既不呈简单相加,也没有重复实验误差支持 0.1 点是稳定提升。Grad-CAM 和 t-SNE 可以辅助定位现象,不能替代这项稳定性检验。
遮挡比例在 0.1–0.6 之间效果相对平稳,达到或超过 0.7 后明显变差;默认取 0.6。检测/分割权重取 0.6/0.4,在对应消融中为 57.3;把分割权重提高至 0.8 时降到 50.2。这说明辅助任务不是越强越好。全文将目标域验证集用于结果报告,同时展示在该设置下选超参数的消融;未见另一个独立最终评估集的清楚说明,因此结果应按其报告协议理解,不能自动当作完全未参与选择的测试成绩。
KITTI 的补充实验用 SAM 生成掩膜:真实框提示得到 62.0 [email protected] 与 32.4 AP@[.5:.95],自动框提示为 61.7/32.3,文本提示为 60.9/31.1。对真实框中心施加较大偏移后收益消退,70% 偏移下为 58.6/28.6,低于基线 59.6/29.8。它证明了监督质量对结果有实质影响;但文本提示所依赖的完整 SAM 变体或连接方案不能仅凭名称推断,复用前还需对应实现。正文未给新增分支完整的参数量、FLOPs、训练峰值显存或端到端延迟表,不能因基座是 YOLO 就保证所有新增流程仍满足某个实时预算。
开源代码核验卡
核验日期为 2026-10-13(Asia/Singapore),官方依据是 arXiv HTML 摘要直接链接该仓库。核验时 main 指向 801be1650fd70089c9dada694869c5f4078301b7;以下是源码检查,未运行训练或声称复现论文指标。
| 项目 | 实际文件与检查结果 |
|---|---|
| 核心模型 | models/common.py 含 DenseRFB2 的真实多分支实现;models/yolo.py 含 SegMaskPSP、多尺度重采样与双头输出。满足 |
| 训练 | train.py 包含源域 Dice、目标伪框、遮挡软监督和 EMA 更新;README 提供 960 输入、batch 2、200 epochs 的训练命令。满足 |
| 评估 | test.py 有实际推断、NMS 与 AP 计算,README 给出 checkpoint 测试命令。满足 |
| 配置与文档 | 模型 YAML、数据 YAML、requirements.txt 及 README 说明数据对齐、风格转换目录、掩膜与运行方式。满足,但准备成本不低 |
结论:满足实质性开源门槛。仓库包含实际新增模块,不是单纯调用外部检测包的包装层。该结论不等于“一条命令重现全部实验”:伪图像、分割标签、权重和不同任务配方仍要逐项准备核对。数据 YAML 出现目标域分割目录,本身不能证明训练使用了目标真值;已检查的损失路径是源域掩膜监督与目标 teacher 概率监督,应按实际张量流判断。
证据评价与阅读路线
对“辅助结构监督能够在这些配置下增加跨域检测 AP”的可信度为中等:三组任务、模块消融和掩膜扰动实验提供了方向一致的证据。对“DenseRFB 的特定结构与遮挡组合具有已被隔离证明的优势”的证据较弱。不同检测器、额外像素标注、不同初始化与验证集选择都影响比较范围。
建议选读第 3 节与表 4–6,同时打开 SegMaskPSP、DenseRFB2 和训练损失段。原论文图 3可帮助理解双头连接,实际移植则应以已核对的 YAML 连接点为准。
审稿人视角:最大问题与研究启发
最大的一个问题
当前实验没有充分隔离“获得额外像素级监督”与“所提分割头设计本身”的贡献。 第 3.1 节明确引入源域分割标签;表 4 把包含 DenseRFB 的辅助分割分支作为整体加入,得到 55.9→57.2,却没有同样标注预算、同样训练次数下的简单分割头对照。因此,不能从这张表单独推出密集连接或该分支设计是收益的必要来源。
这比少报一个效率指标更影响方法主张:若普通卷积头配同样掩膜即可达到接近结果,贡献就应主要归于辅助监督与训练策略,而不应归于更复杂模块。表 5 的 SAM 实验表明标签覆盖与质量确实会改变 AP,但仍没有解决等监督的架构归因。作者在结论承认伪标签可靠性问题,尚未直接回答这项归因问题。
最小验证是只补一个受控比较:固定源图、掩膜、CUT 伪图、目标样本、teacher 更新、训练预算和模型选择规则,用简单 1×1/3×3 分割头替换 DenseRFB,并匹配参数量;至少报告多个相同种子的配对差异。若 DenseRFB 稳定领先,结构主张得到加强;若差异消失,仍可保留辅助结构监督有用的结论。这一限制不使代码失去复用价值,但会降低复杂模块优先级。
研究启发与可执行验证
可执行的启发是:先做等信息量比较,再判断模型增量。迁移到天文检测时,若新增源分割图或模拟掩膜,基线也应能使用同样监督;否则“网络改进”与“多给了标签”的效应混在一起。目标域数据需与最终测试区域或观测批次分开,掩膜生成误差按源大小、拥挤程度和信噪比分层报告。对小而弱的天体,遮挡可能直接抹掉全部证据,不能照搬 0.6 比例。
可复用模块或设计思想
- 优先借鉴辅助分割监督的接入方式:输入来自 neck 的多尺度特征,经通道压缩、对齐和融合输出像素分类图,梯度回传到共享表示。
models/yolo.py::SegMaskPSP给出明确接入实现。先保留最简单融合头,与无辅助监督模型在同一标注集合上比较。成本是分割标签、额外特征与上采样显存;本文没有给出足以精确估计额外 FLOPs 的完整实测结果。 - 遮挡后的软目标一致性:
train.py中的 masking 与 teacher 概率损失可接在其他 teacher–student 检测系统的辅助头上。它不改最终目标框表示,主要增加训练前向与损失计算。最小实验应固定辅助头,只比较遮挡关闭、低比例和论文默认比例,并检查小目标漏检;表 4 的组合仅比辅助分割单独高 0.1 点,故不宜优先扩大计算。 - DenseRFB 的密集多尺度上下文融合:
models/common.py::DenseRFB2将已有分支特征输入后续膨胀卷积分支,以较大感受野补充局部信息。适合对象边界有可学习空间结构的特征图;对接近点源的目标,价值尚未验证。最小验证是前述等参数简单头对照,再加“相同分支但移除密集连接”消融。论文现有表 4 未单独隔离这一连接机制,因此其净收益暂不能确认。
四、跨论文结论与行动建议
优先精读 The Fast & Fourier 的理由是其方法、误差与后验校准形成了清楚的研究设计;优先动手检查代码则可以选 JMT-YOLO,因为关键训练路径已经公开。两者的最大问题都影响“应该相信哪部分结果”:前者决定代理是否继承模拟系统偏差,后者决定收益是否应归功于提出的模块。
可以立即规划、但仍需实验验证的三项工作是:
- 对昂贵模拟代理,建立少量独立高保真参考点,优先覆盖真实后验高概率区域和数值困难区,记录重复模拟散布与网络残差
- 对辅助任务模型,在相同标签、数据与训练预算下比较无辅助头、简单辅助头和复杂辅助头,避免把新增标注的收益归给结构
- 对概率反演,分别检查连续谱与关键特征波段的代理误差,再比较全局和分波段误差模型的覆盖率;对检测,分别检查小目标、遮挡对象与域外条件
暂时不应据此声称:FNO 已能不补充训练数据就解析任意高分辨率 JWST 冰谱;平滑预测必然比蒙特卡洛模拟更符合物理;JMT-YOLO 在所有跨域基准最优;或者辅助分割与遮挡的收益已被证明稳定相加。前者需要高保真参考与谱分辨率验证,后者需要等监督的受控消融。
本报告由 ChatGPT Dots 整理分析,博客作者对分析内容不负责且不代表博客作者本人的想法。