一、本期总体分析
arXiv 论文时间范围:[2026-10-08 04:58:51, 2026-10-09 04:58:51)(Asia/Singapore) 各分类篇数:astro-ph 122;cs.CV 262;cs.LG 512;cs.AI 447;stat.ML 92(含跨类,分类间可能重复) 入选篇数:2
本期两篇论文都预测概率分布,但解决的是不同问题。ROSE 从恒星亮度随时间变化形成的功率谱中测量星震参数,重点是让不同参数使用适合自身物理含义的输入表示;逻辑高斯过程论文从星系测光表格预测红移密度,重点是把有限维贝叶斯推断扩展到数百万样本,并明确哪些不确定性真正被积分掉。
最值得共同借鉴的是:概率分布看起来合理,不代表它已经覆盖了真实误差。ROSE 的不确定性受到软标签宽度和可靠样本筛选影响;逻辑高斯过程在同分布测试中校准较好,却在明显偏离训练分布时失败。两篇都提供了有用的负面结果,使方法的适用范围比摘要中的单一精度数字更清楚。
建议先读 ROSE 的输入表示、分辨率匹配和表 2,约需 35–50 分钟;再读逻辑高斯过程的第 2、5、6 节与附录 I,约需 50–75 分钟。前者更适合学习天文信号处理与网络结构如何配合,后者更适合作为测光红移概率预测的可运行方法储备。以下判断针对当前预印本及公开实现,不等同于同行评审结论或独立复现实验。
二、入选论文概览
| 优先级 | 英文标题 | 论文类型 | 核心贡献 | 数据或基准 | 代码状态 | 适用研究场景 | 一句话判断 | arXiv |
|---|---|---|---|---|---|---|---|---|
| 1 | ROSE (Red-giant Oscillations Spectra Estimator): A Modular Machine-Learning Framework for Automated Asteroseismic Characterisation. I. νmax and Δν from TESS | 天文交叉 | 参数专用表示、物理坐标网格与概率输出 | 合成星震谱、Kepler、TESS | 未核实到本版本的官方实现;星表称将交 CDS | 星震参数测量、模拟到观测迁移 | 表示设计具体,新增星表的可靠性仍需独立验证 | 2610.10312v1 |
| 2 | Scalable Logistic Gaussian Process Density Regression with Kinetic Langevin Sampling | 天文交叉 | 深度非平稳核与可扩展潜变量后验采样 | Happy、Teddy、SDSS DR18、DESI DR1 BGS | 官方仓库包含模型、训练和评分路径 | 表格测光红移、条件密度与校准 | 同分布概率预测有竞争力,不能直接外推到不同选择函数的样本 | 2610.09591v1 |
三、逐篇深度分析
3.1 ROSE:先把参数放到容易测量的表示中
基本信息:作者为 Nipun Ghanghas、Dinil B. Palakkatharappil、Rafael A. García、Shravan Hanasoge;arXiv:2610.10312v1,分类 astro-ph.SR、astro-ph.IM。首次提交为 2026-10-07 16:06:46 UTC,本次为 v1,无版本差异可比较。摘要页、HTML 正文、PDF。正文没有给出可核实的 ROSE 官方代码或独立项目页;第 4.5 节称星表将以电子形式提供给 CDS,不能据此认定完整星表已经可以下载。
一句话结论:值得精读,尤其是“物理坐标不能被固定长度数组代替”这一实现原则,以及可靠性筛选如何改变最终精度的讨论。
科学问题、数据和验证对象
这里的 spectrum 是光变的功率谱,不是按波长采样的恒星光谱。两个目标分别是最大振荡功率对应的频率
传统星震管线寻找振荡包络和梳状模态。困难在于,包络可以存在而模态间隔仍难辨认,自动算法也可能将谐波或非星震的尖峰当成目标。作者不把两个参数塞进同一个回归头,而分别设计输入变换与输出网格。
第 2 节给出三类数据:
- TESS 母样本:从 Gaia 候选中结合 XGBoost 分类、Kiel 图和颜色—星等图选出红巨星,再与 TESS 输入星表交叉匹配;要求累计至少十个 sector,得到 274,721 颗候选。其光变来自 MIT QLP 的全帧图像测光,再经 PyTADACS 处理。它是宽松的候选集合,不是 274,721 颗已确认振荡星。
- Kepler 验证样本:约 21,000 颗红巨星的长采样光变,通过 Lightkurve 获取各季度数据;与 Yu 等 2018 年的 16,095 颗参考星匹配,得到 15,799 颗。
- TESS 参考集合:使用 Sreenivas 等 2026 年连续观测区星表,其参考光变的中位时间跨度为 690 天。两条管线使用同一仪器,故这不是独立仪器的真值检验,观测系统误差可能共有。
论文没有完整列出母样本的数值颜色 cuts、交叉匹配半径、所用 Gaia 具体发布版本及天空面积,也没有在本篇重述两任务的通带边界。复现样本选择时仍需这些信息,不能用巡天的一般覆盖范围代替实际入选覆盖。
从光变到网络输入:分辨率是数据含义的一部分
TESS 预处理包括:将长于三个 sector 的间断压缩,移动后段时间戳;按中位流量拼接 sector;做
训练谱由 Spectra Simulator 生成,包含压力模、混合模、旋转分裂、Harvey 型颗粒背景和白噪声,最后乘以自由度为 2 的卡方随机实现。频率网格为 0.03–277.78
约两百万条合成谱按 82.5%/15%/2.5% 分为训练、验证和测试。作者说明测试来自未见过的文件,却未明确同一物理参数组的不同噪声实现是否始终在同一集合,因此参数级独立性尚不能确认。这不等于已发生泄漏。此外,表 2 的合成参考行约为 19,500 条,并不直接对应两百万的 2.5%;正文未把中间过滤或抽样过程交代完整,不能将它们默认为同一统计口径。
Kepler 光变则被直接计算到相同的一年频率网格。作者在第 2.2 节主动提醒:四年窗口下的尖锐模态轮廓仍被保留,故它是“采样匹配”,不是真正截断为一年再重算的验证;窄结构可能得到略乐观的结果。
第 3.5 节最有价值的例子是:对本征分辨率不同的 PSD 做变换,再插值到相同数量的数组元素,并不能保住频率间隔的物理含义。早期多输入方案会把四年 Kepler 的
两个模块为什么采用不同结构
最终管线分别运行两种表示,并要求结果的相对差异小于 30%。这是拒绝条件,不是两结果的平均,也不是误差修正。TESS 以信噪比版本为主要估计器,线性版本用于检查。
骨干为一维宽残差网络:初始 16 通道卷积及二倍最大池化,随后四阶段分别有 [2,2,3,3] 个残差单元、[16,32,64,128] 个通道,后三阶段首单元下采样;卷积核宽 51,dropout 为 0.1。最后全局平均池化与 softmax 输出 4–278
- PSD 除以最大值,用对数频率轴上 0.25 dex 滑动中位滤波估计背景;中位数除以
,转换到卡方噪声的均值尺度,再将 PSD 除以该背景得到信噪比谱 - 以先前预测的
为中心截取宽度 的窗口,其中 ,数值按论文的 约定使用 - 减去宽尺度高斯趋势,做宽
的轻度平滑,再加 Hann 窗,计算实离散傅里叶变换的模平方 - 将 PSPS 映射到 0.333–21.0
、832 点、相对步长 0.5% 的固定对数网格
这个网格让
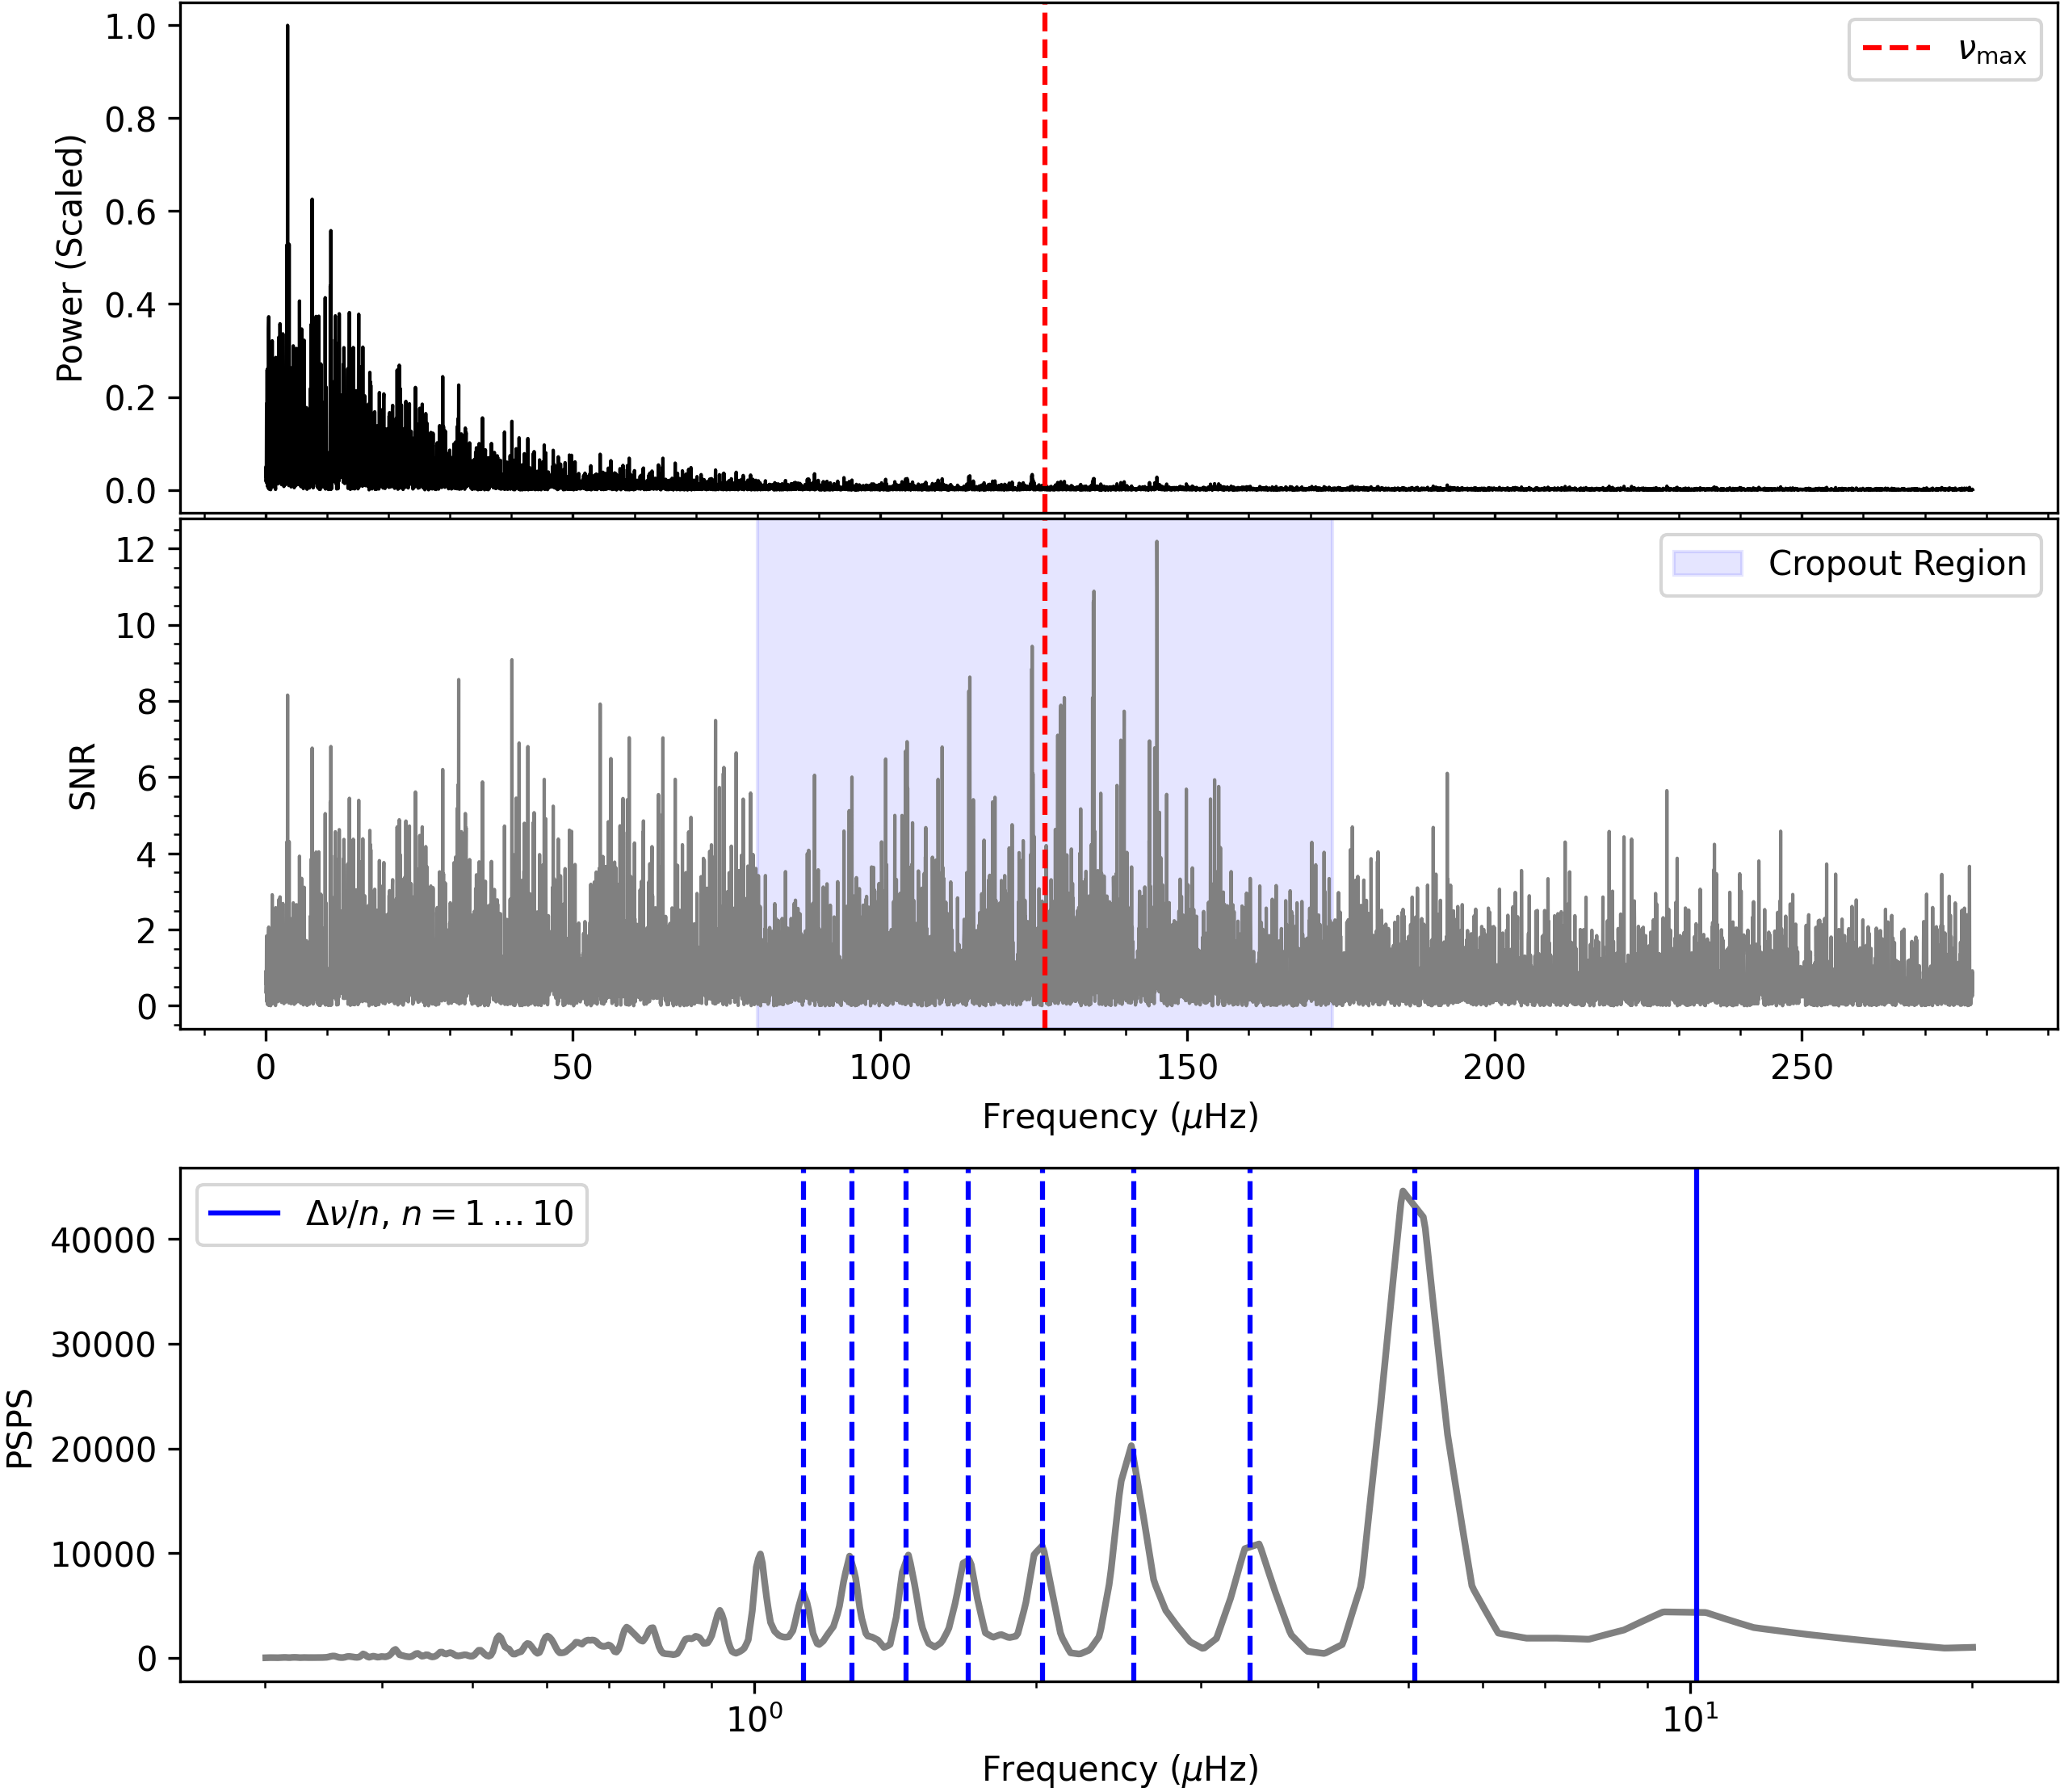
对应网络有四个 [2,2,2,2] 残差阶段,通道 [32,64,128,256],核宽 11,dropout 0.2,约 730 万参数。这里不沿物理轴下采样,也不用全局池化。 输出先压到 8 通道再展平,保留位置后预测 591 个相对宽度 0.5% 的箱。原因是目标就在峰的位置中,池化会丢掉所需信息。
标签是对数
概率分布和可靠性:不能把窄分布直接叫作可信
输出以第 50 百分位为点估计,第 16/84 百分位形成非对称区间;另计算最大箱概率、归一化熵和结合区间宽度的可靠性指数。可靠样本要求
分布诊断仍抓不住“很自信的非星震信号”,所以附录 A 再按最高十个峰的高度、集中程度与谐波关系剔除可疑谱。作者明确承认这些经验阈值没有通过带标签样本标定,完整率和污染率未知,且只针对一年分辨率的 TESS 数据。
表 2 的主要结果如下。离散度为相对残差的
| 数据 | 参数 | 可靠样本/参考样本 | 中位偏差 | 稳健离散度 | 归一化残差落在 ±1 内 |
|---|---|---|---|---|---|
| 合成谱 | 16,851/19,523 | −0.01% | 1.38% | 65.4% | |
| Kepler | 14,164/15,799 | +0.81% | 3.29% | 63.0% | |
| TESS,可靠参考 | 7,981/10,073 | −0.22% | 4.43% | 66.6% | |
| 合成谱 | 16,295/19,519 | +0.00% | 0.35% | 87.8% | |
| Kepler | 13,339/15,794 | +0.14% | 0.61% | 85.6% | |
| TESS,可靠参考 | 7,220/10,070 | −0.16% | 1.27% | 65.2% |
若取消参考星表的可靠标志要求,TESS
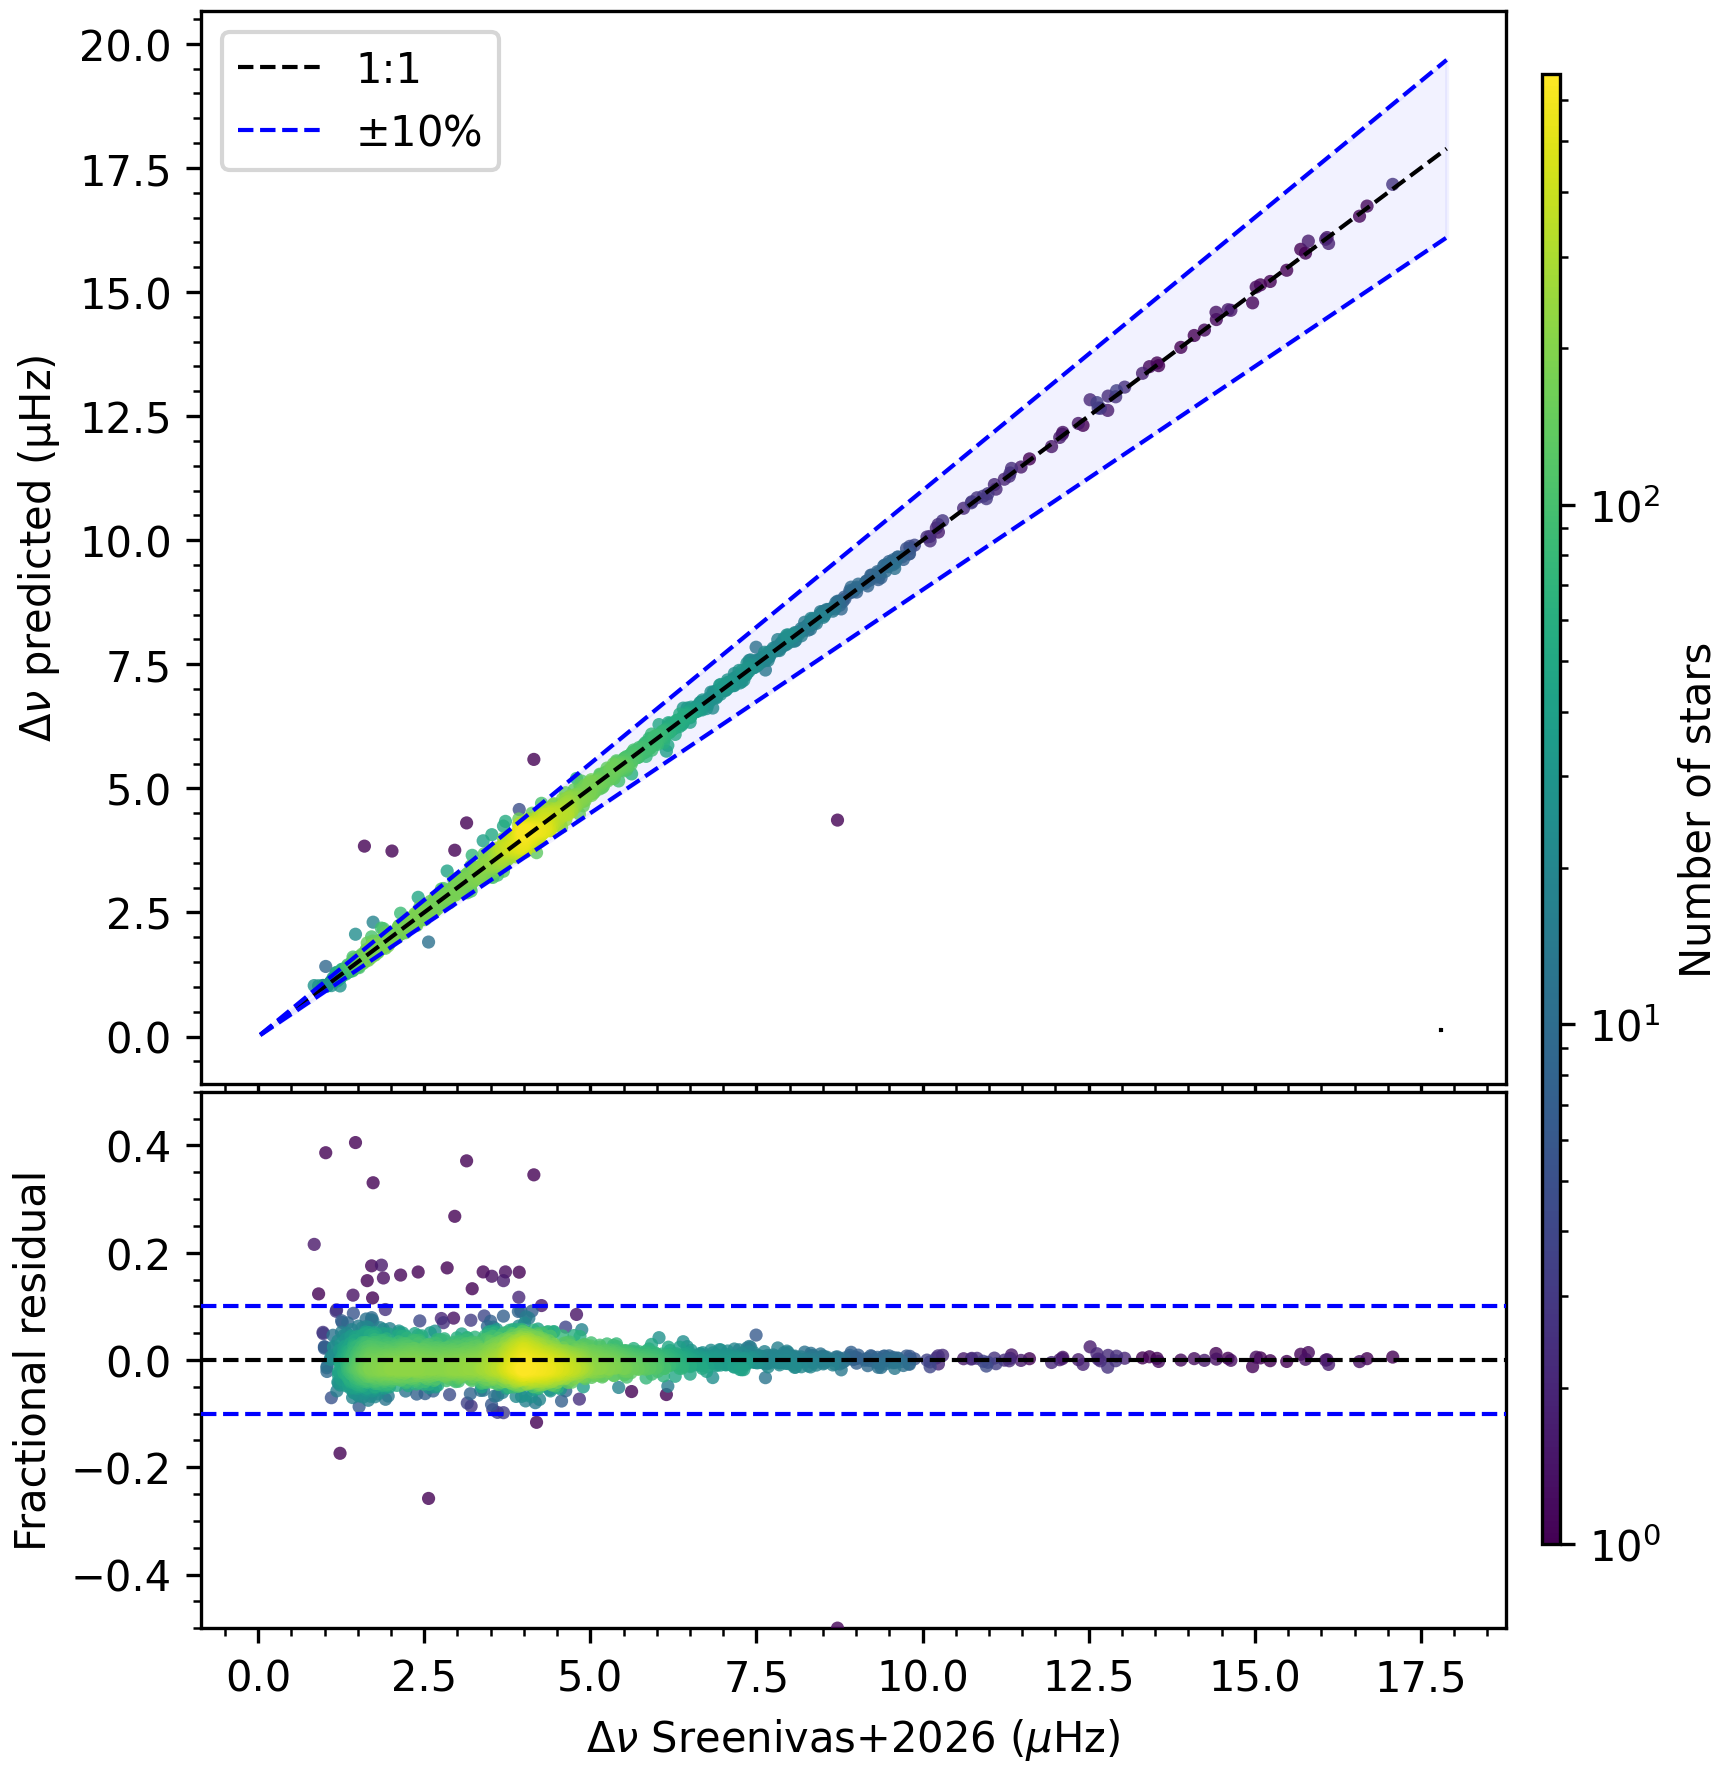
母样本最终保留 56,224 个可靠
图 4 的红团簇统计性过密结构是有意义的天文一致性证据,但作者不做逐星演化分类。训练时已将
还有两处文本需要避免照抄:第 2.3 节 TESS 交叉匹配数为 17,203,而表 2 全匹配行的分母分别为 17,317 和 17,198,数量关系未解释;第 4.4 节说固定相对步长的对数箱在低值端“绝对更粗”,与这类网格的数学性质不符。前者影响样本追踪,后者影响低频条纹的解释;都不足以单独推翻表 2,却需要公开实现与清单澄清。
证据评价为中等:真实 Kepler 与 TESS 比较支持参数测量能力,输入坐标机制也很清楚;完整率、域外污染和本版本复现条件尚未闭合。核验截至 2026-10-09,未找到由本篇明确链接的模型权重、训练入口或可访问完整星表,因此不能写成“已可直接复现”。
审稿人视角:最大问题与研究启发
最大的一个问题
可靠参考子样本上的精度,尚不足以验证整个新产出星表的可靠性。关键证据是第 3.7 节承认经验排除规则的完整率、污染率未知,第 4.3 节又说明参考交集是较容易的子样本;第 4.4 节中经验规则会移除 9,417 个原本可接受对象,两表示一致性再移除 1,792 个,说明选择过程对产出有实际影响。
这个问题比某个网络超参数缺失更重要,因为论文的用途包含大规模自动星表:下游研究不仅关心留下来的已知好星是否准确,也关心新接纳了谁、遗漏了谁。它不否定已验证子集的精度,却限制了“新增可靠测量”和完整样本群体分析的可信范围。作者已经承认阈值问题,并提出未来训练分类器,但目前并没有独立真值验证来替代这一步。
最小的关键补充是从“新增通过、被拒绝、已有可靠参考”三个集合中,按星等、
研究启发与可执行验证
参数预测器和接纳规则应作为一个整体评估。迁移到其他天文任务时,先保存未通过对象及失败原因,再检查误差是否随质量阈值变小、而样本分布同时改变;不能只展示筛选后变窄的残差。
另外两个值得执行的小实验是:固定物理参数、改变观测窗口检验坐标不变性;固定模态间隔、改变包络位置检验是否仍借助训练相关性。它们分别检验坐标处理和相关性捷径,不要求先扩大网络。这些是迁移建议,代价是需要受控合成数据或可重算的原始光变,并不保证性能增益。
阅读路线:优先第 3.3–3.5 节和图 1,再读表 2、第 4.3 节与附录 A,最后看图 4。不要只读摘要中的规模与速度。
3.2 可扩展逻辑高斯过程:把红移密度预测做成可采样的模型
基本信息:作者 Daniel Paulin、Ádám Jung、András A. Benczúr;arXiv:2610.09591v1,分类 stat.ML、cs.LG。首次提交 2026-10-07 07:35:41 UTC,本次为 v1。摘要页、HTML、PDF、作者官方代码。这不是以图像 backbone 为核心的纯 CV 论文,而是包含深度核学习、并在真实天文测光红移任务上验证的条件密度方法。
一句话结论:值得作为概率红移基线精读,主要价值是规模化能力与诚实的推断边界,而不是一个普遍优于基础模型的结论。
为什么需要预测密度,以及它的增量在哪里
不同红移、恒星族和消光的星系可能有相近宽带颜色,单个回归数不能表示这种退化。逻辑高斯过程先用高斯过程描述对数密度,再指数化、归一化,允许连续、偏斜和多峰输出。“逻辑”在这里指归一化指数变换,不是二分类逻辑回归。
该思想与潜变量后验采样已有前作,作者在附录 L 明确不把它们据为创新。本篇增量是把响应方向的傅里叶表示、协变量方向的 Nyström 特征、深度非平稳核、Kronecker 白化和动量 Langevin 采样接成可扩展方案,使百万样本训练不再要求存下完整样本协方差矩阵。
完整数据流:十个测光特征如何成为红移分布
第 2 节首先用训练红移构建单调变换
最后的雅可比因子不能省略,否则从变换轴回到红移轴时密度不守恒。初始
模型把
其中
训练似然在每颗星系的真实红移处计算,没有先把标签分箱。归一化积分采用每单元四点的 Gauss–Legendre 求积;因此“连续标签”也不意味着没有数值离散误差。作者实际采样的是有限特征、数值归一化后的模型,而不是无限维原始 GP。
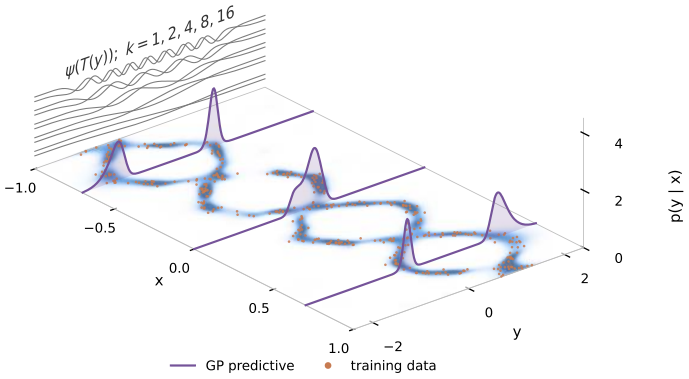
第 5 节的神经网络并非直接输出红移。一个预 LayerNorm 感知机改变协变量坐标、局部核幅度、各方向长度尺度,以及每个对象的响应轴变换。网络通过 0.01 的残差尺度从接近平稳核开始:相似颜色区域可以采用不同的邻域范围,不同星系的密度也可以在某一段很尖、另一段较平滑。响应轴变换保持单调,依旧通过雅可比保住概率含义。
这一设计将“谁和谁相似”与“每颗星系的概率峰有多窄”分开,但没有把所有网络参数都贝叶斯化。网络、核超参数和变换最终取经验贝叶斯点估计,只有潜变量
为什么采样可扩展,理论又保证了什么
固定超参数时,似然在潜变量上属于指数族,结合高斯先验可得到强对数凹后验。作者利用这一结构,在 Kronecker 白化坐标中运行带动量的 Langevin 动力学;每次将随机 minibatch 按正序再倒序访问,抵消领先阶的 minibatch 偏差,称为 SMS–UBU。
四条链组成两对反向耦合链,共享数据分组以复用特征计算。内层采样后,外层利用 Fisher 恒等式估计边际似然梯度,再更新网络和超参数;不对整个采样轨迹反向传播。网络权重用 Muon,其他参数用 Adam,最多 1,000 个外层步骤,按验证对数似然保存模型。
这里必须区分定理与实际训练。第 3.2 节说明,理论要求固定超参数、固定白化变换和更保守的摩擦/步长;默认实现的摩擦为 2,采用局部曲率估计选步长,并在优化期间更新白化,均不完整满足该定理条件。作者还明确不保证非凸外层优化收敛。
附录 I 的受控实验表明,默认采样步长对潜变量方差和 Fisher 梯度存在可测偏差,步长减半后显著减弱,预测 NLL 变化较小;但若干场值和归一化密度的链混合诊断仍不足,不能将“平均预测分数稳定”升级为“所有后验函数量已采样准确”。这是重要边界,也说明本文的理论贡献与经验效果需分别评价。
巡天、标签、预处理和划分
主要输入是测光表格,不使用图像 cutout 或完整光谱作为网络输入;光谱红移充当监督标签。四个基准分别为 Happy、Teddy、SDSS DR18 和 DESI DR1 BGS Bright。
Happy、Teddy 源自 SDSS 星系,主实验使用 A 训练、同分布 B 测试,清理后样本量分别为 74,950/74,900 和 74,309/74,557;C、D 用于分布偏移检查。SDSS DR18 基准含 500,000 行,随机按 450,000/50,000 划分。DESI 使用 DR1 的 BGS Bright、约 ZWARN=0、DELTACHI2>40、SPECTYPE=GALAXY,再要求各测光波段流量等有效,得到约 435 万行,训练约 391 万、测试 434,505 行。附录 F给出数据与指标;建表源码还明确检查正逆方差、正红移及有限值。
DESI 特征来自 Legacy Surveys 的
所有特征按训练数据标准化,再以训练标签与特征中位分割之间的响应变化量重新缩放,以免不敏感维度主导核距离;误差列取对数并作相同类型处理。随后每列在绝对标准化值 3 以内保持线性,之外用双曲正切平缓压到 5 附近。预处理入口可追踪实际执行链。不能把这是“使用误差”解读为已经显式积分了每颗星系测光噪声的联合分布。
这些数据有光谱成功率、亮度和多波段正流量选择效应。主表中的 SDSS/DESI 是随机行划分,不是按天空区域或巡天划分;论文也没有给出完整的天空覆盖、各红移区间数量及所有质量 cuts 后的选择函数。重复对象的跨集合完整审计未从正文确认,不能据此指控发生泄漏,但复用时应单独核对对象 ID。
主表结果、公平性与消融
下表摘录表 2,以 LGP 与最强的 TabPFN-3.5 对照。NLL 越低越好,负值正常;PIT-KS 是概率积分变换相对均匀分布的距离,越低越好。它衡量的是所评估样本上的校准,不证明任意条件子集都正确。
| 基准 | LGP NLL | TabPFN NLL | LGP PIT-KS | TabPFN PIT-KS | 必要限定 |
|---|---|---|---|---|---|
| Happy A→B | −2.1557 | −2.1632 | 0.0054 | 0.0040 | TabPFN 的密度分数更好 |
| Teddy A→B | −2.3281 | −2.3356 | 0.0042 | 0.0051 | NLL 与校准排序不同 |
| SDSS DR18 | −2.1123 | −2.1012 | 0.0041 | 0.0116 | LGP 密度/校准领先,点预测并非全面领先 |
| DESI DR1 BGS | −2.3786 | −2.3564 | 0.0013 | 0.0078 | LGP 使用约 391 万训练行,TabPFN 上下文仅 50 万行 |
SDSS 的 LGP/TabPFN RMSE 为 0.0518/0.0514,CRPS 为 0.0216/0.0215;因此更好的 NLL 不等于所有误差都下降。DESI 的 LGP NMAD 为 0.0167、离群比例 0.35%,后者定义为
DESI 的比较尤其需要看附录 I。同用 50 万行时,LGP 缩小网络后只领先约 0.003 nats;沿用大网络反而过拟合。因此全数据约 0.022 nats 的优势主要来自能利用更多训练样本,而非已证明模型在等数据下明显更优。这仍是有用的工程与方法贡献,只是归因不同。
去掉潜变量场、只保留可学习变换,四个基准的 NLL 变差约 0.13–0.37 nats,PIT-KS 也明显变差。该消融同时删除了容量与后验积分,作者正确指出它不能单独证明“采样优于其他推断”。同表示下与 Laplace 的受控比较更接近这个问题:采样预测约好 0.12 nats,但链的有限运行误差尚未完全排除,不能说这是精确后验对高斯近似的最终差距。
大样本实现不在 GPU 保存约 17 GB 的完整特征矩阵,而按批次重建、共享链间计算,预测也分块执行。表 3 报告 RTX 5090 32 GB 上,Happy/Teddy 约 6 分钟、SDSS 约 16 分钟、DESI 2.2–2.5 小时,含评分。这是单次模型拟合成本,不是全文全部基线和消融的复现成本。
公开实现与复现风险
2026-10-09 核验的官方仓库提交为 773c00b4fcc667e41ba6016111bd241547f6ab19;官方性依据是论文第 2 页直接链接该仓库。静态查看的内容包括:
- 模型实现:
lgp/spectral_runner_nystrom.py中LIK计算归一化似然,phi_of实现深度核与 Nyström 特征,sms_sweep实现正反序分批采样,outer_step连接外层更新 - 训练配置:
reproduce/make_jobs.py写明四类数据的网络宽深、锚点、模式数、链数和验证比例,并生成训练命令 - 评估路径:主 runner 计算密度与分布指标,
lgp/tools/conditional_calibration.py、paired_diff.py、shift_support.py对应条件校准、配对差异和支持域检查 - 环境与数据:
requirements.txt固定依赖,README 与reproduce/prepare_data.sh提供获取和准备路径;README 声明 DESI 约需 64 GB 主存、30 GB 磁盘,模型峰值显存约 21 GB
这些是已读代码与文档的事实,未执行安装、训练或端到端复现。仓库未找到许可证文件,公开可读不能自动等同于可任意再分发;图 1 绘图脚本也被 README 明确列为未包含。另需注意,DESI 建表文件开头保留了旧 Data Lab 路径的约 418 万对象说明,后文明确论文使用 FITS 路径,因为连接测光表会丢掉部分目标;复现应按实际命令与 cuts 追踪,不能只读开头注释。
证据评价为中高,限同分布密度预测:多个真实基准、重复拟合、评分精度检查与等数据对照较充分,公开代码可追踪;理论并不完整覆盖默认训练,全部大样本证据仍来自测光红移,不能直接推广为任意表格任务都更好。
审稿人视角:最大问题与研究启发
最大的一个问题
Nyström 局部表示在训练协变量覆盖之外失去对象区分能力,使同分布的良好校准不能延续到明显分布偏移的星系。附录 I 给出直接反例:Teddy A→D 中,95% 的测试对象至少一个星等或颜色位于训练中央 99.8% 范围之外;即使只看响应支持域内的共同对象,LGP NLL 约为 −0.33,TabPFN 约为 −1.66,PIT-KS 分别为 0.22 和 0.12。
作者测得该集合潜变量场幅度中位数约减半、低分位下降更大,符合“远离锚点时核特征衰减,预测退回较少依赖对象的变换”的解释。不过 Happy D 也有场幅度缩小而性能下降较轻,因此它是有证据支持的机制,不是全部误差的唯一已证解释。
之所以把它放在首位,是因为测光目标与光谱训练样本的分布差异直接决定方法能否用于真实目标星表。这个限制不推翻论文同分布的结论;作者在讨论中也主动收缩了主张,但尚未解决迁移问题。
最小验证应固定响应支持范围,在按星等/颜色距离递进的外推集合上,比较当前模型与一个显式支持域诊断方案:以锚点距离或特征范数标记不受训练支持的对象,并检查误差—覆盖率曲线。若进一步修改模型,可只改锚点覆盖或全局回退分量,保持其余训练和预算一致。成功标准不是单纯增加保留对象,而是在同一保留率下改善域外 NLL 与区间覆盖;否则应明确拒绝在该区域给出精确密度。
研究启发与可执行验证
概率校准必须随部署分布一起报告。对其他测光红移方法,可先在相同训练对象数上比较 NLL、CRPS 和按星等分组的校准,再单独做跨区域或跨深度测试,防止把更多训练样本的收益归给模型结构。
还应独立检查输出支持域:本模型的红移区间由训练范围扩展得到,范围外密度严格为零。附录 I 的四个偏移集合均有少量越界对象,完整测试集的真实 NLL 因而为无穷大;把越界红移截到端点得到的有限分数不是原模型的有效密度分数。这个检查几乎没有训练成本,却能防止数值截断掩盖科学外推失败。适用前提是评价者保留真实红移和模型支持边界,不能为了有限分数删除难例。
阅读路线:先看表 2 与附录 I 的等数据、分布偏移结果;再读第 2、5 节理解密度和深度核;需要实现或证明时再进入第 3 节及附录 A–E。附录 L 的 SLGP 比较应按作者标注视为受配置、调参和实现预算影响的对照,不是对整个模型家族的优劣判决。
四、跨论文结论与行动建议
ROSE 的主要启发是用任务物理量决定输入坐标和网络读出方式;逻辑高斯过程的主要启发是用可检查的密度表示和推断流程,替代只给一个误差条的点预测。前者复现障碍在于本版本实现和样本清单未核实,后者已有实质代码,但运行成本与依赖环境更明确也更重。
下一步最有价值的三个验证是:
- 对星震或其他频域模型,固定信号、改变采样和观测窗口,检查峰的位置是否在物理坐标下保持一致
- 对概率红移模型,先匹配训练样本数与评分口径,再区分模型收益和数据量收益
- 对任何带拒绝规则的预测器,同时报告保留比例、保留集误差和被拒绝对象分布;另设真正的域外集合
不应据本期论文得出“ROSE 已提供可直接使用的质量年龄真值”“离散分类输出天然校准”或“逻辑高斯过程可以可靠外推到任意测光星表”。ROSE 最大的问题要求先补星表接纳质量验证;LGP 最大的问题要求先查目标样本与训练域的距离。它们都影响应用顺序,但不妨碍将两篇作为方法精读材料。
本报告由 ChatGPT Dots 整理分析,博客作者对分析内容不负责且不代表博客作者本人的想法。