一、本期总体分析
arXiv 论文时间范围:[2026-09-30 04:58:18, 2026-10-01 04:58:18)(Asia/Singapore) 各分类篇数:astro-ph 171;cs.CV 406;cs.LG 697;cs.AI 725;stat.ML 92(含跨类,分类间可能重复) 入选篇数:2
本期两篇论文都把神经网络用于射电观测,但训练方式和科学输出有明显区别。SIFARI 针对每个观测场重新拟合一个连续亮度函数,用仪器的傅里叶前向模型把图像与观测联系起来;另一篇 H I 自吸收论文先用合成光谱训练小型分类器,再将它直接应用到真实巡天光谱,并用输入梯度定位吸收特征。前者适合研究欠采样成像、隐式先验和重建不确定性,后者适合研究模拟到真实的迁移、弱监督定位和海量光谱预筛选。
两者最有价值的部分都在“神经网络输出如何对应科学证据”。SIFARI 能生成比 CLEAN 恢复图更清晰的细节,但其 SWAG 离散度尚未被充分校准为真实重建误差;HISA 分类器在合成测试集上有很高的指标,但论文明确使用测试指标选择结构,速度定位又在包含训练样本的全集上评估,因此不能直接把这些数字视为严格独立的泛化成绩。真实天区的对照仍提供了有用支持,只是支持范围比摘要中的简短表述更窄。
建议先读 HISA 论文第 2 节、第 4.2 节和附录 A,约需 35–50 分钟,重点理解“分类后定位”与评价样本的关系;再读 SIFARI 第 II、III、V 节及附录 A,约需 45–60 分钟。需要较深入了解神经场和可见度拟合时,SIFARI 更值得保留为方法参考。上述时间是阅读安排建议,并非作者报告的实验成本。
二、入选论文概览
| 优先级 | 英文标题 | 类型 | 核心贡献 | 数据或基准 | 代码状态 | 适用研究场景 | 一句话判断 | arXiv |
|---|---|---|---|---|---|---|---|---|
| 1 | Detecting HI Self-Absorption using Neural Networks | 天文交叉 | 约 1.7 万参数的一维 CNN 检测自吸收,输入梯度提供单个速度候选 | 合成光谱、SGPS GC、THOR+VGPS 与 GRS 对照 | 官方仓库可访问,但当前树未见训练实现;权重需向作者申请 | 光谱预筛选、弱监督定位、模拟到真实验证 | 工具设计简洁,独立评估与复杂视线表现需要补强 | 2609.38042v1 |
| 2 | SIFARI: Self-Supervised Interferometric Fitting for Astronomical Radio Imaging | 天文交叉 | 坐标神经场直接拟合可见度,数据驱动设置 Fourier 特征尺度,并用 SWAG 估计亮度变化 | 合成 ALMA、PDS 70、WISPIT 2 | 作者计划发表后公开;本轮未确认可用实现 | 干涉成像、物理约束逆问题、重建误差评估 | 重建结果有吸引力,显著性解释仍需校准 | 2609.35966v1 |
三、逐篇深度分析
1. Detecting HI Self-Absorption using Neural Networks
基本信息与研究定位
作者为 Eric G. M. Muller、Naomi M. McClure-Griffiths、Hiep Nguyen、Matthew J. Alger、Frances Buckland-Willis、J. R. Dawson、Min-Young Lee 和 Antoine Marchal。论文版本为 2609.38042v1,首次提交与当前版本日期均为 2026-09-29,提交记录为 17:17:14 UTC;分类为 astro-ph.GA、astro-ph.IM。arXiv 页面注明已被 MNRAS 接收,并列有期刊 DOI。本文分析依据 arXiv v1,未把摘要页的接收声明等同于逐项验证期刊排版版。
原文:摘要页、HTML 全文、PDF。官方 GitHub 仓库和 Zenodo 归档由论文 Data Availability 直接链接。
值得精读的是把分类网络的梯度变成光谱定位工具的做法;高置信度输出和定位误差则需要与训练分布、评价划分一起理解。 这是一套强自吸收候选的快速筛选器,不能直接替代冷气体温度、柱密度或质量的物理反演。
科学问题:怎样从发射谱中找出冷原子气体
冷中性氢处在弥散暖气体向分子气体转变的过程中。当前景冷 H I 与背景暖 H I 的径向速度重叠时,冷气体会吸收背景 21 cm 发射,在原本较宽的发射轮廓中形成较窄的凹陷,这就是 H I 自吸收,简称 HISA。它不必依赖离散的背景连续谱源,因此有机会在较大天区追踪冷气体。
困难在于,多个发射分量之间的空隙也能形成凹陷;复杂背景、前景发射填充、低信噪比以及连续谱吸收都可能改变形状。逐谱拟合未吸收背景需要假设其形式,求导法会放大噪声,依靠 CO 等辅助示踪物限定速度范围又可能漏掉没有对应分子发射的冷原子气体。作者希望仅凭单条 H I 发射谱先判断是否存在明显 HISA,再返回最值得进一步分析的速度位置。
这一任务界定很重要。网络不估计完整的未吸收背景,也不输出每个冷云的光学深度。它把昂贵的后续分解集中到候选视线上,科学价值主要在提高搜索效率。
数据构建:标签清楚,但也带入了明确的选择效应
训练数据不来自观测标签,也不是直接抽取某套 ISM 模拟。作者采用逐视线的云模型求解辐射转移:每条视线有 50–150 个普通 H I 云,前面再放置零个或一个冷吸收云。各云均被假设为均匀、等温,速度轮廓为高斯;热运动与湍动共同决定线宽,辐射沿视线叠加并受到前方云的吸收和填充因子调制。恒定背景温度取 3.77 K,最后加入高斯噪声。完整公式见第 2.1 节式(1)–(3)。
表 1 给出普通云与吸收云的采样范围。普通云温度为 50–8000 K、数密度为 0.2–10 cm⁻³,冷吸收云温度为 20–75 K、数密度为 20–30 cm⁻³。普通云中心速度在 −30 到 120 km s⁻¹ 均匀采样;吸收云速度从同一视线的普通云速度中选取,再加上 −5 到 5 km s⁻¹ 的偏移。这样既提供可吸收的背景,又不把吸收中心固定在发射峰上。作者还采样了路径长度、填充因子和马赫数,不能把这套生成器理解成仅在任意光谱上减一个高斯凹口。
正样本要求:加入冷云前后,光谱的最大亮温差至少为 8 K。不满足时重新生成参数。这个阈值在加噪声之前执行,因此不等于固定信噪比阈值;在最强的 6 K 噪声下,它对应约 1.3 的深度与噪声比。正负样本各占一半。它保证训练标签相对清晰,却没有覆盖真实巡天中大量浅吸收、模糊凹陷和多个吸收分量。
最终共有 144 万条独立生成的光谱:120 万训练、12 万验证、12 万测试。每条光谱有 185 个速度通道,间隔 1.5 km s⁻¹,约覆盖 −113 至 163 km s⁻¹;各集合均包含等量的 0、2、4、6 K 高斯噪声样本。作者没有模拟带通伪迹、基线波纹等系统结构,因此“覆盖多种噪声强度”只指这套高斯噪声设定。
归一化也值得单独说明:虽然原文称为 min-max scaling,实际操作是把所有光谱统一除以训练集合中的最大亮温 250 K,并非对每条谱分别减最小值、除以自身极差。统一缩放保留了不同光谱之间的绝对亮度差异,推理时必须沿用同一常数。
网络与定位:一个很小的分类器承担两步工作
模型输入是归一化后的单条 185 通道光谱。两组一维卷积与最大池化逐步提取局部形状,每层使用 4 个宽度为 21 通道的卷积核,卷积步长为 1、padding 为 10。根据正文与附录图 17,特征长度依次为 185、93、47,最终得到 4×47 的特征;展平后进入全连接部分,输出两个类别的 logits,再经 softmax 得到 HISA 与非 HISA 的分数。图 17 还给出了 94 维中间表示。正文报告总参数量约 1.7 万。
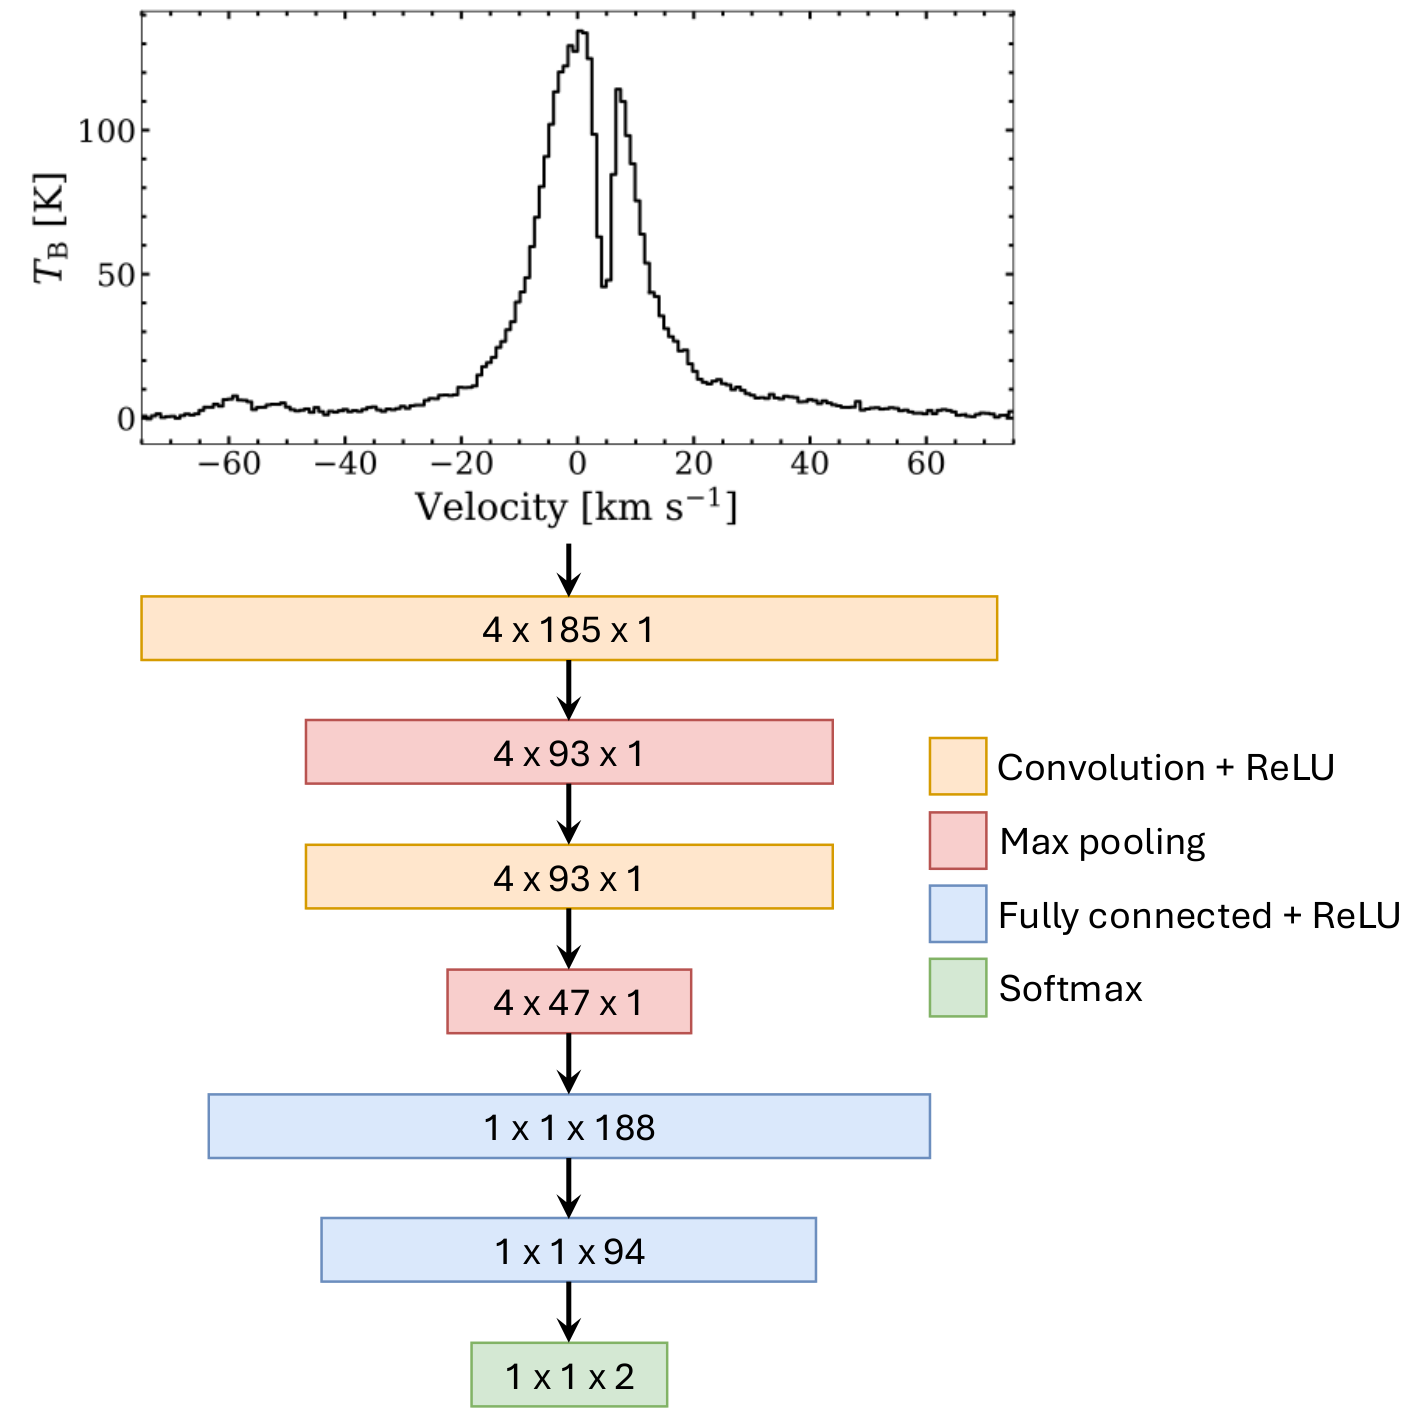
网络用 Adam 和交叉熵训练 100 个 epoch,不使用提前停止。训练损失连续 15 步没有改善时,学习率按 0.1 倍降低。作者逐项搜索层数、卷积核宽度、通道数、学习率和 batch size,每个取值训练十个网络以观察随机波动。正文未完整列出最终学习率与 batch size 的数值,相关比较放在附录图 16;由于可访问仓库未提供训练实现,本分析不补造可直接运行的完整配方。
定位阶段不另训练回归头。先计算 HISA 输出对输入各通道的梯度,取绝对值,再用标准差为 2 个通道、约 3 km s⁻¹ 的高斯核平滑;对平滑后的梯度序列做 softmax,选择最大响应对应的速度作为候选。作者的设计意图是利用分类器已经学到的吸收形状,提取最影响判断的光谱位置。
这里有两个边界。第一,梯度表示局部敏感度,响应峰未必就是物理吸收中心,复杂视线尤其如此。第二,对梯度做 softmax 得到归一化权重,并不能自动把它变成经过概率校准的速度后验。论文把这一序列称作 PDF,实际使用时宜理解为“归一化定位响应”。当前实现只返回一个位置,不能完整表达多个冷云。
从合成数据到真实巡天:哪些结论成立
第 2.3 节报告默认 0.5 分类阈值下,合成测试集 accuracy 为 96.5%、precision 为 96.0%、recall 为 97.0%,ROC AUC 为 99.3%。表 2 给出 57,477 个真负例、2,438 个假正例、1,777 个假负例和 58,308 个真正例。提高阈值到 0.9 后,precision 达 99.8%,recall 降至 93.3%。这显示阈值可以改变纯度与完备度之间的取舍,但这些数值对应的是近乎平衡、且正例深度至少 8 K 的合成分布。
ECE 为 0.0022、ACE 为 0.0030,同样只描述该分布内的校准。真实天区的类别先验和模糊样本比例不同,不能据此声称“输出 0.99 的候选就有 99% 的真实可靠性”。作者在第 4.1.4 节已明确讨论了浅特征上的分数饱和,属于论文主动承认而尚未完全解决的限制。
定位评估使用约 70.2 万条“真实含 HISA 且网络检出”的合成光谱,包含训练、验证和测试数据。作者报告速度差的均值为 1.69 km s⁻¹、中位数为 0.42 km s⁻¹、四分位距为 1.97 km s⁻¹,66.3% 位于一个通道范围内。这里必须保留两个条件:未检出的正样本没有进入定位统计,而且输入包含训练样本。中位数小于通道宽度也不等于每条光谱都实现了可靠的亚通道定位。
真实验证使用两类数据:
| 数据 | 观测来源与范围 | 输入处理 | 对照用途 |
|---|---|---|---|
| Riegel–Crutcher 云 | SGPS GC,ATCA 与 Parkes 合成;所用巡天覆盖银心附近约 100 平方度;像素 35 角秒、原生谱分辨率 0.824 km s⁻¹,离线通道噪声约 2 K | 删除底部 10 行受明显系统噪声影响的区域;裁剪到训练速度范围,线性插值至 185 通道,再除以 250 K | 与线性插值重建背景所得的 HISA 速度比较 |
| 五个 GMF 场 | THOR 的 VLA C 配置与 VGPS D 配置结合;对应组合巡天约 132 平方度,像素约 10 角秒,1.5 km s⁻¹,噪声约 4 K | 速度轴已与训练设定一致,不需谱重采样;同样除以 250 K | 与 GRS 的 ¹³CO 分量速度及 astroSaber 结果比较 |
GMF 五个场为 GMF20、26、38、41、54,其中 GMF38 包含 38a 和 38b 两条结构。GRS 的 ¹³CO 数据由 FCRAO 获得,第 3.2 节报告谱分辨率 0.21 km s⁻¹、角分辨率 46 角秒、采样 22 角秒,覆盖第一银象限的相应区域。比较仅使用双方有覆盖的视线。¹³CO 没有作为网络输入或检测速度窗口的先验,故没有把对照信号直接喂给分类器。论文以这些巡天及引用研究说明数据来源,未在正文统一给出全部输入文件的发布版本与校验值。
R-C 云的空间结构和速度梯度是较有说服力的观测证据:网络逐谱独立处理,没有邻近像素信息,却恢复出大体连贯的云结构。与插值法共同检出的 642,306 条视线中,88.9% 的速度差在一个通道以内,中位差为 0、四分位距为 0.82 km s⁻¹。但全场共 1,092,000 条视线,两法的检测一致率只有 68.3%;31.2% 仅由插值法检出。因此 88.9% 是共同检出子集的速度一致性,不能写成全场的 HISA 识别准确率。插值法本身也会把复杂发射误认为吸收,双方不一致不能全部归因于 CNN 漏检。
GMF 场区给出了更严格的压力测试。阈值为 0.5 时,网络将 88.4% 的视线标为 HISA;阈值为 0.9 时仍有 77.6%;作者最终采用数值阈值 1.0,检出比例才降至 48.6%。这是对浮点置信分数的严格筛选,不代表事件概率已被证明为 100%。与 ¹³CO 速度的比较中,只有 24.6% 位于一个 H I 通道内,速度差四分位距为 12.60 km s⁻¹,55.0% 的绝对差超过 5 km s⁻¹。原子气体和分子气体可以有真实速度差,网络也可能找到与 GMF 无关的另一吸收分量;这些因素使 ¹³CO 不能被当成每条视线的绝对真值。但如此明显的长尾也说明,仅看 0.89 km s⁻¹ 的中位差会严重低估失败情形。
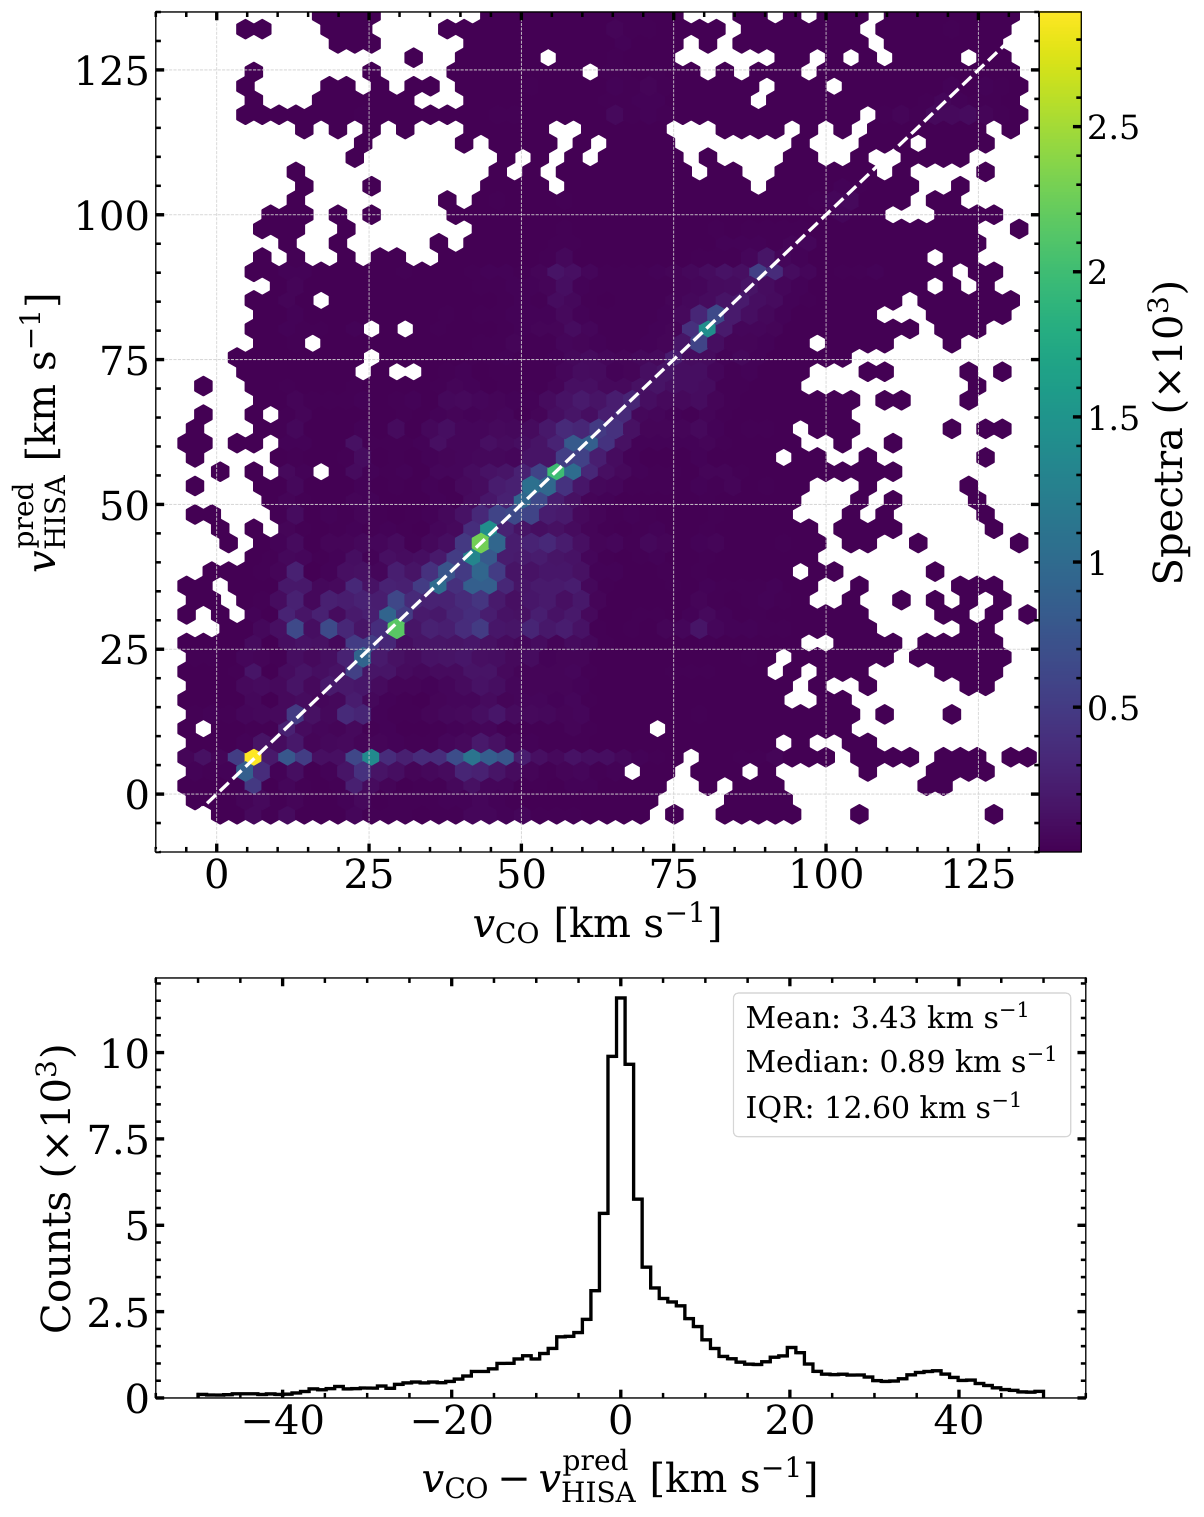
原文还存在少量需要谨慎引用的表述:第 4.1 节开头说 SGPS 的通道宽度更大,但随后列出的 0.824 与 1.5 km s⁻¹ 表明它原本更细,并被降采样;图 9 的图注与前文提到约 4 km s⁻¹,后文又写约 2 km s⁻¹。本文采用明确给出的分辨率与重采样操作,不用该局部例子的冲突速度证明方法精度。
计算成本、开源状态与可用程度
第 5.1 节报告在单张 NVIDIA V100 上训练约 4 小时;2023 款 MacBook Pro 上,R-C 的 109.2 万条光谱检测耗时 70 秒,五个 GMF 场约 180 万条耗时 122 秒。定位另需 81 秒和 174 秒。由此,约 15,000 条每秒是单独检测吞吐;检测加定位的端到端吞吐约为 6,500 条每秒。二者不能混用,且论文没有给出足以逐项复刻硬件与 I/O 条件的完整性能表。
2026-10-01 核验时,官方 GitHub 主分支对应树为 16fdb56b99a3661e186430c8cd5cbf8cbcb2a694,可见内容主要为不同分辨率的图片、README、许可证和参考文献,未见神经网络训练脚本或模型定义。Zenodo 记录可通过官方 API 取得,列有约 27.6 MB 的仓库版本压缩包;本次未下载核查压缩包内部代码。因此,论文的“数据、设计和分析 notebook 公开”声明不能直接转述成已验证的完整复现包。作者同时明确说明训练权重不包含在归档中,需要合理请求。
综合判断:对“轻量网络能识别强吸收并为后续分析提供候选”给出中等可信度;对“复杂场区的可靠纯度、完整速度成分和域外概率校准”证据偏弱。明确剔除连续谱源干扰、核对速度网格与统一缩放后,它仍有作为预筛选器的价值。
审稿人视角:最大问题与研究启发
最大的一个问题
用于报告泛化性能的评价数据没有与模型开发充分隔离。证据并非“没有找到划分说明”:第 2.2 节明确说用测试数据上的 accuracy、precision、recall 比较超参数并选择最佳结构,附录 A 图 16 也标为测试指标。第 2.3 节虽然指出测试样本没有参加权重训练,但这不能消除通过结构选择带来的测试集使用。第 2.4 节又因为定位过程本身没有可学习参数,而在包含训练数据的全集上评估定位;然而梯度来自已经训练过的分类器,后处理确定性不等于整个系统对这些样本独立。
两处现象属于同一个根因:模型开发数据与最终评价数据的角色混用。它最直接削弱的是合成分类指标与定位统计可作为独立泛化证据的程度,并不证明网络没有学到吸收形状,也不推翻真实天区中观察到的空间连贯性。相比某一个结构超参数是否最优,独立测试影响几乎所有主要性能数字,因此应优先处理。
最小修正很清楚:冻结当前架构、阈值、权重和定位步骤,用新随机种子重新生成一套从未参与任何选择的合成测试集;同时报告全部正样本的检出率、检出子集上的定位误差及“检出且定位正确”的联合成功率,并给出各噪声档结果。结构搜索今后只用验证集。作者披露了原流程,但没有把这两处使用方式明确作为评估独立性问题处理,因此现有说明尚不足以解决它。
研究启发与可执行验证
固定后处理也必须作为完整学习系统的一部分接受独立测试。对于谱线分类后定位,首先冻结分类器与后处理,再评估梯度峰是否真正随注入吸收中心移动;加入保持背景不变、只平移或删除吸收分量的配对光谱,可以区分网络响应的是吸收本身还是背景形状。
进一步迁移时,可在独立生成的多吸收云光谱上比较单峰输出与有限个候选峰的召回率,并用相同候选预算约束二者;不要仅靠返回更多峰获得表面提升。额外代价主要是合成样本与人工检查,而非扩大网络。若应用于不同仪器,必须重新检查谱分辨率、噪声相关性和连续谱伪迹;现有结果不能保证提高采样分辨率就必然提高真实性能。
最有复用价值的设计思想是“廉价分类预筛选,再把局部敏感度提供给物理分解程序作为初值”。它适用于特征较孤立且速度坐标一致的场景,不能把 softmax 响应当成已校准后验。建议精读第 2.4 节、图 13–15 和第 5.2 节,先掌握失败条件,再考虑接入光谱分析流程。
2. SIFARI: Self-Supervised Interferometric Fitting for Astronomical Radio Imaging
基本信息与研究问题
作者为 Shunyuan Mao、Andrea Isella、Paris Perdikaris、Li-Ta Lo 和 Hui Li。版本 2609.35966v1,首次提交与当前版本日期均为 2026-09-28,提交记录为 18:00:01 UTC;分类 astro-ph.IM、astro-ph.EP、cs.LG。摘要页注明正在审稿,本文不将其视为已经通过同行评审的结果。
原文:摘要页、HTML 全文、PDF。作者在 Code Availability 中表示发表后才会在 GitHub 与 Zenodo 发布代码,本次未确认可访问的正式实现,也未发现独立项目页。
这篇论文适合研究神经网络如何充当天文逆问题的连续参数化,以及怎样区分重建清晰度与统计可信度。 它不需要从其他天体收集图像训练集,但每个观测场都需要重新拟合,因此不属于一次预训练后快速推理的通用成像模型。
干涉阵列测量的是天空亮度傅里叶变换在有限基线位置上的复数可见度。缺少短基线时,大尺度结构受到较弱约束;不完整的采样还会形成复杂点扩散函数。CLEAN 用离散分量表示发射,恢复图则把模型与恢复波束卷积,再加上残差。复杂弥散结构、残差与模型的波束单位差别、手工掩膜和正则化选择,都可能影响形态与通量估计。
SIFARI 的思路是用一个小型坐标网络表示连续天空亮度,将网络图像送入可见度前向模型,直接用观测数据约束权重。这里的“无显式空间正则项”不意味着没有先验:网络结构、Fourier 特征频率范围和输出形式本身就限制了能够表达的图像。
输入到输出:Fourier 特征如何控制可拟合的尺度
输入不是已有图像的像素,而是天空位置
这些特征为网络预先提供不同空间尺度的变化。只有坐标的 MLP 往往先拟合缓慢变化,较难保留紧致源;加入高频特征能改善这一点,但高频过强也可能容纳伪结构。因此
网络由两层各 128 个神经元的 ELU 隐藏层与标量输出层组成;Softplus 输出再乘以可学习的亮度尺度
附录 A 的自动尺度估计先把可见度按正的径向空间频率分成 40 个对数区间,估计扣除噪声功率后的信号强度,再平滑径向 SNR。它利用 SNR 降至 1 的位置和相对低频信号衰减条件估计支持半径,并限制在实际采样半径的第 99 百分位以内,最后令
图 9 的消融尤其重要:自动尺度在多环和分子云例子中获得最高或接近最高的保真分数,但在倾斜单环上,更小的固定尺度反而得到更高的全局分数;与此同时,自动尺度更清楚地保留了注入点源。因此全局图像相似性与局部科学目标的恢复并不总是同向,不能仅凭一个平均指标选尺度。
拟合观测与估计变化:两阶段各自解决什么
作者在规则网格上评估连续网络,再用非均匀快速傅里叶变换计算实际观测位置的可见度。假设每个复数可见度的实部和虚部具有独立、零均值高斯噪声,方差均为
第一阶段训练 300 个 epoch,每轮打乱可见度并划成不重叠的小批。隐藏层矩阵由 Muon 更新,初始学习率 0.02;输出矩阵、偏置和亮度尺度由 AdamW 更新,初始学习率 0.001。权重衰减为 10⁻⁵,梯度范数裁剪到 1。全数据损失若若干轮不改善,则降低两个优化器的学习率。最终保留全数据损失最低的模型,作为报告的重建图像。具体批大小与完整学习率调度触发参数未在表 1 中给齐。
第二阶段从该模型继续运行 SGD,学习率 0.01、动量 0.9,共 500 个 epoch,从第 200 个 epoch 开始收集权重快照。SWAG 用低秩加对角形式近似权重分布,低秩部分的秩为 20,最后抽取 30 组权重生成图像。不同图像在每个位置的标准差被记为
最终亮度仍来自第一阶段最优图像,而非第二阶段采样平均。作者构造的诊断量是
此处没有常规的训练天体、验证天体、测试天体划分,因为方法针对一组观测直接拟合。不能机械指责它“没有监督学习测试集”;更适当的问题是留出可见度、重复噪声实现、不同形态和基线配置能否约束选择偏差与外推风险。论文目前主要依赖已知真值的若干模拟和两个真实目标。
数据、实验与定量结果
这项工作不使用一个统一的大面积巡天图像训练集。合成实验由 CASA 的 simobserve 生成 ALMA 可见度,包含热噪声:中心频率 340 GHz、总带宽 8 GHz、单次积分 6 秒,目标位于天顶。C-3、C-5、C-9 三种配置分别观测 20、30、60 分钟,合并场景共 110 分钟;均匀盘的短基线缺失测试只用 C-9。模拟真值包括单点源、双点源、均匀盘、倾斜环、多环及由 Herschel Gould Belt Survey 的蛇夫座 L1688 柱密度图改造的复杂结构。后者经过区域截取、重采样和通量重标定,是合成基准形态,不是直接用 Herschel 图像替代真实射电真值。
| 实验 | 原文结果 | 正确解释 |
|---|---|---|
| 单点源,注入 10 mJy | 重建 FWHM 为 0.0040×0.0037 角秒,通量 10.1 mJy | 特定高信号模拟下的有效响应;约为自然加权恢复波束宽度的 1/8 |
| 两个各 10 mJy 的点源 | 间隔 0.009 角秒时中点约为峰值的 90%;0.010 角秒时约为 30% | 按中点降至 50% 的准则,分辨间隔介于两者之间,不能由单点 FWHM 直接推断 |
| 直径 0.6 角秒均匀盘,真值 200 mJy | CLEAN 41 mJy;SIFARI 202 mJy | 当前形态和隐式先验下能恢复缺少短基线的总通量 |
| 直径 1.0 角秒均匀盘,真值 200 mJy | CLEAN 20 mJy;SIFARI 219 mJy | SIFARI 同时存在约 9.5% 的过恢复,不能只强调“接近全通量” |
| 倾斜环内的弱点源,注入 0.1115 mJy | SIFARI 恢复 0.08 mJy,约为真值的 72% | 位置可见不代表通量无偏 |
第 III.1–III.3 节把单源响应、双源分辨和大尺度通量恢复分开验证,是实验设计的优点。单源实验中,自然、Briggs 和均匀加权的 CLEAN 恢复波束本就不同,因此“八倍更窄”必须附带自然加权这一比较条件。它不是各种亮度、任意形态和所有观测配置都能达到的八倍分辨率提升。
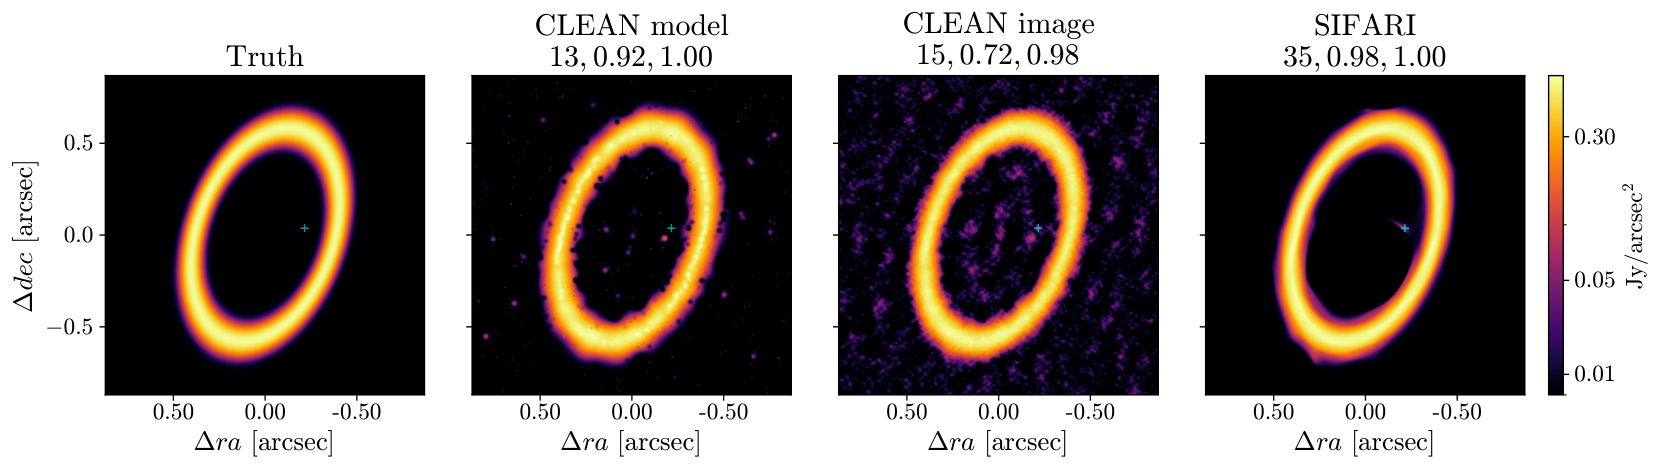
三种复杂形态均与 multiscale CLEAN 比较。图 5 同时展示未恢复 CLEAN 模型、恢复图像和神经场结果,避免把两类 CLEAN 产物混为一谈。以倾斜环这一行来看,恢复 CLEAN 的 IFS、SSIM、总通量比为 15、0.72、0.98,SIFARI 为 35、0.98、1.00;但局部点源仍只恢复约 72% 通量,说明全局指标容易被亮环主导。SSIM 计算前把两图裁到零至真值第 99 百分位强度,这一处理也必须随指标一并记录。
真实 PDS 70 实验采用既有研究的长、中、短基线合并连续谱数据 LB19+IB17+SB16。CLEAN 使用 0、1、3、6 倍波束的多尺度分量、Briggs robust=0.5,并在约三倍预期热噪声处停止。两种方法恢复的总通量均为 0.177 Jy;SIFARI 在内腔中得到更清楚的紧致发射,并报告 PDS 70 c 与 b 位置的诊断 SNR 分别为 6.0 和 5.9。CLEAN 的局部峰值与背景 RMS 比和 SIFARI 的 SWAG 加热噪声比不是同一种统计量,不能按数字大小直接判断谁的检测显著性更强。观测校准主要沿用引用研究,本文并未重新完整报告全部标定步骤。
WISPIT 2 使用 ALMA Band 7、0.88 mm 的 C-10 数据,基线 132 m–15.2 km,最大可恢复尺度约 0.27 角秒,远小于目标环尺度。作者先拟合原可见度,把重建图送入 CASA gaincal 求相位校正,应用校正后再从头训练新网络,最后利用 tclean 的 startmodel 与 niter=0 生成卷积加残差的恢复图。SIFARI 模型总通量为 190 mJy,比原始 CLEAN 的 140 mJy 更接近另一次包含短基线的测量 210±21 mJy。
恢复后的自校准图像 RMS 降低约 30%,支持这套流程可为自校准提供有用天空模型;但比较同时改变了校准状态与重建方法,不能把全部改善归因于神经网络本身。若要比较纯成像能力,需让各方法处理同一份校准数据。
原文图 8 将自校准前的 CLEAN 图像与自校准后的 SIFARI 模型、恢复图并列展示。它说明了完整流程的效果,但不能作为固定校准状态下仅替换重建方法的对照。
证据强度、适用边界与复现代价
对“同一小网络能表达紧致源和若干复杂形态,并直接拟合可见度”的判断,证据为中等偏强:有模拟真值、不同类型目标和真实观测补充。对“缺失空间频率下的结构可可靠外推”,只能给中等或更低的跨场景可信度,因为均匀盘恢复依赖隐式先验;落在观测噪声水平的残差并不能唯一确定未采样区域。
作者报告模拟最优解的近似约化卡方与 1 的差小于 10⁻³,这说明观测域残差功率与采用的噪声尺度接近,不证明重建无偏。多环案例在 A100 上,790×790 网格的第一阶段约 30 分钟,第二阶段约 50 分钟,共约 80 分钟。参数量小没有消除逐网格前向、傅里叶计算与反向传播的成本,不能与已训练 CNN 的毫秒级推理直接类比。
当前实现限于二维、单指向、单偏振连续谱,没有包括拼接观测与宽视场效应。光谱线立方体、多 Stokes 联合重建和闭合量拟合属于作者讨论的扩展方向,尚不是已实现并验证的能力。自动尺度规则、经验训练时长和未公开实现进一步增加复现成本。
审稿人视角:最大问题与研究启发
最大的一个问题
SWAG 给出的像素变化尚未被验证为可靠的重建误差尺度,因此用它构造的 SNR 不能直接承担正式检测显著性的解释。第 II.3 节用 30 个权重样本产生标准差,第 III.5 节展示变化图,第 IV.1 节将其用于紧致发射的约 6 倍 SNR 判断;但正文和附录未给出跨噪声重复实验的覆盖率、空源假阳性率,或不同初始化下系统偏差是否被误差图覆盖。
在缺少空间频率的逆问题中,多个权重样本可能都落在相似的局部解附近,因而图像彼此很一致,却共同偏离真值。加一个热噪声底能避免分母趋零,不能自动覆盖模型表达偏差与欠约束方向。这个问题比个别形态的 SSIM 改善更重要,因为它决定重建中的微弱结构能否进一步被解释为可靠的天体物理信号。
作者在第 V 节承认还需验证误差估计能否跟踪不同观测条件下的真实重建误差,并始终称 SWAG 为近似估计。这种限定是恰当的,但现有图像展示仍不能代替统计校准。问题不会推翻已展示的点估计重建效果,主要限制的是不确定性与微弱源检测结论。
最小验证应固定一组含弱点源的真值与基线覆盖,重复生成独立噪声,并增加不含该点源的匹配对照;每次完整运行两阶段流程,统计亮度区间覆盖率和预先指定位置的假阳性率,再检查 nominal SNR 与真实错误频率是否一致。只有在这个实验成立后,才适合把相同阈值推广到未知弱源搜索。
研究启发与可执行验证
物理前向拟合、图像重建质量和科学检测可靠性应分别验证。迁移这套思路时,可先在有完整观测的模拟中人为删去一段空间频率,比较“观测域残差接近但未观测域预测不同”的情形;用被隐藏的数据检验恢复,而不仅看图像是否平滑。该实验成本主要来自多次单场优化,可以先缩小视场和网格测试,再扩展到真实观测规模。
可复用的部分是“由观测支持范围设置 Fourier 特征尺度”的设计思想。输入为带权的采样坐标和信号强度,输出是编码频率尺度,接入位置在坐标 MLP 之前;它旨在减少逐目标手工搜索。图 9 已说明自动规则不是普适最优,因此迁移时至少比较固定尺度、本文经验尺度与方向相关尺度,并分别报告全局误差和微弱目标恢复率。代码尚未公开,暂不能给出经核验的实现文件或声称模块可直接移植。
建议精读第 II.1–II.3 节与附录 A,再看图 3、5、9 理解指标之间的差别。真实应用可选读第 IV 节;在完成误差校准前,应把该方法视作有价值的重建与诊断方案,而非已经验证的微弱源显著性计算器。
四、跨论文结论与行动建议
两篇论文都说明,较小的网络可以利用明确的观测结构完成有意义的任务,但验证方式必须匹配科学输出。HISA 工作一次训练后快速处理海量光谱,代价在于模拟覆盖范围与真实分布不一致;SIFARI 每次直接拟合观测,避免依赖外部图像训练集,却把成本与不确定性集中到单场优化和隐式先验上。
- 优先精读 HISA 的分类后定位流程。它容易构建最小实验,但应先重做独立测试,再考虑其指标是否可引用为泛化性能
- 将 SIFARI 作为物理约束神经场的方法参考。代码尚未发布,当前更适合比较建模与验证设计,不宜安排成即刻完整复现实验
- 可立即设计两类小实验:在独立生成的单峰与多峰光谱上检查梯度定位;在欠采样模拟图像上检查多次重建的误差覆盖率。前者检验定位是否抓住真实特征,后者检验模型间一致是否对应正确性
- 暂不据此宣称小型 CNN 已解决复杂天区的 HISA 完备搜索,也不把更窄的重建响应或更高的神经场 SNR 当作普遍有效的分辨率和检测显著性提升
两篇论文的首要问题都影响性能数字的解释,但不消除其方法价值。下一步最值得增加的是独立、可控、能暴露错误的验证,而不是先扩大网络或增加模块。
本报告由 ChatGPT Dots 整理分析,博客作者对分析内容不负责且不代表博客作者本人的想法。