一、本期总体分析
arXiv 论文时间范围:[2026-10-23 05:04:52, 2026-10-24 05:04:52)(Asia/Singapore) 各分类篇数:astro-ph 150;cs.CV 192;cs.LG 339;cs.AI 366;stat.ML 44(含跨类,分类间可能重复) 入选篇数:2
这两篇工作分别处理星系物理参数估计与暂现源发现,但都在回答同一个实际问题:当观测没有提供足够信息时,模型究竟能补上什么,又不能补上什么?第一篇把单波段图像和一小段光谱压缩成可迁移表征,展示了跨模态学习对单模态质量预测的帮助;第二篇说明,光变分类器即使分类准确,也未必能在严格误报预算下发现真正陌生的暂现源,而少量新标签放在哪里使用,比继续叠加异常分数更重要。
优先精读 JWST 多模态论文,重点看表 1 与附录 B、D。 它直接涉及输入归一化、误差传播、尺度信息回注、冻结表征与线性探针,适合用来设计图像—光谱融合实验。不过,联合表征的最好结果并不能归因于 CLIP 对齐本身:对齐前后联合质量预测几乎相同,明显变化发生在单模态分支。另一个必须区分的层次是,模型预测的是一个 SED 拟合目录的质量标签,不是独立测得的恒星质量真值。
FLARE 更适合作为分类、异常发现和部署评估的方法参考。 它不是新型深度网络,主体是梯度提升树;价值在于把已知类别分类、未知族群排序、人工复核、新类别学习和反复告警的误报负担分开评价。论文尤其值得肯定的是,明确报告了分类集合从基准数据迁移到实际服务后欠覆盖,以及“每季度一次误报”的阈值未达到目标,而没有把部署成功当作统计有效性的证明。
建议先花约 40–60 分钟读第一篇的方法、主表与附录,再用约 45–60 分钟读 FLARE 的第 V–IX 节和附录 E。若只关心实验设计,先读本报告两篇的审稿人章节,再回看对应证据即可。
二、入选论文概览
| 优先级 | 英文标题 | 类型 | 核心贡献 | 数据或基准 | 代码状态 | 适用研究场景 | 一句话判断 | arXiv |
|---|---|---|---|---|---|---|---|---|
| 1 | Self-Supervised Representation Learning for JWST Galaxy Images and Low Resolution Spectra | 天文交叉 | 独立自监督编码器、尺度回注与跨模态对齐 | JWST F150W、DJA PRISM;质量主表 3,452 个配对条目 | 官方实现、训练配置和分析 notebook 可读;完整数据仍有获取限制 | 稀疏波段星系质量估计、缺失模态表征 | 单模态收益明确,联合输入收益不能等同于对齐收益 | 2610.31078v1 |
| 2 | Photometric classification and out-of-taxonomy detection of ZTF transients with FLARE | 天文交叉 | 上下文分类、异常复核及按时间校准告警 | 10,497 个已知类 ZTF 暂现源、53 个分类体系外对象 | 官方代码、基准划分、训练与部署模块可读;论文与部分脚本口径存在差异 | 时域分类、稀有事件发现、有限跟进预算 | 少量标签应优先进入特征空间,发现效率仍受样本选择限制 | 2610.30656v1 |
三、逐篇深度分析
3.1 JWST:单波段图像与窄窗口光谱能提供多少恒星质量信息?
基本信息:Yang Cheng、Morgan Fouesneau、Ivelina G. Momcheva、Tobias Buck、Shengxiu Sun;arXiv:2610.31078v1,分类 astro-ph.GA。首次提交及本版本日期为 2026-10-22 10:52:45 UTC,暂无后续版本。原文:摘要、HTML、PDF;官方实现与文档。摘要页标注获 NeurIPS 2026 Representations for the Physical Sciences Workshop 接收;这里分析的是 arXiv v1,不将工作坊接收等同于所有结论均已充分验证。
适用研究场景:观测对象只有少量波段,但同时具备形态与低分辨率光谱;或者训练阶段有配对观测,应用阶段只能取得其中一个模态。方法的直接价值不是替代完整 SED 物理建模,而是检验这些不完整输入能否通过总体样本中的经验关系,恢复一个既有物理参数目录。
一句话结论:值得精读;最有用的结果是跨模态对齐改善了单模态质量读出,而简单拼接已经保留了联合预测所需的大部分信息。
科学问题、样本和预处理
恒星质量不能由某个波段亮度唯一确定,年龄、尘埃和金属丰度都会改变质光比。多波段 SED 拟合利用较宽的波长覆盖缓解这些简并。本文故意限制为 F150W 图像和观测系
图像来自四组 JWST 观测,既有 NIRISS,也有 NIRCam,不能把它们视为同一仪器、同一深度的均匀样本:
| 图像来源 | 实际使用范围与仪器 | 筛选后 cutout 数 | 匹配光谱的 cutout 数 |
|---|---|---|---|
| OutThere | NIRISS;实际采用 41 个 F150W 场区,约 174 平方角分 | 143,296 | 474 |
| COSMOS-Web | NIRCam;项目覆盖 0.54 平方度 | 749,154 | 2,298 |
| JADES DR5 | NIRCam;GOODS 场区,文中列深区约 42、medium 区约 167 平方角分 | 409,124 | 5,999 |
| CEERS | NIRCam;Extended Groth Strip,约 90 平方角分 | 77,589 | 2,893 |
| 合计 | 四组 F150W 影像 | 1,379,163 | 11,664 |
表中面积是各项目或所用区域的说明,不能直接相加充当无重叠有效面积。曝光也不统一:OutThere 每个 pointing 为 0.08–2.86 小时,中位数 0.24 小时;COSMOS-Web 为 0.07–0.286 小时;CEERS 典型约 0.8 小时。这个深度差异既是预训练多样性的来源,也可能成为模型识别巡天身份的线索。
作者按各巡天自己的坏区、质量标记和正积分信噪比筛选,并剔除无效像素比例超过 40% 的 cutout。这里的“正信噪比”不等于统一的高信噪比阈值。图像统一为
光谱来自 DAWN JWST Archive,采用 msaexp 统一处理的 NIRSpec PRISM/CLEAR 产品。原始共用网格有 473 个像素,截取观测系 full_err 同步换算。仓库 README 指向 DJA v4.5 文件,论文的科学描述则以 DJA 产品及上述筛选为准。
以图像位置为基准,在
质量标签来自 DJA 目录中的多波段 EAZY SED 拟合。作者要求质量、红移有效,并限制测光与光谱红移的相对差异小于 0.15,留下 7,621 个配对条目;主表再限于
方法:先保留各模态结构,再学习配对关系
整个流程分为三步:图像自监督预训练、光谱掩蔽重建预训练、冻结编码器后的对比对齐。最后的恒星质量预测才使用目录标签,且只训练线性探针。图 1 与附录 B把这三个阶段区分得很清楚。
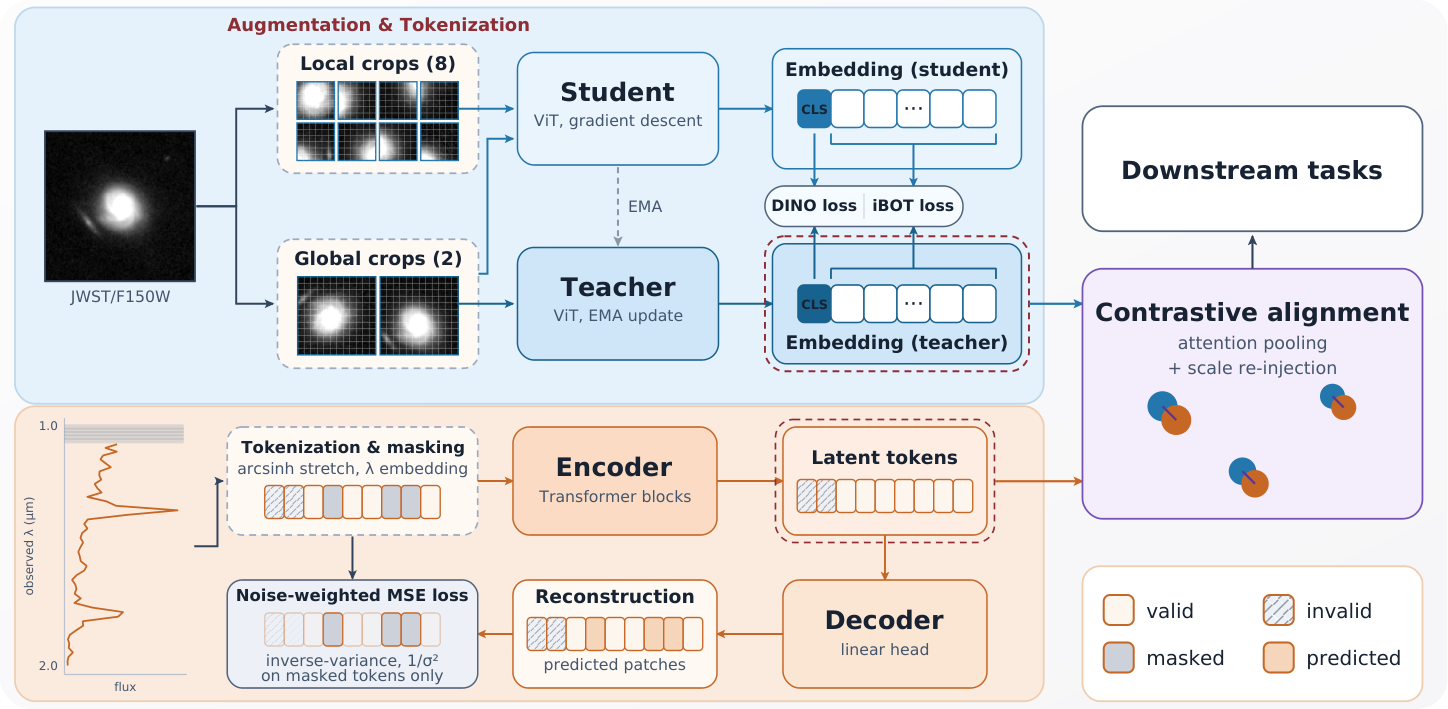
图像分支使用单通道 ViT,宽度 512、12 层、8 个注意力头,patch 大小 6、步长 3,另有 7 个 register token。每个图像产生两个 arcsinh 压缩亮核和背景之间的动态范围。学生网络学习教师输出,教师通过指数滑动平均更新,DINO 对齐全局 token,iBOT 约束掩蔽的局部 token,KoLeo 正则减少表示聚集。
这种增强带来的不变性并非自动正确。大幅裁切可能改变邻近源或延展结构的可见性,噪声增强也不等于完整的巡天退化模型。论文给出稳定训练的设计理由,却没有逐项证明这些增强都保留了质量估计所需的信息。
光谱分支先按每条光谱有效像素的绝对流量中位数
第二式是作者采用的逐像素误差传播,
56 个像素按长度 4、步长 2 切为重叠 token,加入波长的傅里叶位置编码及统计量,采用 8 层、宽度 128、4 头的 Transformer。有效 token 中约 60% 被连续块掩蔽,块长为两个 token;线性解码头重建,损失按传播后的逆方差加权,并用方差下限 0.10 防止少量高质量 token 支配梯度。作者用连续掩蔽降低相邻重叠 patch 直接复制输入的风险,但边界像素是否仍能从可见邻块取得,需要按实际 mask 索引核查,不能仅凭“连续块”宣称完全隔离。
这里存在一个需要复现时明确的文本口径:附录 B.2 写任意坏像素使整个 token 无效,而表 4 列出 invalid-pixel threshold 为 25%。两者未必对应同一层面的筛选,论文没有解释清楚。应核对具体 token 掩码实现及运行配置,不能自行选一个规则补全文意。
CLIP 阶段冻结两套编码器,分别用可学习查询做注意力池化,再回注流量尺度统计量,经过小 MLP 映射为 256 维、
作者还在未对齐表示中拼入同样的两个尺度统计量,避免只让对齐分支知道亮度。官方 fusion.py确实提供 AttentionPool、StatsEncoder 和对称配对损失路径。代码把尺度旁路解释为原始流量均值与标准差;论文同时讨论变换后的统计量,实际复现应沿数据导出链确认各字段的定义,不将编码器内部归一化统计量与尺度旁路混为一谈。
训练配方与结果:对齐改变了哪一部分?
图像预训练使用 20 张 A100、每卡 batch 56、bf16/FSDP,作者报告约 40 小时;配置为 300 个 epoch、每个 1,000 次迭代,AdamW,基准学习率
对齐头约 170 万可训练参数,按 DJA 标识作 90%/10% 训练验证划分,batch 512、温度 0.1、AdamW 权重衰减 0.04,学习率热身到
下表转录原文表 1。质量离群定义为绝对对数质量误差大于 0.5 dex;这里的 NMAD 为 dex,不应与红移的归一化误差指标混用。
| 输入或表征 | 对齐前 | 对齐后 | 对齐前/后 NMAD(dex) | 对齐前/后离群率 |
|---|---|---|---|---|
| F150W 测光线性基线 | 0.750 | 不适用 | 0.358 | 19.5% |
| F150W 测光 + 红移线性基线 | 0.807 | 不适用 | 0.275 | 13.8% |
| 图像 | 0.780 | 0.818 | 0.376 / 0.342 | 20.1% / 17.1% |
| 光谱 | 0.764 | 0.856 | 0.391 / 0.303 | 22.4% / 13.4% |
| 图像 + 光谱 | 0.896 | 0.902 | 0.242 / 0.244 | 8.1% / 8.7% |
图像与光谱单模态的
附录 D 提供了有意思的机制线索:图像的红移
原文图 2可用于查看质量预测的红移依赖;横轴的 true 对应目录 SED 标签,而非独立物理真值。
高红移退化有物理原因:固定观测波段到
代码、证据强度与复现成本
2026-10-24 核验的官方仓库提交为 c40f7142802f2fd7317a74256c1dfecf6ae8d393,官方性依据是论文直接链接该仓库。encoder_image/jwst_dino/、encoder_spectrum/LowResPT/ 和 encoder_fusion/ 有真实模型与训练入口,neurips/ 的 notebook 对应论文图表;README 给出数据构建、训练、环境与分析顺序,代码采用 MIT 许可。本次是代码和文档检查,没有训练模型或独立重现数值。
完整复现仍不是“一键可运行”:README 估计约 400 GB 空间,OutThere 对应数据发布仍待提供,COSMOS-Web 部分目录需按巡天流程登记取得,预训练权重与中间结果需按说明生成。仅因为代码可读,就声称全部训练数据已随仓库公开,会夸大可复现性。
对“现有样本中联合表示能较好预测该目录质量”的可信度为中等偏高,依据是同样本基线、分组探针和重复划分;对“真正优于 SED 物理推断”或“直接迁移 Roman/Euclid”的可信度为低,因为标签本身来自 SED,后两者也只由波长窗口类比,没有实际目标仪器测试。不同巡天混合后的随机划分、SED 模型系统误差、狭缝损失和高红移外推都会限制应用。
审稿人视角:最大问题与研究启发
最大的一个问题
目前的前后比较没有单独识别对比目标的贡献,因为“对齐”还同时改变了池化器、投影网络和表示维度。 证据在附录 D:未对齐图像用 CLS、光谱用 mean+max 池化,分别为 514 和 258 维;对齐后两边都成为注意力池化、尺度投影和 MLP 输出的 256 维向量。表 1 的单模态改进是真实报告的经验结果,却不能仅凭这个对照确定有多少来自跨模态配对学习,有多少来自读出结构改变。
这比“还可以试更多 backbone”重要,因为论文最具方法意义的主张正是对齐带来单模态收益。它不推翻联合质量预测约 0.90 的结果,也不说明 InfoNCE 无效;它限制的是机制归因。作者已对尺度信息做了对称补偿,并在附录 D 用不同目标探针解释信息转移,但未报告池化和投影完全匹配的对照,这些缓解不足以拆开上述因素。
最小补充应固定编码器、池化、输出维度、尺度旁路与训练预算,只改变配对对比学习:将正确配对与打乱配对或适当的单模态训练控制比较,再用相同分组划分和正则选择进行质量探针。需要同时报告绝对性能和配对差值;随机投影对照可以提供额外诊断,但不能独自替代训练预算匹配的控制。
研究启发与可执行验证
最值得复用的不是 CLIP 名称,而是“先检查两个模态各自提供什么,再检查对齐是否真的转移了信息”。迁移分析建议将亮度、红移与目标物理量作为三个探针,以固定读出器做输入侧信息消融;再保留一个完整巡天或场区做域外验证。若单模态仅在混合随机划分中提升、留出巡天后消失,应把收益限定为训练总体内的相关关系,而不是通用物理表示。代价主要是控制实验和新场区标签,不一定需要重训大编码器。
具体可复用的设计是带掩码的注意力池化与尺度旁路:输入是 token、有效性 mask 和流量统计量,输出是固定长度向量;fusion.py提供对应实现。接入其他编码器时应先验证统计量的定义与单位,并比较有/无尺度旁路,而不是直接复用一个依赖仪器单位的数值常量。论文没有给出该模块单独的 FLOPs 或延迟收益,不能从总训练时间反推。
阅读路线:精读表 1、附录 B.2–B.3 与 D;选读附录 A 的匹配和质量 cuts;形态任务读者再看附录 C.2。图 2 适合决定红移适用范围,不适合单独证明跨仪器泛化。
3.2 FLARE:分类准确之后,如何发现真正陌生的暂现源?
基本信息:Argyro Sasli、Felipe Fontinele Nunes、Xuanrui Zhang、Dimitrios Kourtesis、Saina Nikmehr、Alexandra Junell、Jesper Sollerman、Antoine Le Calloch、Sushant Sharma Chaudhary、Sneha Maharjan、Maojie Xu、Avyukt Raghuvanshi、Steven L. Groom、Joahan Castaneda Jaimes、Josiah Purdum、Roger Smith、Mansi M. Kasliwal、Matthew J. Graham、Ashish A. Mahabal、Michael Coughlin;arXiv:2610.30656v1,分类 astro-ph.IM、astro-ph.HE。首次提交及本版本时间为 2026-10-22 03:19:15 UTC。链接:摘要、HTML、PDF、官方仓库、项目页。本文按预印本证据评价,不把线上运行视为同行评审结论。
适用研究场景:光变分类、未知暂现源筛查、少量确认标签的利用,以及需要明确限制人工复核负担的告警服务。它包含神经序列模型对照,但主方法是特征工程与梯度提升树,不能称为一个新的深度学习 backbone。
一句话结论:值得精读其评估方法;相比继续融合异常分数,先把少量确认对象用于特征空间学习,并校准真实观测流中的重复告警,更有明确的实验支持。
数据:这是一份经过光谱跟进选择的样本
标签来自 ZTF Bright Transient Survey。其目录共有 20,547 个对象,其中 12,916 有光谱类型,作者遵循其峰值约 19 等的限制;亮于 18.5 等的分类完成率为 81%,更暗对象仅 41%。因此,未分类对象平均更暗,已分类集不能代表所有警报。BTS 原本保存河外候选,其中的激变变星与 AGN 是较像超新星的那部分,不是从全天原始流随机抽取。第 II 节明确说明了这种选择。
观测从 BOOM 获取 ZTF 测光,采用首次探测后 100 天窗口,至少八次检测,且
光谱只用于给定类型与特定红移对照,日常模型输入不含光谱或图像 cutout。其科学目标也不是仅判断“哪个标签概率最大”,而是把可能不属于任何既有标签的事件交给跟进观测。经典新星虽在物理上属于 CV 系统中的爆发,却有不同光变分布,作者将它与无父类的未知族群分别报告,这比把全部 53 个合成一个“新物理事件”指标更准确。
外部上下文包括四块,具体构建见附录 D:Pan-STARRS DR2 在
它依赖选定宇宙学和宿主关联,不是精确的绝对星等。最近邻宿主可能选错;论文指出,换目录会改变约四分之一对象的最近星系,且模型星等与 Kron 星等存在系统差异。因此,换宿主目录需要重建并重新拟合特征块,不能把同名字段直接替换。
光变转为 160 个统计、Bazin 拟合、颜色演化和采样节奏特征,保留测光误差信息;失败拟合与缺波段保留 NaN,由树处理。用于神经对照与检索时,才把
模型与异常层:分类需要的信息不一定利于发现未知类
FLARE 先做五分类,将 SN CC 与 SLSN 合并,再用一个二分类分支分开两者,最终 SLSN 概率是上层概率乘条件概率。两级都是 LightGBM,类别权重按频数的负幂调整,稀少的 SLSN 分支按 AUC 调参。训练时每块外部上下文独立随机缺失 30%,防止模型把目录缺失本身当作类别标签。
这不是抽象担忧。第 VII.1 节中,光谱红移在所有超新星和 TDE 中存在,在 AGN、CV 中都缺失;直接输入后 macro F1 从 0.74 到 0.86,AGN F1 从 0.70 到 0.95,作者发现主要来自缺失模式而非距离物理信息。限制到都有红移的四类后,收益小得多。这项实验说明,元数据“可用性”可能记录的是跟进策略,而不是天体性质。
异常层使用 LUNA 的 14 个树模型可用评分器,包括概率不确定性、嵌入距离、密度和残差类方法。无标签时取各评分的百分位秩均值;确认对象积累后可拟合监督组合器。分类器使用全部上下文,异常层却去掉测光红移与爆发前对应体块,因为这些块提高分类,却损害了特定异常实验。它们的最优输入不是同一个集合。
校准时,一半验证正常对象确定各评分的秩,另一半定阈值,避免分数依赖当前测试 batch。标称 1% 误报率采用保守顺序统计量;样本太少时阈值设为无穷,而非硬截到最大观测分数。已知类分类另给 class-conditional 预测集合,分别校准每类的
分类结果:上下文比增加网络分支更有用
五折主实验中,只有光变时 macro F1 为
原文图 2可用于查看六类混淆矩阵;其中按真实类别归一化的对角线数值是召回率,不是表 2 的 F1。
TDE 的 F1 从 0.58 到 0.81,SLSN 从 0.42 到 0.53。前者需要核区位置,后者需要亮度尺度;这与外部上下文提供的信息相符。SLSN 分支 AUC 达到 0.97,仍不意味着实际标签高精度,因为测试折中阳性约三十个,对照核心坍缩超新星约五百个,基础发生率影响精确率。
序列 Transformer 使用相同对象、类别和对照折,macro F1 为
预测集合的标称 90% 覆盖,在基准上整体为 90.2%,但 TDE 为 86.8%;78.9% 对象得到单标签集合。整体接近目标不能代替每类达标,且 68 个 TDE 的统计误差不可忽略。
未知对象:三个实验不能混成一个发现率
第一种是没有未知类标签的盲检。在标称 1% 误报预算下,37 个经典新星找回 7 个,即 19%,区间为 9%–34%;16 个无父类对象只检测出一个。前者 AUROC 0.92 看似很高,却没有转化为严格低误报下的高召回。对这些光变与特征,把很多异常评分平均起来并不能产生原来不存在的鉴别信息。
第二种是在 1,575 个已知测试对象与 53 个未知对象混合的 1,628 对象池里,模拟人工每轮检查前 20 个、取得完美标签、更新 logistic 组合器后重新排序。检查 100 个可找回 60%,检查 250 个可找回 83%;静态共识排名对应 34% 和 66%。这代表回顾性、富集样本中的复核效率,不是未经筛选警报流的发现完备率,更不是直接节省 45% 望远镜时间。
第三种是把同样的新标签放到不同学习位置。原文表 8 将它们按真实样本和校准阈值分开:
| 对象与标签量 | 分数监督组合器召回 | 冻结特征上的新头召回 | 作为新类别重新训练召回 |
|---|---|---|---|
| 57 个隐藏 TDE,11 个确认标签 | 57% | 68% | |
| 26 个待测新星,11 个确认标签、20 次抽取 |
这些方法都以标称 1% 正常对象误报预算运行,但实测 FPR 不完全相同:TDE 三项为 1.4%、0.9%、1.1%,新星为 0.9%、0.6%、0.8%。结果支持特征空间比压缩后的异常分数更充分地保留可学习信息;是否需要重训取决于族群。TDE 的新头还不够,新星的新头已接近重训,不能概括成“少量标签后一律重训最好”。
TDE 隐藏实验本质上是删掉已知类,作者也发现这比真正未知家族更乐观。经典新星的 11 标签实验、全体 37 个的盲检、训练折抽稀曲线是不同协议,不能把其中某个 80% 所需标签数拿来替换另一协议的结果。
部署:误报预算必须对应观测流和重复分析
早期跟进只看几天,不能直接使用训练于 100 天数据的模型。固定样本的 5、10、20 天 macro F1 分别为 0.56、0.63、0.73;5 天 TDE F1 为零,AGN 已可通过上下文识别。作者分别训练不同时间跨度的模型并路由使用,而非只截短输入。整个早期实验仍要求对象最终达到完整样本的采样质量,因此不代表所有刚到来的稀疏警报。
Fritz 实际接收的测光比基准更密,同对象 100 天内检测中位数从 26 到 93,仅 39% 的
同一个天体被反复分析,单次 1% 也不等于其一生只被误报 1%。论文回放中,约 10% 已知对象在 100 天内至少触发一次;按服务每天保存 6.8 个源计,约每周五次误报。作者构造运行中的最小 p 值、按分析次数比较正常参考对象,再对全历史最极端统计量校准,最后乘源到达速率,输出每单位时间误报负担。附录 E 和 flare/lifetime.py均说明了“前 40 次每次分析、之后每五次”的回放节奏。
两折交叉拟合下,每周、每月、每季度目标分别实际约每 7、20、25 天一次误报。季度目标明确失败。每周阈值找回服务样本 78 个体系外对象中的 27 个,即 35%,区间 25%–46%。这些结果与先前 83% 没有矛盾:样本、策略、预算与是否利用新增标签都不同。全生命周期统计量也不是任意停止时都有效的 p 值;换采样节奏、到达率和时间窗口必须重估。
代码核验与证据评价
2026-10-24 检查官方仓库提交 227cbff9b3b11d6cc54f42248be7fcde0be88a15。论文第 XII 节直接链接仓库;flare/hierarchical.py、flare/consensus.py、flare/lifetime.py 对应分类、异常共识与生命周期误报,scripts/train_bts6.py 有真实训练路径,scripts/evaluate.py、evaluate_unified.py 提供评估入口,benchmark/DATASET.md 列出基准数据、上下文和按对象 ID 连接的划分。训练/验证/测试条目数为 7,347/1,575/1,575,另有异常留出集。README 提供环境安装、预测和服务接口,代码采用 MIT 许可;本次未运行训练或部署。
这里存在需要固定版本的复现差异:论文描述 cross-conformal,当前 train_bts6.py 的主体却在训练集内部选择轮数、完整验证集做 split-conformal;脚本还保留整体经验覆盖 0.909,而论文第 IV.3 节是 0.902。它们不能拼成一套已经一致复现的结果。脚本顶层说明与内部实现也不完全同步,复现者应明确究竟复现论文交叉验证、某次部署模型,还是当前导出流程。本报告的实验数值以论文 v1 为准,并单独保留代码差异。
对“在这个光谱确认基准中上下文与特征学习有帮助”的证据可信度为中等偏高;对“未知家族在原始警报流中的发现完备率”只有低到中等支持。最稀有家族每类只有 1–6 个,无法据此证明双波段测光在原则上不能区分它们。另一个公开的适应性选择是,作者因重训后未再报出某个伽马射线暴而保留旧模型;论文已说明该对象参与了选择,其回放是说明性例子,不是独立成功案例。每对象约 2 ms 的批处理、单独约 35 ms 与生命周期重放约 2 秒也是不同计算任务,不应混作统一延迟。
审稿人视角:最大问题与研究启发
最大的一个问题
最影响应用结论的限制是,发现效率是在光谱确认且稀有对象富集的回顾性样本上测得,而非目标警报流的真实选择函数下测得。 第 II.1 节说明亮度相关的光谱完成率,第 VIII 节的早期样本以最终采样质量筛选,第 X 节则明确模拟复核池有 3.3% 未知对象且假定完美标签。对依赖首批确认来改进排名的方法,未知对象基础发生率决定前几轮能获得多少可用标签,所以它直接影响 100 次或 250 次复核究竟能换回多少新发现。
这是同一个“评估总体与应用总体不一致”的根因,而非把多个无关缺点拼在一起。它比模型架构新颖性更重要,因为论文的实践主张是提高跟进效率。它不会否定在当前样本上特征头胜过分数组合器,也不会推翻 Fritz 已能运行的事实;它限制的是将回顾性召回率和复核节省比例外推成真实发现率。作者已明确承认样本选择和完美标签限制,并通过 Fritz 测光回放检查输入分布变化,这是有价值的缓解;但服务中已保存、已知类型的对象仍不能替代完整未选择流的前瞻性试验。
最小关键验证是固定一段未来时间窗,在真实进入条件下冻结模型与阈值,记录每次待审对象、确认延迟和最终判定,并对未被选中的对象抽取一小部分随机审查样本,以估计漏检和基础发生率。主要输出应为每周实际误报、每单位复核/光谱成本发现数及未知家族组成,而不是只补一个 AUROC。若标签无法完全取得,结果应给出已验证范围和选择概率,不能默认未审查对象都是正常。
研究启发与可执行验证
最重要的启发是:分类校准、未知类发现和重复告警负担必须分别验收。迁移到其他天文时序任务时,可先在同一冻结特征上做“异常分数组合器—监督新头—新增类别”的同标签预算比较,保留每项实际 FPR;然后按时间分块验证并按观测跨度路由校准。只有确认采样节奏、正常总体和到达速率相近,才可迁移生命周期误报参考。代价是维护代表性校准样本和确认记录,不是单纯增加模型参数。
训练时的上下文 dropout 也值得尝试,但须分别检查“有/无每个字段”的子样本,且不能假定独立随机丢块已经模拟真实相关缺失。对于来自不同巡天、不同跟进优先级的数据,缺失是否编码了人为选择,比总体分数再提高一两个点更值得先排查。
阅读路线:精读第 VII 节的缺失捷径、第 VI 节与表 8 的同标签对照、第 IX 节及附录 E 的生命周期告警;看第 V.2 节时始终带着“富集样本、完美确认”的条件。要实际复现,再逐项对照当前训练脚本与论文版本。
四、跨论文结论与行动建议
两篇论文的共同价值在于把“算法表现”拆回到输入信息、标签来源和评估总体。JWST 研究说明形态与光谱互补,但联合输入已经很强时,对齐不一定继续提升;FLARE 说明更多上下文有助于分类,却可能损害未知类盲检,部署也需要独立校准。两者都不支持“多模态越多越好”或“更复杂网络必然更可靠”。
- 优先精读:JWST,适合研究表征、谱误差与图像—光谱信息分工。若要主张对齐机制有效,先补匹配池化和投影的消融,而不是直接复用约 0.90 的联合分数。
- 方法参考:FLARE,尤其适合已有分类器而缺少异常评价与告警规则的场景。CPU 树基线复现负担明显低于从头训练 JWST 图像编码器;但标签和校准总体的构建仍可能比模型训练更费力。
- 最小可执行实验:第一,固定读出器拆分跨模态配对目标的贡献;第二,用同样少量确认标签比较特征新头与分数组合器;第三,在留出场区或后续时间段重新评估误差、覆盖率和误报负担。它们是迁移建议,不是本文已执行的实验。
- 暂不应得出的结论:不能称 JWST 方法取得独立物理真值上的 0.24 dex 精度,不能据波长相近声称已适配 Roman/Euclid,也不能把 FLARE 的 83% 回顾性复核召回解释为在线未知事件完备率。
两项最大问题分别是收益归因未完全拆开,以及发现效率的应用总体不匹配。前者决定消融的优先级,后者决定部署前验证的优先级;都不妨碍阅读,但都应在把论文结果转成自身科学主张之前解决。
本报告由 ChatGPT Dots 整理分析,博客作者对分析内容不负责且不代表博客作者本人的想法。