一、本期总体分析
arXiv 论文时间范围:[2026-10-20 05:03:52, 2026-10-21 05:03:52)(Asia/Singapore) 各分类篇数:astro-ph 192;cs.CV 505;cs.LG 817;cs.AI 789;stat.ML 108(含跨类,分类间可能重复) 入选篇数:2
两篇研究面对同一种现实约束:已经观测到很多天体,却只对其中一小部分拥有可靠标签,而且有标签的对象并非随机抽取。光谱红移集中在较亮、较易观测的星系;已知行星状星云偏向发射线较强的天体。直接把这些样本当作总体,会把已有观测的选择偏差带进机器学习结果。
Roman-SOMPZ 的处理方式是拆分任务:分配红移层析箱需要较好的排序,恢复每个箱的总体红移分布则更怕灾难性离群点,因此分别使用不同估计器。M31 检测研究则调整训练监督和评价对象:没有标注的像素不自动充当负例,重复检测合并为独立天体,再按有限后随预算评价排序。两者都没有通过增加模型复杂度来回避标签问题。
证据也各有边界。Roman-SOMPZ 在同一套模拟里改善了大多数层析箱,但未把新增参考红移自身的误差完整传播到宇宙学分析。M31 研究有真实影像、空间隔离测试和独立窄带检查,实际天文验证更直接;不过,找回已知明亮星云的能力不能代表对未知暗弱总体的完备性。
建议优先读 Roman-SOMPZ 的第4节、表2和附录A,约30–40分钟,重点看两个红移估计器为什么承担不同角色。随后用约35–45分钟读 M31 论文的第II–V节,关注负例定义、P@200 的分母和候选的独立确认。若主要研究图像检测,可反过来阅读。
二、入选论文概览
| 优先级 | 英文标题 | 类型 | 核心贡献 | 数据或基准 | 代码状态 | 适用研究场景 | 一句话判断 |
|---|---|---|---|---|---|---|---|
| 1 | Extending SOMPZ beyond Spectroscopic Coverage for Roman Weak Lensing | 天文交叉 | 将层析分箱与红移分布校准分开,用 UMAP 与归一化流补足无光谱单元 | Cardinal 的 Roman+Rubin 模拟、COSMOS 光谱选择 | 官方基础流程已可访问,论文完整配置与新增方法的复现状态仍需区分 | 测光红移、弱透镜、非代表性标签下的总体推断 | 单体估计器的全局误差最小,不保证总体红移分布最好 |
| 2 | Newly Identified Planetary Nebula Candidates in M31 using Deep-Learning Search of Hubble Space Telescope Images | 天文交叉 | 不完整标签下的 Faster R-CNN 搜寻、固定预算评价与独立观测核查 | HST PHAT/PHAST、SIMBAD、CFHT MegaCam/SITELLE | 正文未给出可核验的完整训练仓库 | 稀有天体搜寻、正例与未标记数据学习、候选排序 | 排序质量明显优于颜色选择,但不能把175个候选称为175个新发现 |
三、逐篇深度分析
1. Roman-SOMPZ:先区分“把对象分到哪里”和“这组对象的红移是什么”
基本信息与科学问题
作者为 Yufei Zhen、Chun-Hao To、Boyan Yin、Junzhou Zhang、Chihway Chang、Finian Ashmead、Brett H. Andrews、Daniel C. Masters、Jeffrey A. Newman、Tianqing Zhang,代表 Roman HLIS Cosmology Project Infrastructure Team。本文版本为 arXiv:2610.24066v1,首次提交于2026年10月16日18:00 UTC,分类为 astro-ph.CO、astro-ph.IM。可读官方HTML正文或PDF。当前分析针对预印本,不能把它写成已经通过同行评审的最终结论。
弱引力透镜需要知道源星系与透镜的相对距离,因此一个红移箱内的总体分布
论文第1节明确区分 individual photo-z performance 与 photo-z characterization。前者描述单体预测误差,后者描述总体分布恢复。全文的贡献主要在后者。其方法不直接为所有宽场对象换一个回归模型,而是在原有深场到宽场的映射中,补足缺失的红移参考信息。
数据:用真实光谱选择模拟一个不完整参考集
主要实验基于 Cardinal 模拟星表,不是真实 Roman 观测。Cardinal 利用 ADDGALS 构建星系总体,含多波段通量及误差,本文使用的星系覆盖至约
对尺度长度为0.3角秒的指数轮廓源,假定的宽场与深场5σ深度分别为25.4、26.7等。宽场设置为三次抖动、两轮、107秒曝光,深场为三次抖动、五轮、294秒曝光。这些是本文模拟观测方案的输入,不是对未来实际巡天执行情况的保证。
不完整光谱样本的制作分为两层。首先从 COSMOS 光谱汇编取质量标志
作者在宽度为
最后要求合并的 Y/J/H 信噪比大于18,并去掉任一深场波段星等达到30或更暗的异常对象。得到28,583个光谱参考对象、3,446,009个深场对象和66,234,521个宽场对象。光谱参考集约覆盖
这里没有输入图像裁剪、PSF匹配或光谱连续谱归一化。直接输入是模拟测光与颜色;相关图像测量和噪声真实性由引用的数据生成流程承担。不能因为使用了真实 COSMOS 的误差分布,就认为所有跨波段相关误差或真实观测系统学都已覆盖。
基线的数据流与失败原因
SOMPZ 训练两张自组织映射:深场是
其中
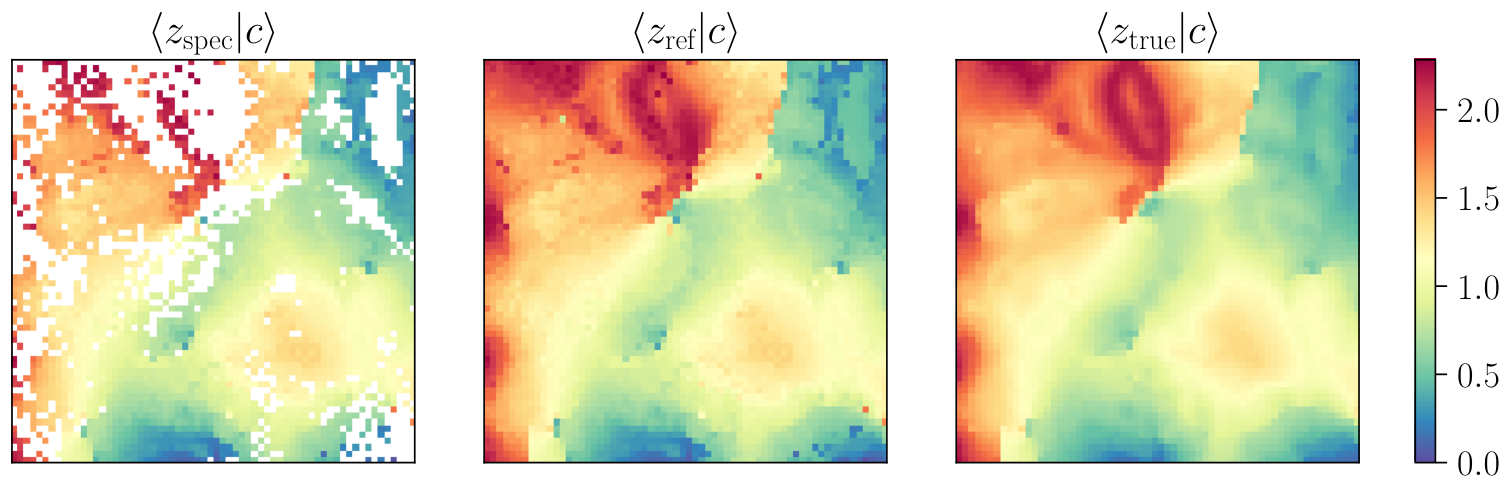
当某个深场类型完全没有光谱时,增加同类型的测光对象不会凭空产生红移。本文有26.6%的深场对象落在这样的单元中;宽场也有7.2%的对象因所在单元没有光谱,无法被原始流程分箱。两个缺口不同:前者缺少条件红移分布,后者连进入哪个箱都没有确定。
两个估计器分工,而不是简单拼接
第一步解决分箱。作者用28,583个光谱对象训练 FlexZBoost,在高信噪比深场测光上预测单体
这一步会保留先前排除的高红移对象,却不修复其红移参考缺口,所以仅改善分箱有时反而增加高红移箱的分布偏差。图8和表2提供了这个反直觉但重要的对照:获得更完整、分离更好的样本,不保证对这个样本的总体推断更准确。
第二步才填补深场单元。UMAP-flow-z 把七个深场颜色
压缩成三维坐标
UMAP 在完整深场的无标签特征上拟合,属于使用目标域特征的传导式设置。随后以光谱参考样本的均值和标准差标准化三个坐标及红移。标准化统计量在内部90%/10%训练—验证划分之前计算,因此内部验证并非完全独立的预处理;不过,目标深场对象的真红移没有进入这一步,不能将两者混为标签泄漏。
附录A给出了密度网络的可复现细节:FlowJAX 19.0.0、八层 masked autoregressive flow、有理二次样条、12个结点、标准化空间中的区间
预测时固定目标对象的三个 UMAP 坐标,对红移方向切片并归一化:
实际在0至3之间用间隔0.02的151点网格计算,减去每个对象最大的对数密度后指数化,以避免数值下溢。最终仍取后验中位数,只把无光谱深场单元中的对象加入红移参考集,原有光谱保持不变。模型虽然生成概率分布,最终校准流程使用的却是点估计,这个区别关系到后文的不确定性判断。
定量结果:明显改善,但远未全箱达标
表2报告的是
| 配置 | 箱2 | 箱4 | 箱6 | 箱7 | 箱8 | 箱9 |
|---|---|---|---|---|---|---|
| DES-SOMPZ | -45.5 | -25.0 | -31.4 | -16.9 | -2.2 | -11.6 |
| 仅改分箱 | -37.4 | -5.1 | -1.6 | -17.5 | -32.1 | -9.8 |
| FlexZBoost 补参考 | -28.3 | -0.9 | 0.2 | 8.7 | 16.0 | 3.5 |
| UMAP-flow-z 补参考 | -26.4 | -1.4 | 0.1 | 7.3 | 11.6 | 2.1 |
相对 DES-SOMPZ,最终方案在九个箱中的八个降低绝对均值偏差,但箱8由
UMAP-flow-z 的优势不是更小的全局散布:正文称它在无光谱单元中比 FlexZBoost 的 NMAD 更大,却有更少的离群点,最后三个箱的总体偏差反而较小。把“NMAD最低”直接作为所有下游用途的统一模型选择条件,在这里会选错评价目标。
误差条来自100次总体红移分布实现,传播样本方差和有限样本噪声。以最终配置为例,箱2为
第5节进一步做模拟宇宙剪切似然分析,采用
本文只保留九个层析箱,因为 Cardinal 在约2.3处截断;原本 Roman 配置最高的第十箱没有被检验。最高保留箱的真分布还有人为锐利上界。不能将这些结果直接推广为完整 Roman 高红移源样本的精度认证。
代码与证据评价
2026年10月21日核查了论文直接链接的Roman-SOMPZ 官方仓库。它并非空仓库:有 SOMPZ 实现、红移分布实现模块和 yaml/test_all.yaml 流程配置;README 给出安装与运行步骤。配置引用了具体数据文件,不能据此推定这些数据已经随仓库提供。论文的数据可用性声明仍称完整代码与本文配置将在接收后公开,本次没有确认新增 UMAP-flow-z 与所有结果已形成可直接重放的完整公开包。基础框架可用与本论文结果可复现,是两个层级。
因此,对“在该 Cardinal 实验中,两阶段修改改善总体红移分布”的证据可信度评为中高:有基线、分步对照、同分箱下的替代增强估计器和下游宇宙学分析。对“已解决真实 Roman 校准”的证据只能评为有限,不能用已经公开一个基础仓库补上尚未检验的域差异。
审稿人视角:最大问题与研究启发
最大的一个问题
新增参考红移的不确定性没有进入最终误差预算,所以对宇宙学可用性的判断仍是以增强预测固定为条件的结果。证据在第4.3.1节非常明确:增强对象的点估计被固定、以单位权重进入计数;既不重新拟合 UMAP 和归一化流,也不从单体红移后验抽样。测光标定和模拟总体误差同样不在这些误差条里。
这个问题比某一网络宽度是否最优更重要,因为方法的关键收益正来自原本没有光谱的对象,而最缺乏直接监督的区域恰好没有被赋予与其外推风险相应的变化空间。作者已经主动承认这不是完整校准预算,因而不应把它指控为隐瞒或认为点估计改善无效;需要收缩的是“误差已经足以支持精密应用”的强度。
最小关键验证是建立嵌套重复实验:保持宽场对象和分箱评价协议固定,对光谱参考样本重抽样、重新拟合嵌入与流,再从单体分布构造多个增强参考集,将所得
研究启发与可执行验证
模型应按下游统计量选择。用于排序的估计器、用于总体均值的估计器、用于完整概率校准的估计器,不必是同一个。可复用的设计是保留深场到宽场的转移结构,只替换缺少参考信息的部分,并用同一分箱下的替代增强器对照,避免把“换了样本”与“换了方法”混在一起。
迁移到其他测光任务时,可先做一个受控实验:有意遮蔽部分颜色—星等区域的光谱标签,比较不补参考、点估计补参考和多重插补,分别报告箱内均值、分布形状和覆盖率。若目标对象位于训练颜色流形之外,应单独标记而非只依赖流模型给出的平滑密度。这个建议尚未被本文实验完整验证,成本主要在重复拟合与下游似然计算。
2. 在 M31 的宽带图像里寻找行星状星云:训练时保留未知,评价时尊重未知
基本信息与科学问题
作者为 Yiğit C. Atılgan、Aleyna Demirci、Nazım Aksaker、Ammar Abbas Elmas、Mehmet Sarıgül、Aysun Akyüz。本文版本为 arXiv:2610.24554v1,首次提交于2026年10月17日08:21:30 UTC,分类为 astro-ph.GA。摘要页、HTML正文和PDF均可访问。本文是天文观测与深度学习交叉研究,结论应按预印本证据理解。
行星状星云是恒星晚期演化产生的电离气体外壳,并不是行星。它们可用于研究恒星族和星系运动,明亮端的光度函数也有距离测量用途。在 M31 的距离上,它们即使被 HST 观测,仍多表现为点源。在极拥挤的恒星场中,检测任务因而不是辨认一个清晰的环状结构,而是从大量点源中找出颜色、亮度和周围环境符合星云特征的少数对象。
F475W 包含 [O III] 双线和 Hβ,而 F814W 更多反映连续谱,因此典型行星状星云呈蓝色。但是蓝星、混合源乃至宇宙线残留也可能很蓝。传统颜色框会保留海量干扰源,研究重点是在有限后随预算下,把最有价值的对象排到前面。
数据与标签:635个正例并不代表完整的星云总体
第II节使用 PHAST 高层数据产品中的四块联合 drizzled mosaic,将 PHAT 与 PHAST 放在同一坐标系,来源为MAST 官方产品。PHAT 约0.5平方度、PHAST 约0.45平方度,覆盖 M31 恒星形成盘约三分之二。联合图像像素尺度为0.05角秒,每块约39,478×42,208像素。
所有模型使用 ACS/WFC 的 F475W 与 F814W;三个模型另加 WFC3/UVIS 的 F336W、F275W。原始 F814W 与 F475W 网格相差2像素,作者对齐后剩余偏移小于0.03像素。紫外图像来自717次访问的 drizzled 产品,逐访问修正位置后以最近像素映射到 F475W 网格。紫外只覆盖92%的训练图块和83%的搜寻区域,作者没有填补缺失值,而是在有覆盖区域训练及运行紫外模型。没有紫外的17%区域最终只依赖双光学波段成员,所以全巡天并不是处处使用同样的四模型组合。
正例起点是位于图像内的1065个 SIMBAD 行星状星云,其中791个有文献 [O III] 星等。旧目录位置与 HST 图像的中位偏移约0.54角秒,直接按坐标切图会产生错误标签。作者在1.25角秒内寻找局部峰,并要求 F475W 亮度与发射线星等预期相差不超过0.5等;多个峰都符合时弃用。部分位置采用 DOLPHOT 星表,最终保留635个正例。
这些标签有较强观测支持,却不完全无噪声:98%有 PN.S 的 [O III] 检测及速度,作者通过目录对照估计仍有约1.5%–3.2%不是行星状星云。训练负例为距任一正例至少200像素、按88类分层抽取的7871个 SIMBAD 非星云对象。泛称发射线天体的 EmO 类被排除出负例,因为其中可能藏着真正的星云。这里“目录没有归为 PN”不等于“已经可靠证实不是 PN”。
每个标签对象先截取512×512像素母图,共8506块。若按对象ID随机划分,相邻星云可能一方面作为测试目标,另一方面出现在训练目标的背景里。作者因此把相距小于270像素的对象连成空间组,共5066组,再按68%/12%/20%分配训练、验证和测试。最终训练有5784块与432个正例,验证1018块与76个正例,测试1704块与127个正例。分配还平衡发射线亮度、颜色、拥挤程度、背景、位置和紫外覆盖等观测属性,60项标准化均值差均小于0.10。
这样的设计避免近邻图像重叠,却刻意使各集合的已知天体属性接近,不能当作跨星系或极暗弱总体的域外测试。评价中进一步只保留所有模型都能看到紫外的固定窗口,验证903块、测试1512块,避免不同输入配置改变评价样本。
方法:不完整监督落实到了损失,而不是只写在动机里
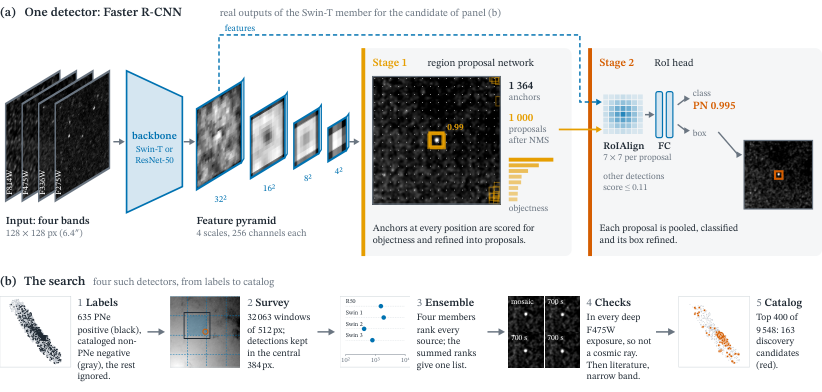
最终系统由四个 Faster R-CNN 组成:一个 ResNet-50+FPN,三个 Swin-T+FPN。共同数据流为多波段图块、主干多尺度特征、区域提议网络 RPN、RoI 特征池化、二分类与边框修正。ResNet 成员从 COCO 权重开始,训练最后三个块;Swin 成员用 ImageNet 权重初始化主干,FPN、RPN与框头随机初始化。Swin 的第四输入通道用预训练输入通道权重均值初始化。
ResNet 的三通道输入为 F814W、两光学波段均值、F475W;Swin 的四通道依次为 F814W、F475W、F336W、F275W。每个正例对应14×14像素框。默认 anchors 与这样的小框最佳 IoU 只有0.19,改成16至256像素的正方形 anchors 后为0.73。这个调整直接针对天体的像素尺度,不应把自然图像默认框尺寸原样搬过来。
两种归一化承担不同作用。百分位缩放使用每个图块跨通道共同的1%–99%范围,提供相对亮度和颜色信息;asinh 先减去每个通道的中位数背景,再用固定尺度变换,更能保留跨对象的绝对亮度差别。最终 ResNet 用128像素裁剪和百分位缩放,三个 Swin 分别使用128像素百分位、64像素百分位、128像素 asinh。组合来自不同输入表述和结构,而不只是换随机种子。
最关键的改动在背景损失。标准检测器把未落入正例框的 proposals 或 anchors 当背景;这里背景项只有满足标记负例监督规则时才受惩罚,其余忽略。最终阈值为0,使规则落实为图块级:没有负例框的图块忽略所有背景,含负例框的图块监督所有背景。因此不能简化成“只有紧贴负例的几个像素有损失”。作者报告中位61%的 anchors 被忽略。
这属于对不完整监督的实用修改,不是证明未知总体风险已被无偏估计的完整 PU 理论解法。它依赖标记负例附近漏标正例很少的经验条件。作者以额外已确认但未进入标签的对象核查,靠近负例64像素的比例约0.2%,给出了采用该近似的实际依据。
训练从母图随机裁剪,并将中心移动最多“半裁剪尺寸的0.875倍”,配合旋转和翻转。否则网络可能只学会标记图像中央。正例占采样图块的65%,每轮16,000个裁剪、batch size 16、训练25轮,首轮线性 warm-up,之后每5轮减半学习率。正文说明学习率经过各组预搜索,但没有给出足以独立重建全部最终训练的逐模型最优值与完整优化器参数;不能自行补写为某个标准默认配方。
作者报告 PyTorch 2.11、torchvision 0.26,在单张16 GB RTX 5080上训练一轮完整25-epoch配置约22–37分钟,四成员扫完整图约1.8小时。这是论文报告值,本分析没有执行其代码或复测硬件性能。
评价与对照:73%不是候选纯度
论文的 P@200 是最高分200个独立天体中“已知 PN”的比例,先把重叠窗口里的同一天体按0.75角秒合并。测试窗口实际只有114个不同的已知 PN,所以即使完美排序,P@200上限也只是
| 方法 | 前50个中的已知PN | 前100个中的已知PN | 前200个中的已知PN | P@200 |
|---|---|---|---|---|
| 单个 Swin-T | 41.4 | 68.7 | 82.4 | 0.412 |
| 四成员组合 | 42.2 | 74.5 | 83.3 | 0.417 |
| 颜色—星等排序 | 7 | 10 | 15 | 0.075 |
| 手工特征逻辑回归 | 1 | 1 | 3 | 0.015 |
数据来自原表4;单模型为三个种子的均值,组合为每成员抽一个种子的81种组合均值,小数不是某一真实列表含有零点几个对象。原表的82–86等范围是种子组合范围,不是95%置信区间。
颜色和逻辑回归基线采用训练集拟合,在同一窗口上用相同去重与排序预算比较。其峰值检测可找回98%–99%的已知PN,弱点主要是如何把众多相似蓝色源排到后面,而非没有定位到天体。组合相对颜色基线的P@200约提高5.56倍,这支持像素检测利用了颜色框之外的信息。由于很多对象无标签,未标记检测未必是错误,已知PN比例只能给出真实纯度的下限。
组合本身没有在 P@200 上显著胜过最佳单成员,验证集的选择规则甚至首先选出单模型。作者保留四模型主要看较短列表的质量和污染物互补:在验证前50个中,异构成员组合比单模型多约3.8–6.4个已知PN,且某些热星污染被紫外输入抑制。然而,组合选择也用过这个验证集,不能将这部分数值当作完全独立的增益证明。
主干比较同样需要克制。受控比较中没有替代主干被证实优于 ResNet-50;只有 ConvNeXt-T 达到作者设定的等效标准,其余区间较宽。后来对 RT-DETR、RF-DETR、U-Net 的测试每种只训练一次,没有同等调参,得到已知对象上限的42%–64%,低于当前成员。但它只说明这些具体配置未超过现有配方,不支持“两阶段检测普遍优于 Transformer”的架构结论。五折空间交叉验证中,四个成员都约为上限的69%–71%,单次划分的主干优劣排序也没有稳定保留。
从检测到发现:独立观测把结论大幅收紧
正式扫描先用全部635个正例重训,旧测试对象参与重训后的结果不再作为独立检测性能。作者把训练期测试与最终目录明确分开;性能表仍用仅训练子集训练的模型。扫描采用512像素窗口、384像素步长,每个位置只保留距离它最近窗口中心的一次输出,避免边缘退化和重复计数。共扫描32,063个窗口。
模型原始分数不能直接平均:同样0.995的分数在三个成员中对应的已知纯度可分别为91%、74%、37%。作者因此按单位面积给每个成员相同候选预算,汇总排名而不是把分数误当成可比较的概率。已有标签正例从发现列表移除,保留负例以显示失败情况,最终列表有9548个候选。
对前400个进行多层检查后,跨目录检索留下175个发现候选,其中12个被标记为宇宙线。这个计数不等于175个新PN,也不等于全部400个都没有先前文献记录。宇宙线检查利用不同时间曝光:在至少三次超过100秒的深曝光中只出现一次、最低与最高信噪比比值不超过0.05时标记。对100个已知PN测试没有误标,但其95% Wilson区间仍允许最高3.7%的误标率。前400中还有72个仅靠曝光无法决定,不能将它们自动算作真实天体。
随后用从未进入模型输入的 CFHT MegaCam [O III]与宽带
175个候选里只有一个在两个历元都显示一致的 [O III]过量,并在九次独立曝光中可见。它的 F475W−F814W 为−1.13,约
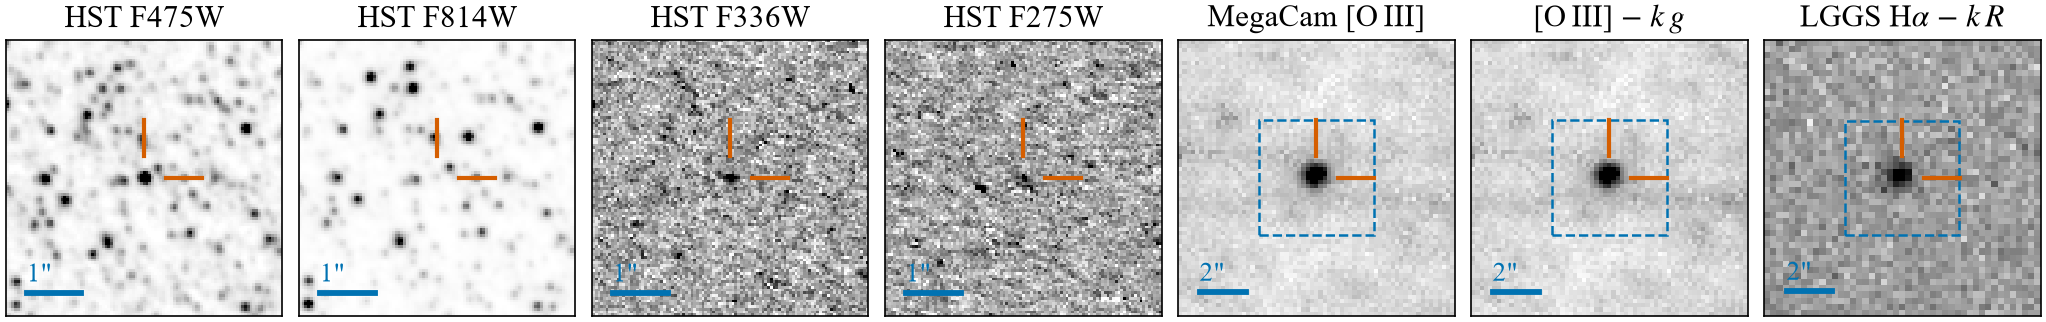
其余候选大多没有一致的发射线证据。作者比较了局部深度和典型已知PN的宽带—窄带关系:对156个候选,如果它们像已知PN那样有强 [O III],应能被检测。因此多数候选不属于已知的强发射线总体。但这仍不能排除弱 [O III]星云,因为参考PN本来就是按强 [O III]找到的;缺少发射线既可能是普通恒星,也可能是弱线PN,需要更深数据或光谱。
模型机制、复现条件与证据判断
作者通过干预而非只展示显著性图来研究模型。将三通道都替换为F475W、保留形状与亮度而去掉颜色后,ResNet设置在验证和测试的P@200分别由0.246、0.362降为0.017、0.013。这说明已训练模型依赖颜色,但灰度输入同时构成域偏移,不能据此断言重新训练的单波段模型一定无效。
反过来,随机采集的未入目录蓝色源中,即使颜色和亮度落入PN区域,模型在0.9分数处也只接受约2%–7%,对已知PN则接受84%–86%。因此它不是简单颜色阈值器。早期模型的周围背景实验提示,局部恒星光环境会作为先验影响边缘候选;但背景与星系中心距离相互相关,不能宣称模型已直接识别出某类恒星族。
在所读正文与官方链接中,没有找到对应完整训练代码、权重和目录数据的可核验公开仓库。MAST影像可访问并不代表标签重定位、负例采样、空间分组、排名汇总和全部模型参数已能直接复现。正文还存在一处需要澄清的表述:第III.8节说全数据重训模型保留末轮权重,第IV.1节提到测试使用验证挑选的最佳epoch;报告测试指标应理解为训练子集模型的实验结果,而非直接把它当作最终目录模型的无条件性能保证。
对“在固定窗口中更有效地找回已有PN”的证据可信度评为中高:空间分组、同样本基线、多种子和独立发射线检查相互支持。对“发现目录的真实纯度与未知PN完备性”的可信度评为有限,作者对这个区别也有充分讨论。没有公开复现包降低的是独立验证便利度,不应抹去其已经给出的观测证据。
审稿人视角:最大问题与研究启发
最大的一个问题
标签选择与发现目标存在同源偏差:训练和主要性能测试都围绕已知、偏亮且 [O III]强的PN,因此不能据此确定模型对原目录漏掉的暗弱、弱线总体有多完整。论文第V.2节给出直接证据:单模型对未参与训练的已知对象总体召回约0.695,但在
这是比换主干或增加组合成员更重要的限制。研究想找到遗漏天体,但独立测试仍主要由旧选择函数留下的标签组成。空间隔离能防止近邻泄漏,无法补出旧巡天从未观测到的对象。更进一步,独立窄带检查仍有深度与发射线选择限制,不能用“没有线”完成对未知总体的全面真值确认。
作者在第VII.6节明确承认标签不是完全随机选择,并提出合成PN注入。最小关键验证应把已知样本测试与注入恢复实验分开:在真实HST背景中注入覆盖亮度、颜色、连续谱占比与拥挤程度的点源,测量检测概率;再对模型选中与未选中的真实对象做按属性分层的深光谱抽查。注入只能校准给定外观下的检测完备性,不能独立证明某个外观就是PN,后者仍需要天文学分类信息。两部分合起来,才可能建立面向漏检总体的选择函数。
研究启发与可执行验证
对稀有天体搜寻,最可复用的部分是监督与评价规则,而不是四个模型的具体组合。应把已知负例、未标记对象和已确认正例分开;固定评价窗口,以独立天体去重;在真实后随预算下比较排名,并保留“纯度下限”和“已知总体召回”的限定。
实际迁移可做三个小对照:在完全相同划分下比较标准背景损失与部分监督;比较原始分数平均与单位面积预算下的排名融合;对候选增加一种训练未用到的观测验证。成本主要来自可靠负例整理、候选身份去重和后随观测,而不是堆更多网络。若另一巡天缺少紫外覆盖或独立曝光,其污染控制效果不能直接套用本文数值。
四、跨论文结论与行动建议
两篇工作的共同价值在于把“没有标签”拆成不同问题。Roman-SOMPZ 已有测光对象,只缺红移参考,因而尝试在颜色结构上插补;M31 图像中连未知PN的身份都不确定,因此训练时保留未知、输出后再用独立观测缩小候选范围。前者的关键风险是预测误差被低估,后者的关键风险是测试真值未覆盖发现目标。
两篇也提供了同样重要的反例:增加可用对象数量不保证科学结论更准。Roman-SOMPZ 仅改分箱就会使某些高红移箱更偏;M31 把训练标签增加47%没有检出明显收益,候选列表增长也不等于新PN数量增长。论文贡献应写成可定位的方法改动及其验证结果,而不是笼统的“利用更多数据提升科学发现”。
- 优先精读 Roman-SOMPZ 的式(1)、表2、第4.3.1节和附录A。可立即尝试的迁移实验是固定目标对象,分别评价排序、总体均值与概率校准,并显式扰动新增标签参考。
- 将 M31 的部分监督和固定预算评价作为图像搜寻方法储备。第II.3、III.2、III.4节可直接转化为数据划分与检测损失检查;第V节则说明模型输出如何接受独立天文证据检验。
- 复现前先补齐发布材料。Roman 的基础工具链可读,但完整新增方法与本文数据配置仍需核实;M31 的论文描述尚不足以无歧义重建所有配方。先做最小机制对照,优于直接声称复现整篇结果。
- 暂时不要作出的结论包括:光谱缺口已被机器学习完全解决;概率模型输出意味着完整不确定性已经传播;73%等于新候选纯度;175个发现候选等于175个新星云;某个检测架构已普遍胜过所有替代方案。
最大的两个问题并不降低这两篇的阅读优先级,反而决定了应从中学什么:缺失标签可以通过模型缓解,但模型不能自行创造独立真值。可靠的下一步是测量新增参考的不确定性,或用覆盖目标总体的新观测验证候选,而不是仅在旧测试集上继续提高一个总分。
本报告由 ChatGPT Dots 整理分析,博客作者对分析内容不负责且不代表博客作者本人的想法。