一、本期总体分析
arXiv 论文时间范围:[2026-10-19 05:03:49, 2026-10-20 05:03:49)(Asia/Singapore) 各分类篇数:astro-ph 133;cs.CV 201;cs.LG 391;cs.AI 344;stat.ML 64(含跨类,分类间可能重复) 入选篇数:1
本期论文把一个常被简化的问题展开了:联合巡天的测光红移收益,不能仅由波段覆盖和单波段深度预测。测量偏差、非高斯尾部以及不同波段之间的误差相关性,会改变颜色分布,继而改变红移退化和离群率。
作者没有提出新的深度网络,而是用梯度提升树、条件分位数和 Student-t copula 构造经验测光误差模拟器,再把它接入红移分析。最有用的部分是这套分层方法:先问测光是否可靠,再问误差模拟是否保真,最后才问红移估计改善多少。最需要谨慎的部分也是中间这一层:模拟器在 Rubin 波段尚未准确复现全部相关结构,却承担了由旧模拟向新星表转移测量误差的任务。
建议优先精读第 3.4、4、5.3 节及附录 A,约需 40–60 分钟;若主要关心联合测光流程,再补第 2–3 节。论文适合作为测光误差建模和巡天比较的设计参考,不宜把其中的离群率直接当作未来真实巡天的性能预测。
二、入选论文概览
| 优先级 | 英文标题 | 类型 | 核心贡献 | 数据或基准 | 代码状态 | 适用研究场景 | 一句话判断 | arXiv |
|---|---|---|---|---|---|---|---|---|
| 优先精读 | Combining Rubin and Roman photometry and its implications for photometric redshift estimation | 天文交叉:机器学习与测光分析 | 将偏差、条件残差分布和跨波段相关性组合成可采样的测光误差模型 | OpenUniverse 2024、Roman DC25 模拟、更新的 Diffsky 星表 | 引用了公开基础软件;未确认本文端到端实现与训练产物公开 | 多巡天联合测光、模拟星表、测光红移压力测试 | 比较误差机制比单纯比较预测器更有价值,但迁移后的误差联合分布仍需验证 | 2610.22547v1 |
三、逐篇深度分析
从图像测量误差到测光红移:联合 Rubin–Roman 的收益如何被改变
基本信息与研究问题
标题:Combining Rubin and Roman photometry and its implications for photometric redshift estimation。
作者:Tae-hyeon Shin、Rachel Mandelbaum、Chun-Hao To、Axel Guinot、Andrew Hearin、Arun Kannawadi、Chihway Chang、Federico Berlfein、Kaili Cao、Nihar Dalal、Michael Gabe、Christopher Hirata、Katherine Laliotis、Sidney Mau、Michael A. Troxel、Masaya Yamamoto,以及 Roman HLIS Cosmology Project Infrastructure Team。
版本与分类:arXiv:2610.22547v1,astro-ph.IM。首次提交及当前版本提交时间均为 2026-10-15 18:43:40 UTC;摘要页注明已投 MNRAS,不等于已经接收。原文入口:摘要、HTML 全文、PDF。未在本文找到独立项目页或对应整套分析的官方代码仓库。
一句话结论:值得精读;最应借鉴的是将测光误差作为有偏、异方差、跨波段相关的条件分布处理,而不是给每个波段独立添加一个高斯扰动。
科学目标是评估联合光学与近红外测光对星系红移的贡献。Rubin 的光学覆盖与 Roman 的近红外覆盖互补:4000 Å 断裂随红移移向近红外后,Roman 的信息尤其重要;低红移时,只有近红外则难以充分约束这一特征。红移估计又会影响弱引力透镜和星系聚类分析中的层析分组。
以往只依据名义极限星等加入统计噪声,可能忽略真实测量链产生的偏差。另一方面,为每一种星系模型重新生成图像、合成、检测、去混叠和测光,计算成本很高。本文尝试用经验模拟器连接两者:从一套图像模拟学到测量误差,再在另一套更合理的星系星表中重现这些误差。它的贡献是分析流程与误差表示,不是证明某个红移算法普遍胜过其他算法。
数据与样本:两套星系模型承担不同角色
这里使用的是巡天设计对应的模拟数据,不是实测 Rubin–Roman 联合星表。第 2 节区分了三部分。
第一部分是 OpenUniverse 2024。旧版 Diffsky 星系模型经 GalSampler 等步骤赋予 N 体模拟中的晕以星系及恒星形成历史,生成 SED、测光和由核球、盘、恒星形成结组成的形态。Rubin 图像由 GalSim/imSim 链生成,使用六波段 ugrizy、0.2 角秒像素,并提供 PSF、WCS 和方差图。作者指出旧星表的近红外颜色分布过窄、SED 有重复,会让红移估计过于容易。
第二部分是 Roman DC25 图像,沿用旧星系真值,但更新了仪器模拟与处理流程。本文只用一个约 1.23 平方度的 mosaic,选取 F106、F129、F158,简称 Y、J、H。IMCOM 合成后像素为 0.049 角秒,目标高斯 PSF 的 FWHM 为 0.24 角秒。文中列出的校准包括暗电流、平场、偏置、非线性、像素间电容、坡度拟合、跳变检测、去条纹和异常像素处理。不过,实际分析图像被特意简化为真值图像加相应噪声层,以避开尚未解决的背景过减问题。因此不能把这次测试写成含所有实际处理缺陷的端到端观测验证。
第三部分是用于最终红移实验的新 Diffsky 星表。它基于 Last Journey 模拟及合成低质量晕,模型参数由 COSMOS-20 测光拟合得到。作者把旧图像中学到的误差转移到新星表,并限制在
Rubin 模拟还有一处重要历史差异:原本意图对应五年观测的图像,每次曝光误用了 15 秒而非 30 秒,深度损失约 0.37 星等。作者没有直接把它当作当前五年深度,而是依据 OpSim v5.0.1 添加噪声,将图像降到 Y1 深度。Y10 的比较使用理论误差模型,不是把浅图像“增强”到十年深度。其 WFD 深度估计去除了高尘埃区、深钻场、机会目标和曙暮光观测,并取 HEALPix 区域统计的中位数。
H 波段样本要求相关噪声修正后的信噪比大于 5、CModel 拟合成功、没有去混叠子源,并与真值在约 0.15 角秒内双向匹配;还要求测量与真值星等差小于 1,且真值类型为星系。最终得到 273,451 个对象。这个依赖真值的清洁样本适于隔离测光问题,却不代表真实检测、匹配和分类的完整选择函数。
误差模型按对象随机分为 80% 训练、20% 测试;没有以独立天区验证误差迁移。最终红移样本采用理论误差定义的 H 波段十倍信噪比对应星等阈值,并在不同误差设置间保持同样选择。即使只输入 Rubin 波段,样本仍由 Roman H 波段选出。本文没有清楚给出新星表经最终筛选后的总样本数,不能沿用 273,451 作为红移实验规模。
测光处理:通量无偏与颜色可靠并不是一回事
第 3 节先用 Y、J、H 平均图检测目标,再以 H 为测量参考。检测阈值为每像素背景标准差的四倍、至少四个连续像素;没有再卷积检测核,以避免放大已相关的噪声峰。Scarlet Lite 在该平均图上完成去混叠,未使用多波段去混叠,最大峰数限制为 30。
参考通量采用 CModel,即核球加指数盘模型;颜色主要采用 GAaP,以 PSF 校正后的高斯加权孔径尽量匹配各波段的测量区域。其他 Roman 波段复用参考源的位置、足迹和形状。转到 Rubin 时,用 WCS 变换足迹并按 Rubin PSF 扩张。由于两仪器像素尺度不同,文中使用的软件路径无法直接完成跨像素尺度的 CModel 强制测光,因此 Rubin 使用 GAaP,而非九波段统一的 CModel 拟合。Roman 的最优 GAaP 孔径与 Rubin 的固定孔径设置也不同。
像素相关噪声是第一层相关性。IMCOM 合成使噪声相关长度约为输出 PSF 尺度,即约五个像素。单纯对角方差只统计每个像素自身的噪声,没有统计不同像素共同起伏的贡献。以第 3.4 节式(9)的拟合模板
相关函数由四份背景噪声实现估计。Y、J、H 的通量标准差修正因子中位数分别为 4.1、4.0、4.0;这是标准差因子,不是方差因子。忽略它会把信噪比高估约四倍,并改变信噪比筛选。
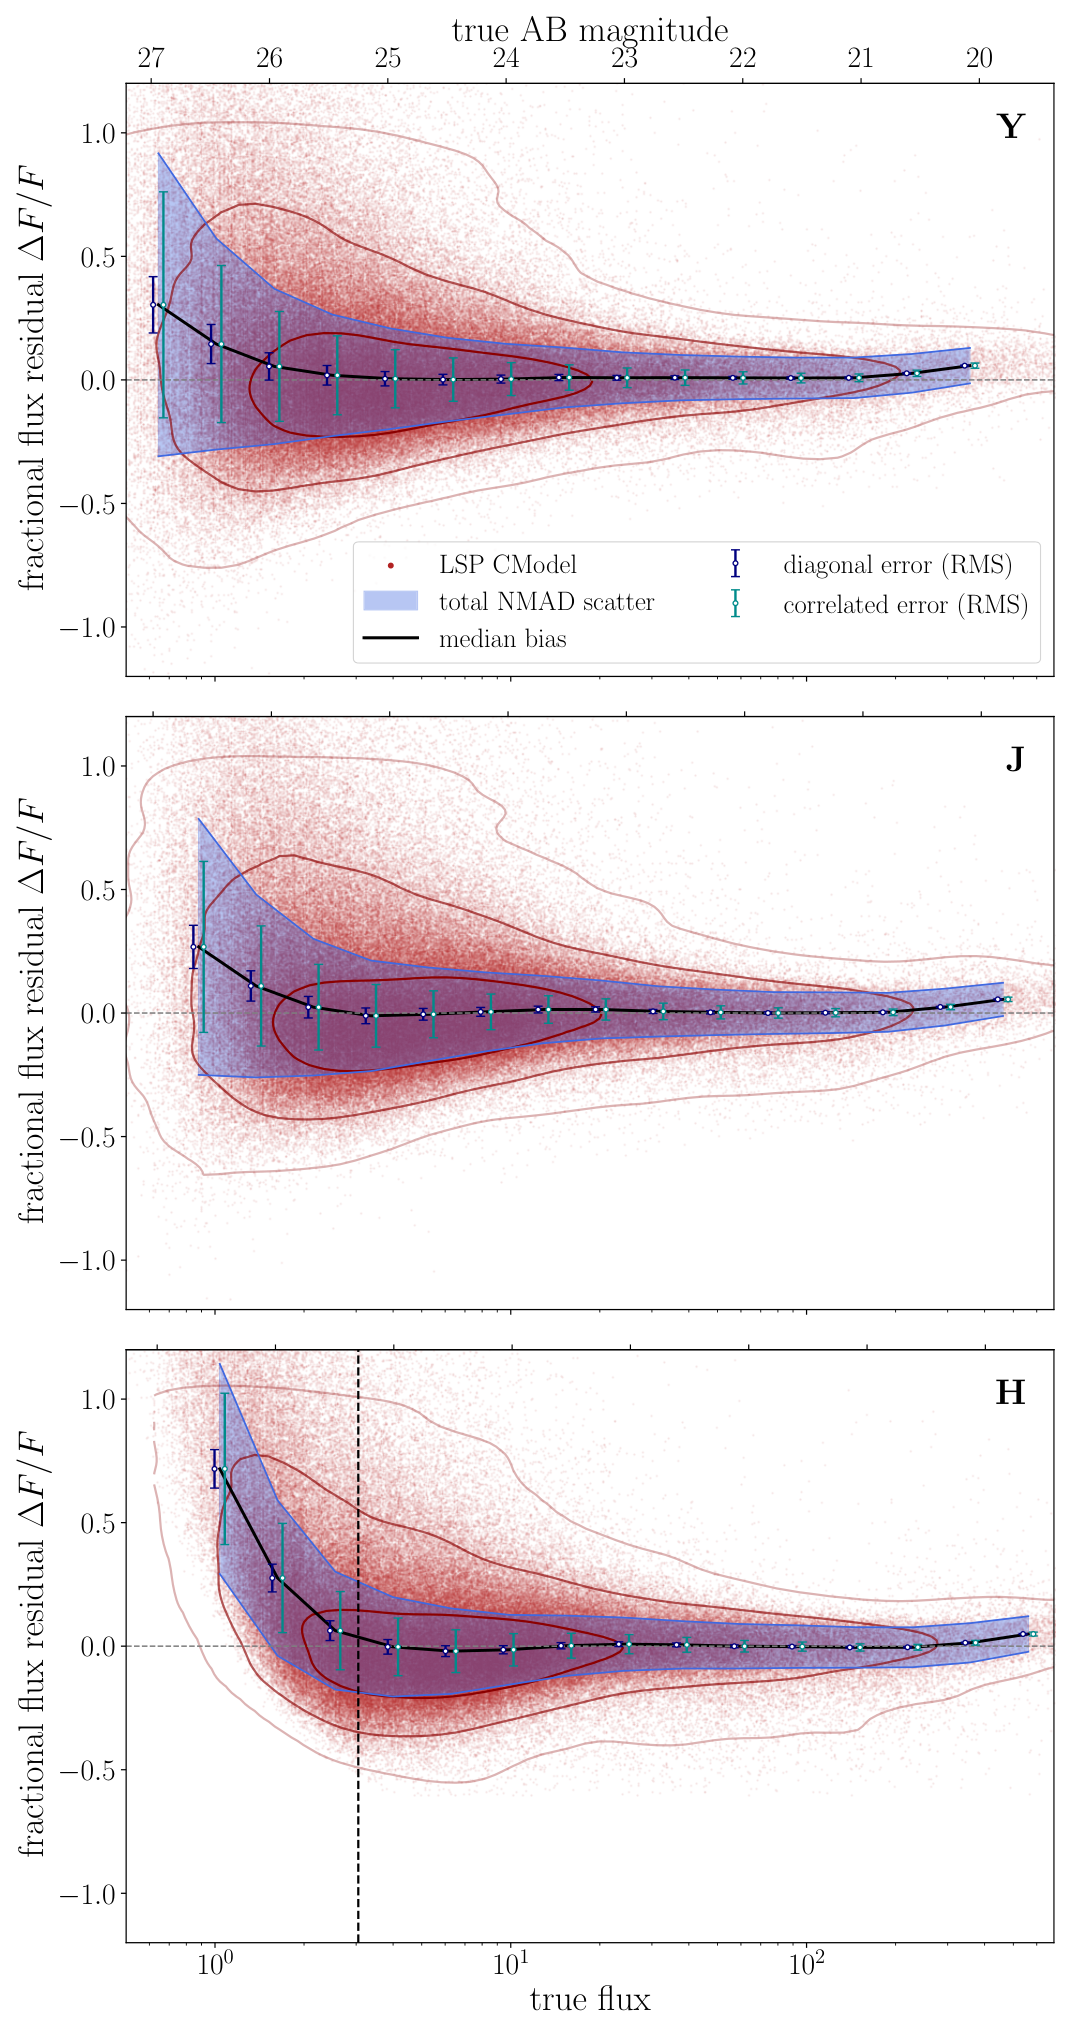
图 3–7 表明,CModel 的通量整体接近无偏,但亮端相对散布存在约 7%–8% 的底限。独立的 pgauss 孔径测光虽然存在明显总通量低估,也出现类似散布底限。作者选出 134,340 个孤立对象,占清洁样本约 49%;孤立对象仍保留超过九成的散布,因而在这套样本中,邻源混叠不是底限的主要解释。模型形态失配是作者提出的可能来源,不是已被单独实验锁定的原因。
跨波段测量误差是第二层相关性。同一对象各波段的共同通量偏差,可能在颜色相减时抵消。本文的 Roman 颜色在亮端没有呈现同量级底限,所以不能给每个波段独立加入 8% 噪声,就宣称重现了图中的系统误差。像素协方差影响一次测光的误差估计;波段间协方差影响颜色和后续红移,两者不能互相替代。
Rubin 的 u−g 残差更偏斜。用于颜色作图时排除负通量,会产生选择偏差;误差模型训练则保留负通量,仅排除 NaN。跨巡天 i−Y 颜色还出现约 0.05 星等的峰值偏移,作者解释为分辨率和有效孔径不一致。代表性训练集可能让机器学习吸收这种偏移,但不能因此保证非代表性实测样本不受影响。
经验误差模拟器:偏差、边缘分布与依赖结构分开学习
第 4 节及附录 A 的输入
每个波段的目标是相对通量残差:
第一步,用 scikit-learn 的直方图梯度提升树估计条件中位数
第二步,每波段训练 23 个条件分位数模型,分位点从 0.005 到 0.995。通过分段线性插值形成
第三步,把训练残差反解成分位排名,再通过自由度为 4 的 Student-t 逆累积分布映射到潜空间。在以训练集均值和标准差标准化后的星等空间中,寻找 500 个邻居,估计局部相关矩阵。Roman 三波段与 Rubin 六波段分开建模;作者在这套数据中发现跨巡天相关性不显著,因此忽略两组间的相关项。矩阵再以
生成时,先抽取相关高斯向量
共同的
这一设计的复用价值很明确:如果已有图像注入回收样本,可以用它快速生成星表级扰动,而不必每次重跑图像流水线。代价是训练多组分位数回归器、保存邻域参考数据,并为新对象查找近邻。本文没有给出足以量化端到端加速比、峰值内存或完整训练成本的计时结果;“更便宜”是流程层面的合理动机,不能替作者补出速度数字。
实验结果:误差模型改变了什么
误差模拟器首先在旧图像来源的留出对象上检查。图 10 的若干颜色分布吻合较好:在剔除两端各 2.5% 后,u−g 的实测残差中位数和标准差为 −0.26、0.95,模拟值为 −0.29、0.96;r−i 对应 0.02、0.51 与 0.00、0.55。这里是经过尾部裁切的残差统计,不是整个误差分布已被完整验证。
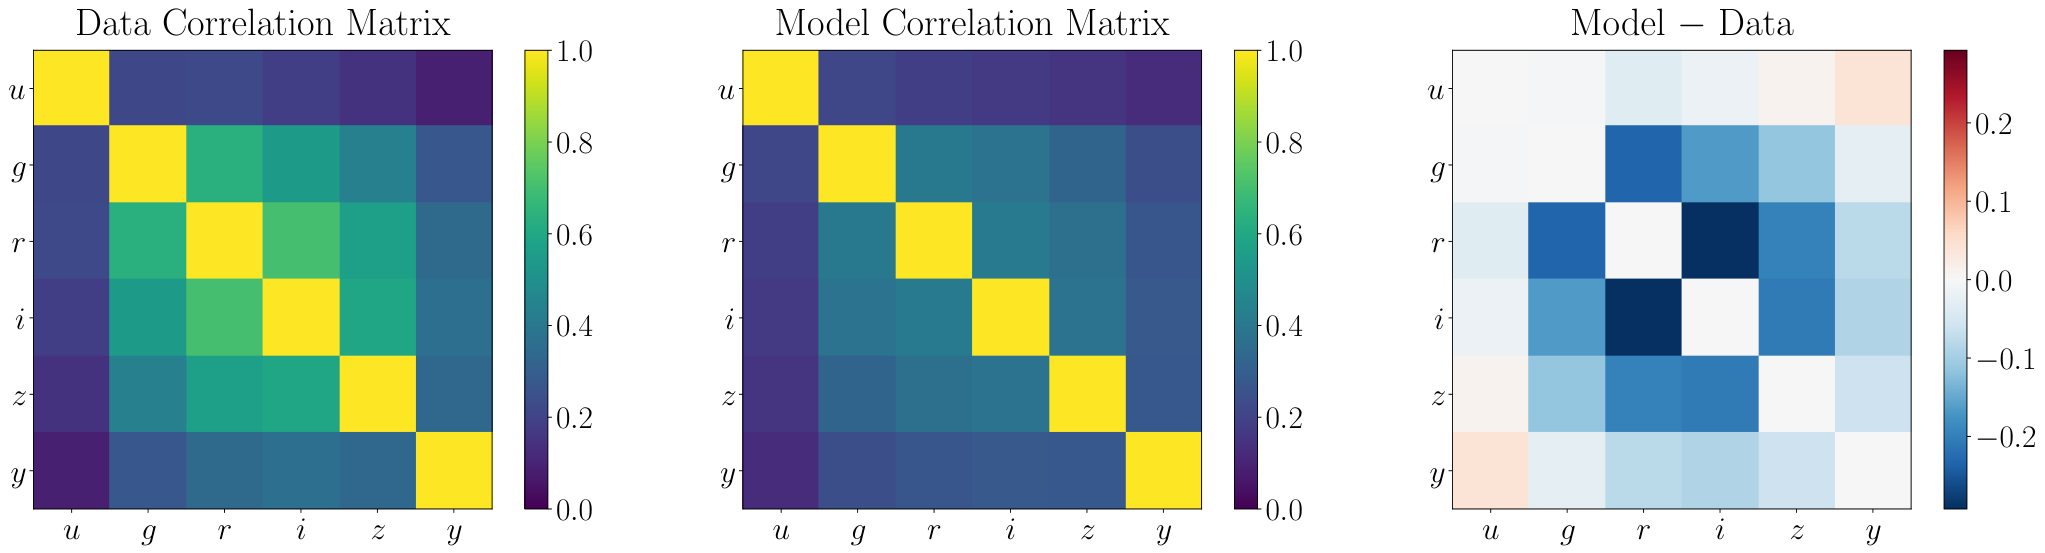
图 11 的 Roman 波段相关系数约 0.7–0.8,模拟与实测差异小于 0.01;Rubin 则存在更明显不足,实测约 0.2–0.7,而模拟约 0.2–0.4,个别相关系数差约 0.3。作者认为颜色直方图接近,暗示其对最终红移影响有限,并把差异与少量离群点或偏斜联系起来。但这只是解释,论文没有给出替换相关模型后红移结果是否稳定的直接对照。
红移阶段使用 RAIL 中的 FlexZBoost 与 LePHARE。FlexZBoost 用提升树预测条件密度的基展开系数,采用至多 35 个余弦基函数,75% 样本训练、25% 验证;峰值去噪阈值搜索 20 个值,密度锐化参数搜索 15 个值。作者特意采用具有总体代表性的训练集,以比较不同测光条件。LePHARE 使用 COSMOS 星系 SED 模板,允许尘埃与发射线贡献。论文只作定性算法比较,不把其配置视为公平寻参后的最终排名。
第 5 节定义
| FlexZBoost 的测光条件 | 稳健 NMAD | 离群率 | 稳健偏差 |
|---|---|---|---|
| 理想九波段真值测光 | 0.005 | 0.01% | 0.000034 |
| Roman+LSST-Y10,理论统计误差 | 0.022 | 3.6% | −0.00058 |
| Roman+LSST-Y1,理论统计误差 | 0.036 | 11.5% | −0.0014 |
| Roman+LSST-Y1,经验误差 | 0.065 | 24% | −0.006 |
以上数值来自第 5.2–5.3 节和图 13、16,不是实测巡天指标。理想情形把星等误差设为
最重要的比较是后两行:名义深度和对象选择相同,经验测量误差使散布由 0.036 增至 0.065,离群率由 11.5% 增至 24%。这不是新预测器提高或降低了性能,而是输入误差模型改变了任务难度。理论误差只按噪声与源尺度近似计算,并未保持与经验模型相同的全部边缘分布和协方差,因此不能把差值全归于某一种单独系统误差。
图 14–17 还显示,Roman 对 Rubin 的补充主要在
证据评价与复现条件
本文分析对“这套模拟中像素相关噪声显著影响误差估计”和“联合波段覆盖具有互补价值”给予较高可信度:有直接测量、明确公式和不同设置对比。对“经验误差相对简单统计误差会显著改变红移表现”给予中等偏高可信度,但数值适用范围限于本文的数据和流水线。对未来真实 Roman–Rubin 的绝对离群率预测,可信度为中低,作者本来也将其定位为比较研究。
除误差迁移外,还有几项应就近保留的边界。清洁样本依赖真值,且只覆盖一个约 1.23 平方度 mosaic;模型真值的盘加核球形态与 CModel 很接近;背景处理、坏像素和前景掩膜等缺陷没有完整进入最终图像。代表性监督样本比真实光谱训练集更理想。正文明确区分误差模型的留出测试和红移模型的验证,但未清楚说明后者调参集与最终指标集是否独立,因此不能声称已经完成独立盲测,也不能反过来断言发生泄漏。
文本还有一个需复核的小差异:第 3.6 节称 u 波段 NaN 最多涉及 1,222 个对象,而第 4.1 节称至少一波段 NaN 的排除比例小于 0.1%;若都以约 27 万对象为分母,这两个表述不一致,当前不能确定是否使用了不同过滤阶段。
OpenUniverse 2024 数据入口由论文明确给出;其余专有数据在 Data Availability 中写为合理请求后提供。作者引用了 LSST Science Pipelines、RAIL 和 Diffsky,但基础工具公开不等于本文 DC25 数据、经验误差训练模型与整套配置已经可一键复现。本文未提供足够证据确认后者已公开。
审稿人视角:最大问题与研究启发
最大的一个问题
经验误差模型迁移到新 Diffsky 星表后的联合分布准确性,尚未通过同一新星表的端到端图像对照验证;这直接限制了“经验系统误差使红移性能恶化多少”的定量解释。
证据集中在第 4.2 节、图 10–11 与第 5.3 节。模型在旧图像来源的随机留出对象上主要验证了若干颜色直方图和裁切后的相关矩阵,Rubin 相关系数仍可相差约 0.3;最终红移结论却来自把这个模型应用于新的 SED 总体。特征边缘范围覆盖和少数颜色直方图接近,并不能证明条件联合尾部已正确迁移。红移灾难性离群恰恰可能由少量颜色组合驱动,因此该问题比是否多用一种回归器更直接影响核心数值。
这不推翻论文关于测光质量重要性的结论,也不说明它报告的恶化方向错误。作者已经承认模拟的理想化、适用的固定仪器条件和 Rubin 相关性偏差;但“颜色分布接近,所以影响可能有限”尚未替代下游敏感性检验。
最小而关键的补充,是从新 Diffsky 总体选一个覆盖亮度、颜色和尺寸范围的独立子样本,在固定仪器与测光流水线下生成真实图像测量,同时用经验模拟器生成另一份测量;让冻结的同一红移算法分别处理两者,直接比较条件颜色联合分布、红移散布和离群率。只需小规模验证,不必立刻重跑全部模拟。若两条路径的差异显著小于经验与理论误差的差异,本文的定量解释就会明显更可靠。
研究启发与可执行验证
可复用的原则是:误差模拟器必须接受下游科学任务检验,不能只通过边缘分布验收。对于多波段推断,可先固定天体划分、选样和预测器,比较独立高斯、保留边缘但打乱跨波段配对、完整相关误差三种输入。这样能区分“噪声更大”与“依赖结构变化”的作用。
迁移需要有同一对象的真值或可靠注入回收测量,也需要输入总体处于训练支持范围。增加误差模型复杂度会增加拟合与验证成本,且不能自动补救真值标签或选择函数偏差。本文没有验证这种迁移会提升其他任务准确率;这里建议的是更可信的压力测试,不是默认有效的新模型模块。
阅读路线:精读第 3.4 节式(9)、第 4.1 节和附录 A 的采样过程、图 11 与第 5.3 节;选读第 3.1–3.3 节理解跨像素尺度测光限制。图 3 用来区分统计误差与经验散布,图 16 用来理解误差假设如何传到红移,不能只看摘要中的“约两倍恶化”。
四、跨论文结论与行动建议
本期只有一篇,重点不是选择两种模型,而是决定何时可以相信联合巡天的性能增益。
- 优先把它作为测光误差与模拟验证论文精读,而不是作为新的深度网络基线。
- 可先做三个小实验:检查像素相关噪声对信噪比选择的影响;固定边缘误差、只改变跨波段相关性;用独立图像注入子样本验证误差模拟器的下游红移表现。各实验都保持对象与预测器一致。
- 暂时不应据此宣称真实联合巡天必有 24% 离群率、全部恶化来自混叠,或机器学习预测区间已经校准。
- 最大验证缺口影响的是数值外推与复现优先级,不影响先借鉴其分层误差分析思想。若拿不到专有模拟数据,先在自己的可公开复现样本上验证该思想,不把复用基础软件写成复现了整篇论文。
本报告由 ChatGPT Dots 整理分析,博客作者对分析内容不负责且不代表博客作者本人的想法。