一、本期总体分析
arXiv 论文时间范围:[2026-10-16 05:04:23, 2026-10-17 05:04:23)(Asia/Singapore) 各分类篇数:astro-ph 173;cs.CV 253;cs.LG 467;cs.AI 453;stat.ML 78(含跨类,分类间可能重复) 入选篇数:2
本期两篇论文讨论的是不同的天文任务,却都提醒我们:分类器的分数只对它实际接触到的标签、输入和评价总体有效。Rubin 研究用星表与测光红移构建点源、展源标签,比较六类算法;Breakthrough Listen 研究冻结一个 CNN,检查信号形状、振幅和 ON/OFF 观测条件改变以后,它会漏掉什么、误报什么。两者最有价值的部分都不是刷新模型规模,而是把容易被总体指标遮住的失败情况具体展示出来。
Rubin 论文更适合优先阅读。它直接涉及多波段测光、形态量、测光误差、类别不平衡和跨场区应用,实验材料丰富。但它主要证明的是在特定自动标签规则下的分类能力,不能将随机留出集上的高 F1 直接解释成对全部暗弱天体的可靠分类。其独立 Euclid 对照和拥挤场测试尤其重要,文稿中若干相互矛盾的描述也必须保留在判断中。
第二篇适合作为检测系统审计的方法储备:在同一背景上成对注入信号,固定模型与判决阈值,同时衡量误报压制和真信号保留。它清楚展示了一个特定检测器的失败,却尚未分离“形态泛化不足”和“注入后的归一化协议变化”对亮信号召回下降的贡献。这不妨碍它成为有用的检查范例,但不足以推论所有射电 SETI 神经网络都有相同缺陷。
建议先用约 35–45 分钟阅读 Rubin 的标签构建、特征消融与局限,再用约 25–35 分钟阅读 SETI 的注入、过滤和失败解释。两篇都应作为预印本的证据分析来读,不把作者的解释等同于已经完成独立复现的结论。
二、入选论文概览
| 优先级 | 英文标题 | 类型 | 核心贡献 | 数据或基准 | 代码状态 | 适用研究场景 | 一句话判断 | arXiv |
|---|---|---|---|---|---|---|---|---|
| 1 | Multi-Method Machine Learning Classification of Astronomical Sources with Rubin Data Previews: a Spectroscopy-Free Approach with DP1 and DP2 | 天文交叉 | 用现有目录产生标签,统一比较颜色、形态与误差特征,并展示暗弱及拥挤场边界 | Rubin DP1/DP2、Monster、测光红移目录;文中报告 Euclid Q1 对照 | 查询公开;完整 notebook、脚本和分类目录尚待归档 | 点源/展源分离、多波段目录分类、选择效应审计 | 值得精读标签和评价设计,不宜直接照搬最高 F1 | 2610.20746v1 |
| 2 | Missed Detections and False Alarms in a CNN Technosignature Detector on Breakthrough Listen Data | 天文交叉 | 对冻结 CNN 做双向注入压力测试,同时计算误报及过滤后的真信号损失 | Green Bank 真实背景上的合成信号;Kaggle Breakthrough Listen 数据 | 官方训练、实验 notebook,逐样本结果、清单与权重可访问 | 稀有信号检测、异常检测、注入恢复与后处理评估 | 审计设计可复用,亮度反常的成因仍未确定 | 2610.22050v1 |
三、逐篇深度分析
1. Rubin:不依赖本地光谱标签,能把点源与展源分到什么程度?
基本信息:Andrés Alejandro Plazas Malagón、Yasna Ordenes-Briceño、Dan S. Taranu、Alex Broughton、Yumi Choi、Jeffrey L. Carlin、Sophie Reed、Karla Peña Ramírez、Sean Patrick MacBride、Hurum Maksora Tohfa、Arianna Ranabhat;arXiv:2610.20746v1,astro-ph.IM。首次提交及本版本时间为 2026-10-14 18:04:34 UTC。正文注明拟投 Open Journal of Astrophysics,并非已接收论文。可读摘要页、HTML 正文、PDF。数据平台是 Rubin Science Platform;尚未核实该研究完整实现的公开仓库,不能把平台自身的开源软件当作本文全部实验已开源。
一句话结论:值得精读,尤其是标签如何产生、测光误差为何显著提高分数,以及这些分数为什么不能直接推广到更暗、更拥挤的目标总体。
科学目标与贡献边界
点源与展源分离是构建恒星样本、星系样本和后续测光红移样本的基础。大巡天中的难点不只是分辨率不足:光谱真值通常偏向亮源、特定颜色或特定场区,直接用这些样本训练,也会引入选择偏差。本文尝试在没有额外汇集本地光谱标签的条件下,用 Rubin 平台已有资料构造监督信号。
这里的“spectroscopy-free”应按工作流程理解:作者没有为本次分类直接引入外部光谱目录,但其采用的测光红移估计器存在上游训练和验证资料,不能据此说整条信息来源完全不含光谱。论文输出的是点状与延展两类,不是经过物理认证的恒星、星系、类星体三分类;未分辨类星体与紧致星系尤其不应被自动赋予更强的物理解释。
方法增量主要是可在 Rubin 平台执行的比较与诊断流程,并非新的深度网络。它的研究价值在于,在相同标签、划分和特征上比较传统模型与 MLP,再追踪模型分数如何随样本构成和观测条件改变。
数据来源、样本选择与预处理
第 2 节使用 DP1 的 LSSTComCam 和 DP2 的完整 LSSTCam 测光目录,输入为六个光学宽波段
ECDFS 查询使用半径 1° 的圆锥区域。论文列出的 DP1 六波段 coadd 5σ 深度约为 24.5、26.2、26.0、25.7、25.1、23.1 mag;DP2 对应约为 24.4、25.8、25.5、25.9、24.8、22.2 mag。DP2 相机覆盖更大,不代表每个波段更深,因此同一个查询圆内对象更多与分类分数下降并不矛盾。这些是论文的场区统计,不应当作所有 DP2 天区的统一极限。
质量处理包括六波段 PSF 测光标志、
应注意正文第 2.2 节笼统说两版使用相同 cuts,但附录 A 明确 DP2 查询没有应用 DP1 的 reference-band sizeExtendedness_flag 条件。实施时应按实际查询逐项核对,不能只复制“相同筛选”的概括。附录展示查询而非完整清洗代码;例如空值、饱和阈值等还有查询后的处理。
底层仪器特征移除、PSF 建模、天体测量与 FGCM 标定来自 Rubin Science Pipelines,不是作者重新实现的图像处理。作者另对星等做银河消光校正,使用 SFD 尘埃图及相应重标定,再形成颜色。研究未使用需要自行说明的图像增强、图像重采样或跨波段 PSF 匹配训练步骤;缺失波段的主处理是排除相应对象,而不是学习缺失值填补。消光校正在所测场区对 RF 分数影响很小,但不能据此断言高消光或更大范围的颜色校正不重要。
监督标签有两条来源,且两者覆盖的亮度范围不同:
- 点源标签:对象在 1″ 内匹配到 Gaia 锚定的 Monster 恒星参考目录。ECDFS DP1 有 1,284 个,DP2 有 6,525 个。该参考样本主要覆盖亮星,论文概括亮端支持约止于
–21。 - 展源标签:采用 FlexZBoost 测光红移,要求 PDF 中心 68% 区间半宽小于 0.15、
、 。DP1 有 12,867 个,DP2 有 83,827 个。 - 同时满足两套规则时优先赋予恒星标签,避免同一对象获得两个类别。DP2 ECDFS 约 41% 的 Monster 恒星也满足测光红移“星系”条件,说明有一个置信度较高的测光红移本身并不等于该对象必然是星系。
因此,干净目录不等于有真值目录:DP1 的 83,232 个、DP2 的 399,151 个对象不进入这套有标签样本,只获得预测。对这些对象的真实性能必须另外测量。
从输入到输出:18 维特征为何有效,24 维特征又多了什么?
基础输入由六波段全部 15 个两两颜色与三个
第 3.1 节将扩展配置明确分开:基础 18 维;加六个 PSF 星等误差后 24 维;只加 refSizeExtendedness 后 19 维;两者都加后 25 维。星等误差近似满足
它把信噪比信息送入分类器,但这也意味着即使没有直接输入星等,模型仍可通过误差感知亮度、深度与测量条件。作者把这一组解释为质量/SNR 信息;本文分析认为,该解释与“同时携带标签可获得性的线索”并不互斥,须靠独立对照区分。
六类模型是 RBF-SVM、RF、XGBoost、KNN、MLP 和软投票。软投票按 RF、XGBoost、SVM 的概率以 2:2:1 加权,不是另一套神经融合模块。MLP 采用 ReLU 与 early stopping,DP1 选中两层各 100 单元,DP2 为 64、32 单元;正则项参数均为 0.0001。表 1 给出 RF 的 DP1 配置为 100 棵树、最大深度 20,DP2 为 300 棵树、深度 10;XGBoost 的树数/学习率/深度分别是 200/0.3/5 和 300/0.1/6。论文没有完整列出 MLP 的 batch size、实际停止轮数、优化器和全部训练耗时,不宜用软件默认值冒充已核实配方。
有标签对象先按类别分层随机作 70/30 划分,再对训练部分多数类欠采样。DP1 训练/测试为 9,905/4,246,欠采样后的训练集为 899×2;DP2 为 63,246/27,106,欠采样后为 4,567×2。标准化只拟合平衡训练部分,测试保留约 10:1 或 13:1 的星系优势比例。调参使用 5 折,另报告 10 折稳定性评估;二者不是同一次评价。正文未完整展示每个交叉验证折中标准化与欠采样的封装次序,不能进一步声称整个 CV 链路已经由代码排除泄漏。
这也是理解指标的关键:macro-F1 对两个类别的 F1 等权,不代表它不受测试类别比例影响。多数星系中很小的误判比例,就可能显著降低稀少恒星的 precision。平衡 CV 的 0.95–0.97 和自然不平衡测试的 0.87–0.92 不能作为同口径的过拟合差距直接相减。
结果:误差特征的收益很大,算法优势则有明确条件
以下均来自表 2、4、6–8,数值不跨口径混算。
| 数据与设置 | 结果 | 应怎样读 |
|---|---|---|
| ECDFS DP1,基础 18 维 | RF 与 Voting 的 macro-F1 均为 0.918;SVM 0.912、XGBoost 0.911 | 典型 68% bootstrap 半宽约 0.007,领先方法差距不稳固 |
| ECDFS DP2,基础 18 维 | ANN 0.873、XGBoost 0.865、Voting 0.862、RF 0.855 | 典型半宽约 0.004;“RF 总是最好”不是本文支持的结论 |
| ECDFS DP1,代表性固定 RF 的特征比较 | 基础 0.922,加误差 0.951,完整 25 维 0.958 | 表 4 明确这里不是表 2 的调优 RF,不能以 0.918 作为该消融起点 |
| ECDFS DP2,RF 特征比较 | 0.855 → 0.968 | 加入误差提高 0.113,但仍是原标签体系下的收益 |
| COSMOS DP2,RF | 0.810 → 0.974 | 大幅提升需要验证是否跨越标签选择与深度变化仍成立 |
| ECDFS DP1,简单 PSF−cModel 阈值 | macro-F1 0.933 | 单参数基线比基础 ML 更高,不能省略这一反例 |
| 低银纬 DP1 | 阈值基线 0.853,最佳 ML 0.948 | 多特征方法的优势依赖场景,不是普遍压倒形态阈值 |
在 ECDFS DP1,RF 的点源 precision 只有 0.776,而 recall 为 0.945;DP2 RF 的对应值为 0.595、0.965。高召回或接近 0.99 的 ROC AUC 并不自动保证高纯度恒星目录。论文的全目录六模型一致率也只是相互一致,不是真值准确率。
形态与颜色确实有互补:DP1 的三形态量 RF 为 0.883,纯颜色 RF 为 0.887,合并为 0.918。第 5.3 节报告 FWHM 的六方法平均置乱损失约 0.043,明显高于其他单项。但有相关颜色时,较低的单列置乱重要性不等于颜色整体无效。去掉
作者还报告概率可靠性:DP1 Voting 的 Brier score 为 0.023,XGBoost 的 ECE 为 0.027;isotonic 校准对部分模型有改善。但这些概率仍是相对于当前自动标签和样本比例的概率,不是无条件的天体物理类别概率。欠采样、目标天区类别比例改变、标签污染都可能使部署校准发生变化。
跨场区表格列有各场区的训练样本和平衡样本数量,应主要理解为相同流程和设置在不同场区的适用性,不能直接说“单个冻结 ECDFS 模型在所有场区都达到表中分数”。真正明确写成无重训迁移的是第 7.4 节:ECDFS 的
证据强弱与复现边界
对“颜色、形态和测光误差联合使用能够提高这套监督任务的分数”,可信度为中等:有多模型、消融、多个场区和类别指标,但代码尚未归档,且标签来自与输入相关的观测资料。对“已经能可靠分类全目录暗弱对象”,可信度为低,作者自己的暗端与拥挤场结果也不支持这种扩大解释。
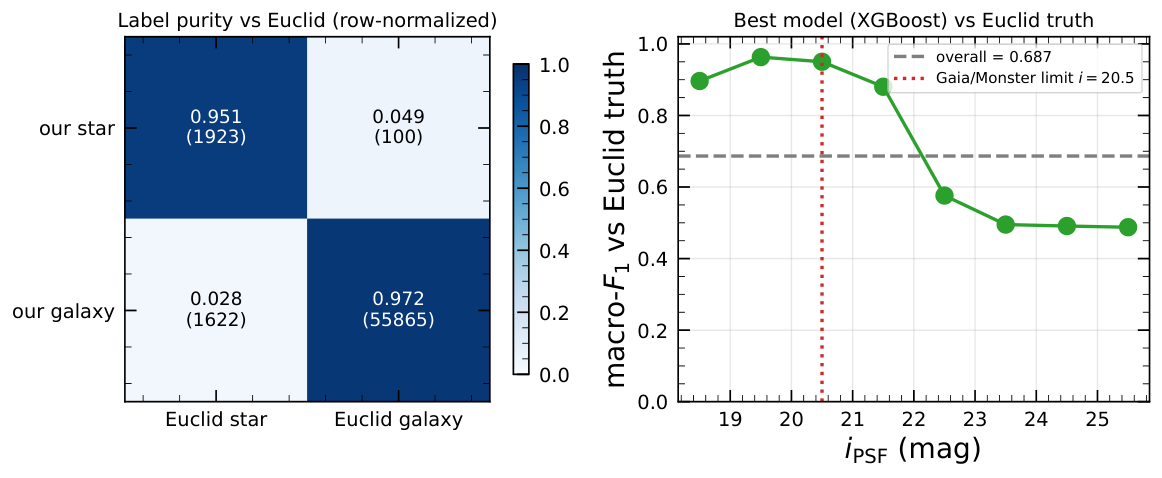
论文第 8.3 节报告 Euclid Q1 交叉匹配:有明确 Euclid 分类的样本中,约 96%–97% 的星系标签与 Euclid 一致;但只有约 19% 的 Euclid 星系通过当前测光红移及亮度 cuts 进入有标签样本。图 14 的亮端符合较好,
这里有一个必须指出的文稿冲突:同一节后面的 “Independent truth” 段又说 Euclid 是未来工作、本文未使用。本文只能确认“该版本存在图 14 与对应数值陈述”,无法替作者确定哪段代表最终实验状态。另一个较小冲突是第 5.2 节的 DP2 recall 范围与表 2 不一致,例如 ANN 点源 recall 在文字中为 0.972,表中为 0.957;本报告引用表 2 时明确采用表格口径,不把冲突抹去。第 2.7 节说
数据可通过 RSP 访问,但论文要求 LSST Data Rights Holder 身份,不应称作任何读者都可匿名下载。Data Availability 写的是 notebook、绘图脚本和分类目录将在发表版本时一起归档到 Zenodo;附录 A 的查询不能替代完整训练、切分与评价产物。当前没有足够证据宣称该研究已端到端可复现。
审稿人视角:最大问题与研究启发
最大的一个问题
当前最影响结论的根因是:训练与主要测试标签由具有不同亮度支持的两套目录规则产生,评价总体并不代表实际部署总体。因此高分可能同时衡量真实形态/SED 区分能力,以及模型对标签选择条件的适应程度。
证据集中在第 3.2 节的 Monster 亮星与
作者已明确承认标签亮度不对称、潜在星系标签污染和暗弱/拥挤场迁移限制,并提供了值得重视的外部对照陈述。因此不能批评其“完全没有意识到偏差”。但已报告的证据仍不足以证明 +Errors 的增益能跨选择函数保持,Euclid 使用状态的文字冲突又妨碍审计。该限制不会否定一个有效的目录工作流程,却会收缩其对完整巡天总体的适用范围。
最小关键补充是一套统一的独立评价:先冻结现有模型,在未参与伪标签构建和调参的深层形态/光谱验证对象上,以相同的亮度、SNR 和拥挤度分层,成对比较 Base 与 +Errors;同时报告各层真值覆盖率与未标注比例。独立真值仍有自己的选择函数,不能仅再做一次亮端交叉匹配就宣称问题消失。
研究启发与可执行验证
最值得复用的是把“特征新增收益”与“标签可获得性”分开检验。
- 为目录分类保留标签来源、匹配状态、亮度范围和未标注标记;先按这些量画训练与部署分布,再比较网络或树模型。没有足够重叠支持的暗端应报告未验证,而不是外推一个总体 F1。
- 固定对象、划分、模型预算后比较颜色+形态、再加误差、再做亮度/SNR 匹配的对照。采用按空间块或场区留出的第二套测试,以区别同场随机泛化与跨观测条件泛化。
- 概率校准应在独立校准集完成,分别报告恒星 precision、recall、星系污染和目标科学样本的选择函数;不要只用 AUC 或多模型一致率替代可用性。
这些是迁移验证建议,不是本文已经证明可提高其他巡天表现的方案。额外成本主要是真值构建、空间覆盖和小样本区间估计,未必是 GPU 训练。优先精读第 3.2、4.2、5.5、7.4、8.3 节,表 2、4、6–8 与图 13–14;PCA/UMAP 可选读,漂亮的二维分离图不能替代上述测试。
2. Breakthrough Listen:为什么更亮的注入信号反而更容易漏掉?
基本信息:Omer Imran;arXiv:2610.22050v1,astro-ph.IM、cs.LG、physics.pop-ph。首次提交及本版本时间为 2026-10-15 15:18:14 UTC。可读摘要页、HTML 正文、PDF;官方代码与结果仓库由正文明确链接。论文及仓库均将其标为尚未同行评议的预印本。
一句话结论:适合精读为检测器压力测试范例,尤其是固定阈值、配对背景和过滤保留率;对“亮信号为什么漏检”的机制解释必须保持克制。
科学问题、观测资料与任务定义
射电 technosignature 搜索要从大量自然背景和射频干扰 RFI 中筛出值得人工检查的候选。真实人工天体信号的形态未知,而训练信号通常是合成的,因此同分布验证集分数并不能保证搜索不会遗漏另一种形态。
本文不是普通光学巡天图像研究。它使用源自 Green Bank 观测的 Kaggle SETI Breakthrough Listen 竞赛资料,明确采用重新发布后的数据,而不是早先因泄漏撤下的版本。每个样本有六块
在作者的受控生成规则中,目标信号只注入 ON,干扰注入六块面板。这是实验标签定义,不是“所有真实 RFI 必然在所有 OFF 观测中出现”的无条件物理定律。真实干扰会随时间和方向变化,ON/OFF 对照也不能单独证明外星技术来源。读者应将本文结果理解为候选筛选的可靠性检验,而非对真实天外发射源的确认。
检测器真正看到的数据
作者沿用公开竞赛 baseline:可学习缩放器后接 EfficientNet-B0,只训练一次,再冻结全部参数。原始六面板先删除 OFF,只保留三个 ON;堆叠为 CustomModel.forward 进一步显示,可学习缩放器由卷积、BatchNorm、LeakyReLU 和双线性残差路径构成,输出尺寸设为
训练 notebook 的配置是 seed 42、五折中的 fold 0 验证、15 epochs、batch size 32、AdamW、BCEWithLogitsLoss,权重衰减
作者按验证 AUC 选 checkpoint,同时在该验证折的 10,800 个负样本上选定 99% 分位阈值
最直接的结构事实是:OFF 在输入阶段已被丢弃。只改变 OFF、保持 ON 完全相同时,当前模型输入不会改变,所以不可能依靠 OFF 来区分两者。这是确定的信息可用性限制,无须从 Grad-CAM 反推。不过它不等于所有 SETI 网络都有同样结构;本文相关工作明确指出已有方法会利用完整 cadence。
注入设计:15,000 次实验只有 300 个背景
第 3.3 节构造十种形态,每种五个峰值振幅 0.25、0.5、1、2、4,每格 300 次,共 15,000 次。振幅以已归一化竞赛背景的近似噪声标准差为单位,不是一个跨形态恒等的积分信噪比。
目标方向包括:每面板漂移 60 通道的直线、60 通道曲率的二次曲线、振幅 ±25 通道的正弦 S 形、占空比 35% 的脉冲线,以及具有频率依赖到达时刻的弥散状 burst。干扰方向包括:零漂移、四条间隔 18 通道的梳状线、间歇线、宽带脉冲、漂移 45 通道的直线。窄线频率宽度为 1.2 通道;起始位置、背景编号和随机种子保存在 manifest。
设计有两个很有用的控制。首先所有形态共用同一批真实背景,可以把注入分数和其原始背景分数成对相减。其次网络权重和判决阈值始终不变,避免为每个形态选择一个有利阈值。
但重复设计也限制统计解释:15,000 次不是 15,000 个独立观测背景,五个振幅与十个形态复用了 300 个背景;其中约五分之四来自模型训练折。每格 Wilson 区间描述该格抽样率的不确定性,不能把所有格子合起来当作独立的大样本总体置信度。每个 ON 面板还重复同一注入轨迹,而非使频率漂移跨整个 cadence 连续。未来跨条件比较最好按背景进行配对或聚类重采样。
主要结果与注意力诊断
下表摘自附录 A 表 2;目标行是 recall,干扰行是 FPR,分母均为该格的 300 次注入。
| 注入形态 | 振幅 0.5 | 振幅 4.0 | 直接支持的结论 |
|---|---|---|---|
| D1-1,大漂移目标直线 | 0.410(0.356–0.466) | 0.020(0.009–0.043) | 此注入协议下变亮反而少被检出 |
| D1-2,二次曲线目标 | 0.533(0.477–0.589) | 0.017(0.007–0.038) | 非单调现象不是一个形态独有 |
| D1-3,S 形目标 | 0.570(0.513–0.625) | 0.900(0.861–0.929) | 并非所有形态都随亮度恶化 |
| D1-4,脉冲目标 | 0.017(0.007–0.038) | 0.010(0.003–0.029) | 接近干净背景误报水平 |
| D1-5,弥散状目标 | 0.017(0.007–0.038) | 0.010(0.003–0.029) | 增加能量仍未带来明显恢复 |
| D2-5,高漂移干扰 | 0.627(0.571–0.679) | 0.020(0.009–0.043) | 模型在某个振幅区间会大量接纳此干扰 |
括号为 95% Wilson 区间。作为另一个对照,熟悉的窄线 needle 在每档 100 个样本上,recall 也从振幅 0.5 的 0.590 降到 4.0 的 0.090。因此不能简单说“只有陌生形态会漏检”。不过,作者对十种形态与训练分布之间的远近排序是事前猜测,并未实际量化训练集形态覆盖;图中的 “unseen morphologies” 不能被照字面扩写成已经严格证明所有目标形态训练时从未出现。
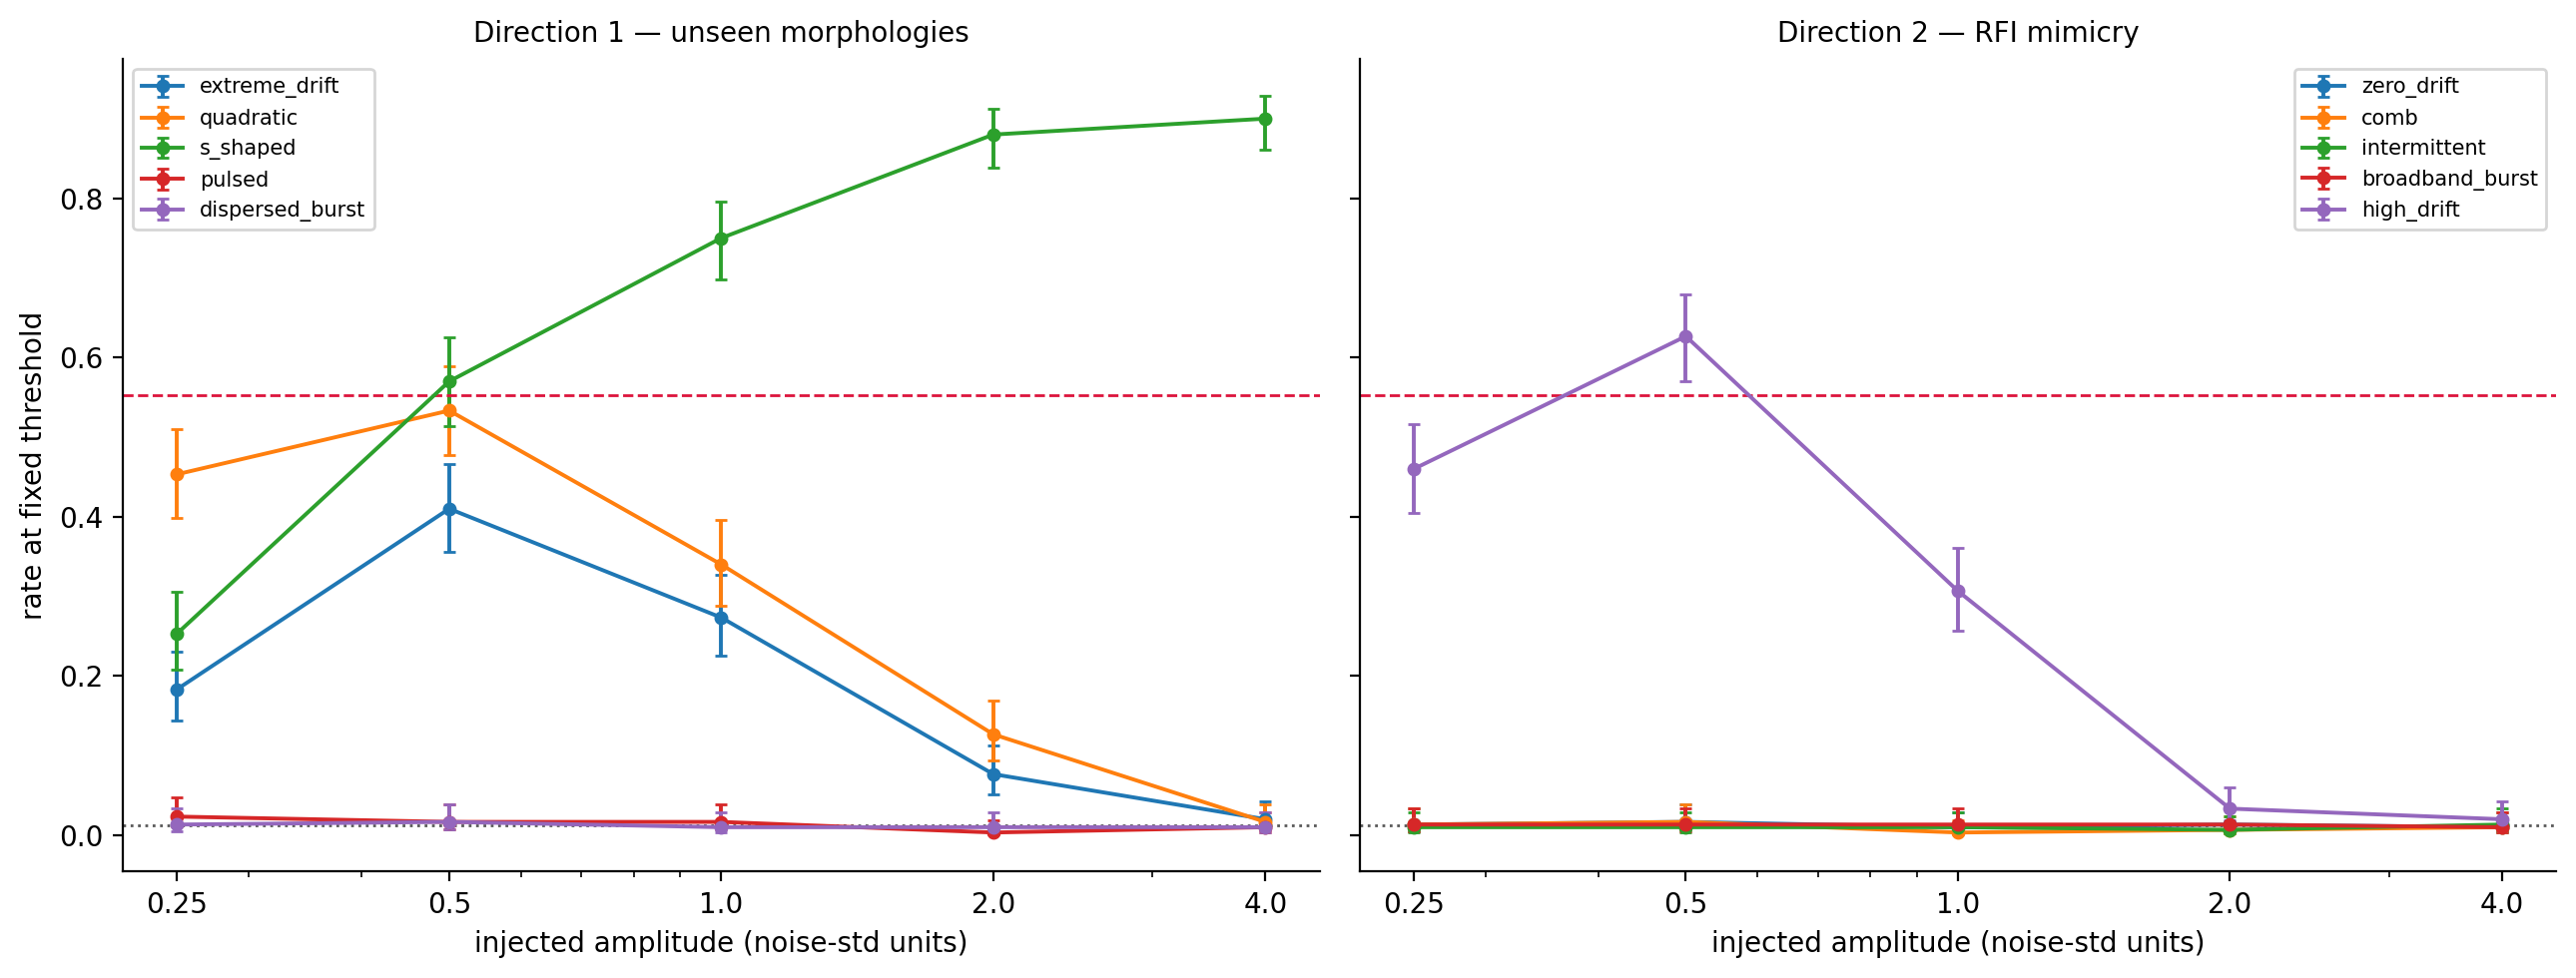
D2-5 的峰值 0.627 与 baseline recall 0.5525 数值接近。作者报告未考虑振幅选择时的检验
Grad-CAM 分析采用六组、每组 12 个对象,总共 72 个;四组按高分检出或低分漏检选择,两组固定种子随机抽取。作者使用中间层
对脉冲组,沿真实注入轨迹相对其他轨迹的响应比为 2.81,超过预先规定的 1.3;大漂移漏检组的该检验为 1.06、
后处理为什么失败:误报下降不等于科学收益
第 3.6 节的后处理先对每个频率通道沿时间、再对三块 ON 或 OFF 求平均;两者相减,经九通道平滑后取最大值
这个量想利用目标仅在 ON 的差别,但先沿时间平均会把漂移线的能量分散到经过的各频率通道。对频率高斯宽度
因此“只在 ON”是可用信息,并不意味着这种具体汇总量保留了足够证据。它没有先沿漂移轨迹对齐或积分。
第 4.4 节中,D2-5 在振幅 0.5 的 FPR 从 0.627 降到 0.007,看似去掉约 99% 的误报。可是全部形态与振幅合计,1,775 个原本检出的目标只留下 25 个,保留率 1.4%;502 个检出的干扰留下 6 个,保留率 1.2%。本文用官方 phase55_veto.csv 的逐格计数重新求和,得到相同总数;这只是结果文件核算,不是重新运行检测模型。
预先规定的通过标准是降低 FPR,且 recall 损失不超过 10 个百分点。后者明显失败。对已标出的候选,
代码、数据与复现条件
截至 2026-10-17(Asia/Singapore),官方仓库可访问,包含真实训练 notebook、实验 notebook、data/injection_manifest.csv、验证预测、逐样本和逐格结果,以及冻结权重文件。核心模型和预处理在 notebooks/detector-v1.ipynb,注入生成器、评分、Grad-CAM 与过滤在 seti-experiments-v1.ipynb,结果核算入口是 scripts/verify_results.py。代码 MIT;README 将 manifest、结果与图片标为 CC BY 4.0。
复现最容易踩的坑有三个。第一,应使用 best_score 权重,不是 best_loss;第二,必须先把 float16 数据转为 float32,再计算统计量,输入配方没有额外归一化;第三,原 manifest 构造曾使用随 Python 进程变化的 hash(),README 明确要求加载保存清单,不能随意重新生成一份却宣称同一实验。Notebook 中读取冻结 manifest 的实现与该说明相符。
原始背景没有在仓库再分发,仍须按 Kaggle 数据规则取得;实验依赖的 Kaggle 路径需要适配。requirements.txt 没有锁定完整 notebook 环境版本,不能保证换一台机器即可逐字节复现。README 声称 T4 上评分约 6.5 分钟,这是作者环境记录,不是本文测速;未核实完整训练成本或不同版本库的数值等价性。
对“这组冻结模型与已保存实验出现所报误检/漏检”,可信度为中等,有代码、结果表和清单支持;对“此训练设计的信息缺失使其无法利用 OFF”,可信度为高,这是可直接检查的输入性质;对“亮度反常由哪种已学习机制造成”,可信度为低,尚缺关键控制。单 seed、单验证折、训练背景重复出现、十种简化合成形态,均限制外推。
审稿人视角:最大问题与研究启发
最大的一个问题
最可能改变对核心亮度结论的理解的是:训练资料与压力测试采用不同的“注入—归一化”顺序,导致信号变亮时同时改变了模型所见的数据生成协议。
第 3.3 节和第 6 节明确说明,竞赛资料是在注入后做样本归一化,本文却把新信号加到已经归一化的背景上,随后不再归一化。于是振幅增大不仅代表源更强,也可能代表信号与背景之间的尺度关系越来越偏离训练分布。作者用数值范围说明振幅 4 没有超过原数据的常见极值,但逐像素范围正常不能排除联合分布或归一化关系改变。
这一问题比单次训练更直接影响“越亮越漏”的解释:多跑几个种子仍可能重复同一个协议混杂。它不会推翻 ON-only 无法读取 OFF 的事实,也不会抹掉结果表中已经存在的非单调曲线;它会决定该曲线应解释为部署中的物理强度失效,还是受控注入过程制造的处理域偏移。
作者已经承认这一点,并提出再归一化是待做实验,现版本并未解决。最小关键验证无需重新训练:固定背景、位置、形态、权重和原判决阈值,为每次注入建立“现协议”与“匹配训练归一化协议”两条路径,比较 score 和 recall 随振幅的曲线,再以背景为单位做配对统计。若无法取得训练阶段精确归一化定义,应先核实该定义,而不是任意除以一个标准差称作等价。若匹配后曲线恢复单调,归一化失配解释得到支持;若仍反常,才有更强理由调查学到的亮度先验或内部响应。
研究启发与可执行验证
可复用的核心思想是:把候选系统拆成“模型保留了哪些证据”和“后处理丢失了多少真目标”两个可测问题。
- 对多历元、背景对照或差分成像任务,先列出标签判定需要哪些观测,再核查这些观测是否真的进入模型。如果物理判别依赖被预处理删掉的部分,单纯换 backbone 不能补回信息。可用保持主输入不变、只改对照输入的成对样本检查这一点。
- 注入应在与训练及部署一致的校准、归一化、重采样阶段进行,并固定噪声与位置,分开比较峰值振幅、总能量、宽度与占空比。真实背景带来观测系统学,但不自动保证合成信号符合真实观测生成过程。
- 对任何 veto 都同时报告“原有真阳性保留率”和“误报压制率”,最好画完整权衡曲线,并加入不经过 CNN 的直接统计基线。路径对齐的 ON/OFF 检查是值得尝试的迁移建议,不是本文已验证有效的改进。
这些建议适用于存在可控注入与观测对照的任务;没有可解释注入器、没有独立背景或原始校准资料时,先做数据审计比扩大模型更有价值。阅读顺序可从第 3.2–3.4 节与附录 A 开始,再看第 3.6、4.4、6 节;Grad-CAM 图应放在定量结果之后读,不以热图替代机制控制。
四、跨论文结论与行动建议
两篇研究都表明,模型学到的可分性与科学问题真正需要的可分性可能不一致。Rubin 的关键是评价对象如何被选中;SETI 的关键是模型可见信息以及合成信号经过怎样的处理。前者主要需要更有代表性的独立标签,后者首先需要匹配的数据处理对照。两者都不能用更大的网络直接解决这些证据问题。
- 优先精读 Rubin:它与测光、形态和多模态目录研究的联系更直接。重点不是挑选 0.97 的配置,而是建立标签来源、亮度支持与目标总体之间的对应关系。最大的标签选择问题会降低直接部署优先级,但不会降低其作为实验设计案例的阅读价值。
- 把 SETI 留作审计方法储备:其冻结模型、配对背景、固定阈值和保留率统计易于迁移。归一化协议混杂应先于新的网络结构实验解决;现成 CSV 可先帮助核对评价流程,不必立刻重新训练。
- 可立即规划的三个小实验:独立真值上的 Base/+Errors 配对评价;在同对象与同预算下的随机划分/空间划分对照;冻结检测器的匹配归一化注入与后处理保留率测试。每项都应事先定义通过标准,避免看完结果才改指标。
- 暂时不能作出的结论:误差特征普遍提升物理分类能力;一个场区的高 F1 代表暗端或拥挤场可用;ON/OFF 简单过滤失败代表观测对照没有价值;某个 baseline 的非单调召回代表所有深度检测器都排斥强信号。
下一步最值得投入的不是并行堆更多方法,而是让最小的新增实验能区分两种竞争解释:究竟是模型真的获得了任务信息,还是评价规则与处理流程给它提供了另一条容易得分的路径。
本报告由 ChatGPT Dots 整理分析,博客作者对分析内容不负责且不代表博客作者本人的想法。