一、本期总体分析
arXiv 论文时间范围:[2026-10-15 05:04:26, 2026-10-16 05:04:26)(Asia/Singapore) 各分类篇数:astro-ph 173;cs.CV 234;cs.LG 486;cs.AI 479;stat.ML 88(含跨类,分类间可能重复) 入选篇数:2
两篇论文都提醒我们:检测器输出更多框、获得更高测试分数,不一定意味着获得更多可靠对象。第一篇把 YOLO 应用于银河系行星状星云搜索,亮点是统一巡天图像处理、对象级划分和大面积部署;它也直接暴露了已知目标测试集与真实天空候选纯度之间的差距。第二篇 WinARDet 针对生成式检测器的重复框循环,用压缩历史保留已检测对象的信息,把更多生成预算用于新对象。
建议先读行星状星云论文,约 30–40 分钟,重点看样本构建、评估口径和真实部署。它适合设计天文目标搜索流程,但不能据其高精确率宣称已得到高纯度新星表。再用约 40–50 分钟阅读 WinARDet 的方法、曝光次数匹配对照及附录评测协议;它更适合作为长序列生成式检测的方法储备,而不是替换任意 YOLO 或 DETR 的通用模块。
两者的证据强项不同:第一篇的天文数据和应用场景具体,但候选确认仍未完成;第二篇对重复生成和有效吞吐给出了较系统的对照,却还没有充分分离“学习压缩表示”与“限制原始历史长度”各自的贡献。
二、入选论文概览
| 阅读优先级 | 英文标题 | 论文类型 | 核心贡献 | 数据或基准 | 代码状态 | 适用研究场景 | 一句话判断 | arXiv |
|---|---|---|---|---|---|---|---|---|
| 1 | Identifying Planetary Nebulae Candidates from IPHAS and VPHAS+ Surveys via YOLO Deep Learning Models | 天文交叉 | HiPS 多巡天处理、按天体划分、面向弥散目标调整检测评价 | IPHAS DR2、VPHAS+ DR4、HASH | 官方处理与训练代码公开;评估依赖仍有缺项 | 窄带图像中的稀有展源候选搜索 | 流程值得精读,测试精确率不代表盲搜纯度 | 2610.19760v1 |
| 2 | WinARDet: Compressed Window Auto-Regression for Long-Horizon Vision-Language Grounding | 纯 CV 检测 | 当前窗口保留精确历史,已完成窗口压缩为记忆 token | DOTA2、SODA-A、RSDense、SKU110K、COCO | 官方核心实现、训练和评估路径均存在;启动路径需整理 | 密集对象的自回归框或多边形生成 | 对重复框有明确收益,不等于普遍提高原始推理速度 | 2610.19419v1 |
三、逐篇深度分析
1. 行星状星云:已知目标检测得很好,盲搜候选仍需要重新验证
基本信息:Titouan Sérandour、Anne-Laure Méalier、Bruno Colicchio、Dominique Daniel、Philippe Gilberton、Philippe Oros、Thomas Boch、Djaffar Ould Abdeslam;arXiv:2610.19760v1;分类 astro-ph.IM、astro-ph.GA。首次提交为 2026-10-14 08:15:26 UTC,尚无后续版本。摘要与版本记录,完整 PDF。PDF 首页注明 2026-06-06 接收、2026-09-29 发表,期刊为 The Astronomical Journal 172, 238,期刊 DOI。官方代码为 CentraleDigitaleLab/AIP-PN-YOLO,论文另提供 Zenodo v1.0.1 存档。
适用研究场景与结论:这是一篇面向真实巡天候选发现的工程与实验研究,不是提出新检测骨干的论文。最值得复用的是天体级数据管理、跨巡天统一裁图,以及对“找到了目标”与“边界画准了”两种任务的区分。它证明了对已知星云图像的有效检出,但没有证明大面积新候选已具有接近 99% 的纯度。
科学任务与数据:用窄带发射特征寻找稀有星云
行星状星云来自低、中质量恒星晚期抛出的气体包层,其电离发射可用于研究恒星质量损失、化学富集和银河系结构。困难不是只有目标很暗:它们的形状差异很大,可能紧致、双极或呈弥散壳层;银河平面恒星拥挤,H II 区、超新星遗迹和仪器伪影又能产生相似外观。检测框只是候选定位,天体性质最终仍需要额外诊断,特别是光谱。
论文第 2 节使用 IPHAS DR2 与 VPHAS+ DR4。前者由 INT 的 Wide Field Camera 获取,后者由 VST 的 OmegaCAM 获取;表 1 列出的观测时期分别是 2003 年 8 月至 2012 年 11 月、2011 年 12 月至 2018 年 8 月。两者覆盖银河平面,VPHAS+ 另扩展至银心凸起区域。IPHAS 约覆盖 1,800 平方度,VPHAS+ 约 2,000 平方度,存在重叠,不能直接相加作为独立面积。论文部署节给出的合并面积约 3,755 平方度。
输入只取共同具备的
原始像元尺度分别为约 0.33 和 0.21 角秒。小图都取
从目录到图像:划分单位比增强次数更重要
第 3.2 节从 HASH 选择银河系 True、Likely、Possible 三类对象,要求主要角直径已给出、小于相应视场,并位于巡天覆盖内。小图样本为 2,596 个独立星云,其中 564 个在 IPHAS 可见、2,103 个在 VPHAS+ 可见;大图为 2,704 个,分巡天计数为 597 与 2,180。两个分巡天计数之和超过独立对象数,是因为相同天体可能同时被两项巡天观测,不是新增对象。
图像通过 HiPS2FITS,以 gnomonic 投影和 WCS 对齐取出。每个目标生成两个随机偏心视场,避免模型把“图像中心”学成目标先验;部分目标允许落在边缘。作者按 HASH 的 idPNMain 划分,而非按 PNG 文件随机拆分,做四折交叉验证,每折训练、验证、测试比例为 60%、15%、25%,并按星云状态分层。这能避免同一天体的不同偏心裁图及跨巡天重复观测直接落入不同集合。
这一措施还不是严格的空间独立验证。论文明确说一幅图可能包含多个邻近星云,公开数据构建代码也提醒图中可能出现当前目标名单之外的星云。因此仍应检查不同集合的实际天空覆盖、所有框对应的天体和相邻裁图是否重叠;目前不能据此断言已经泄漏,也不能把主目标 ID 分组等同于已完成这项审计。
预处理不是直接把物理标定通量输入网络。每个波段、每张裁图独立取 0.5% 与 99.5% 分位点,做线性拉伸、截断,再编码为 8 位 PNG;RGB 的顺序是
作者使用 HiPS 的既有图像产品。VPHAS+ 的背景修正归于外部 Montage 流程;IPHAS 仍可能有拼接和 CCD 伪影。本文未给出自行执行的统一 PSF 匹配、消光修正或逐像素误差传播方案。核验的 image_preprocessing.py 还会把归一化后的 NaN 置零、正负无穷分别置一和零;这属于实现处理,不等于网络显式使用了坏像元掩膜。
模型与损失:适配的是检测目标,不是发明新骨干
数据流是“三波段裁图 → 拉伸与 8 位堆叠 → COCO 预训练 YOLOv12m → 多尺度框与单类置信分数”。模型约 20.2M 参数,依赖既有 YOLOv12 的注意力与特征聚合结构。标签来自 HASH 中心和 MajDiam,以中心为框中心、角直径为正方形边长。它不是人工沿星云轮廓标出的精确边界,尤其容易受非圆形外观、不同波段灵敏度和弥散晕影响。
作者因此降低几何相关损失的相对权重,把 box、class、DFL 的系数设为 1、8.25、0.25。单类分类损失主要帮助判断目标是否存在,而不负责区分多种天体类别。训练使用 AdamW,200 个 epoch,40 GB A100;小、大图 batch 分别为 20、3,报告耗时约 3.5 与 24 小时。超参数先在小图上搜索,再用于大图,以节省计算。
增强包括水平、垂直翻转、平移、缩放、饱和度与亮度变化,并将旋转限定为 90° 的整数倍。正文没有完整给出学习率及其调度,不能用框架默认值补成论文配方。当前 训练脚本 使用 batch=0.80 自动显存比例,AdamW 参数行处于注释状态,并设置 amp=False;故当前仓库示例不能逐项替代论文中的历史运行记录。
评价与结果:AP01、AP50 和实际候选纯度是三回事
作者把匹配和后处理 NMS 的 IoU 阈值都设为 0.01,并说明在真值匹配后进行 NMS,同一真值的多个 TP 不重复计数。此口径优先判断粗略位置上是否找到星云,不应与 COCO 风格的严格定位指标直接横比。低阈值本身不是错误,但它使结果适用范围非常明确:候选检出,不是形态或直径测量。
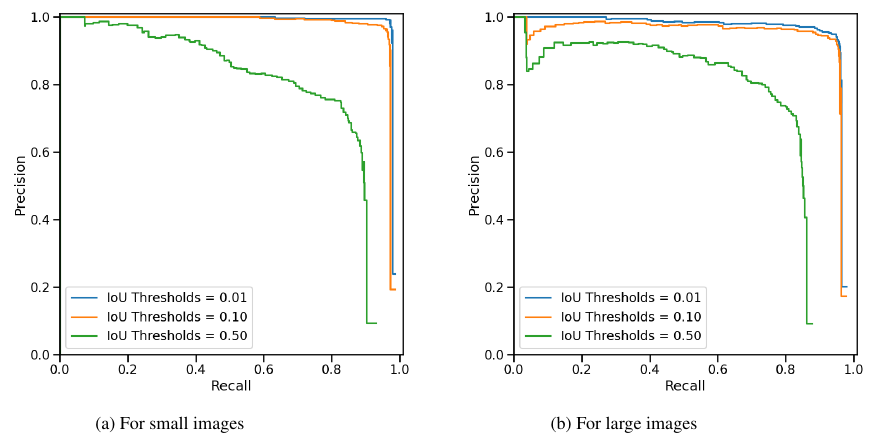
主要定量证据如下,训练可使用三种状态,测试则只评价 True 星云:
| 结果位置与设置 | 可核查结果 | 解释 |
|---|---|---|
| 表 3,小图四折,置信阈值 0.15 | AP01 均值 0.985;精确率 98.7%;召回率 97.4%;F1 98.0% | 含已知星云的裁图测试,不是随机天空测试 |
| 图 4,小图第一折 | AP01 0.979、AP10 0.970、AP50 0.792 | 宽松匹配下高分,严格定位分数明显较低 |
| 图 4,大图第一折 | AP01 0.950、AP10 0.934、AP50 0.745 | 与小图的差别混合了分辨率、视场与目标群体变化 |
| 第 4.2 节,大图第一折 | 精确率和召回率均为 94.8% | 不是大图四折均值 |
| 第 4.3 节,小图第一折的小目标 | 框对角线小于 30 像素的 70 个对象检出 64 个,召回约 91.4%;较大对象约 98.2% | 紧致源仍更困难 |
| 表 5,YOLOv11m 四折 | AP01 0.985;精确率 98.9%;召回率 97.1%;F1 97.9% | v12 相对 v11 没有清楚的实质增益 |
表 3 还给出 AP01 的折间标准差 0.010,但四折间的波动不是对未来天空候选纯度的置信区间。表 4 中 IPHAS 与 VPHAS+ 的平均 F1 分别为 96.8% 与 98.3%;这是联合训练后的分巡天评价,不是“只在一项巡天训练、迁移到另一项”的域外测试。表 6 的 n/s/m/l 规模比较中 F1 都接近,不能用其支持“扩大模型容量是主要收益来源”。
作者与此前 Swin Transformer 工作比较时,训练样本、波段组合、视场及评价阈值不同。对方报告 AP50=0.944,本篇小图第一折 AP50=0.792;这不允许直接宣布本篇架构更优,也不允许反过来宣布 Swin 必然更优。公平比较需要相同图像、对象划分、标签和阈值。
这里还存在必须保留的原文冲突。摘要强调 AP=0.979,但表 3 的四折均值是 0.985,0.979 对应第一折。第 5 节结论又把精确率、召回率写为 97.4% 与 98.0%,与表 3 的 98.7%、97.4% 不一致。本文按表格标明数值对应位置,不把这些表述混成一个“最佳结果”。
大面积应用与复现条件
第 4.4 节称处理了 164,858 张大图,视场四向至少重叠 10%;置信阈值 0.15 时得到 49,648 个框,去重并排除与 HASH 匹配的 3,084 个对象后留下 35,665 个预测。匹配条件为赤经和赤纬方向的差异分别小于 20 角秒,不能改写成已经使用严格球面角距离匹配。第 5 节却仍称只分析 IPHAS 约 34%、VPHAS+ 约 60%,得到 21,244 个预测。两个部署口径未在文中解释清楚,因此不能把任何一组当作已统一核实的最终星表规模,更不能把这些预测数当作新增星云数。
原文图 13(PDF 第 14 页)展示亮星鬼像与 H II 区引起的误检,说明高分候选仍需甄别。
2026-10-16 核验的官方仓库确实包括裁图、预处理、标签和数据集构建实现,以及训练、验证和 PR 曲线脚本。官方性由论文第 2 页脚注 6 与仓库引用期刊论文相互确认。可优先阅读 src/dataset、src/model/yolo 和 src/evaluation。
不过,公开目录只提供 HASH 示例及少量图像,不是论文完整训练集和模型产物。HASH 本身需要注册;数据查询时间、正式划分清单和历史运行设置仍应固定。PR_curve_AP_computation.py 导入 confusion_matrix 中的 make_confusion_matrix,但本次核验的仓库树中没有对应模块文件。patch.py 还会原位修改已安装的 Ultralytics 源文件。因而应在隔离环境逐项补齐依赖和路径,不宜直接在已有训练环境执行。这里完成的是代码静态核验,并未复现实验。
证据评价:对“已知星云裁图中可以有效检出”的可信度为中高,依据是对象级划分、四折结果、具体失败样例和版本对照;对“新候选的高纯度”只能给低可信度,因为缺少盲搜背景样本上的统计确认。方法的价值不依赖把后一项说成已经成立。
审稿人视角:最大问题与研究启发
最大的一个问题
最重要的限制是测试集的目标富集方式不能估计真实天空盲搜的候选纯度。第 3.2.4 节由已知星云选取裁图,第 4.3 节直接说明每张测试图至少有一个星云,图 5 的 TN 为零;第 4.4 节和图 13 则出现大量待确认预测及典型污染源。这不是证明网络没有学到星云特征,而是说明“已知目标附近表现好”与“每平方度产生多少可靠新对象”没有建立定量联系。
它比宽松 IoU 更重要:即使位置匹配完全合理,正例比例和背景结构变化仍会改变候选精确率、人工筛选工作量和光谱跟进效率。作者在第 5 节承认稀有性导致精确率下降,也承认单纯提高阈值会损失召回;人工检查是缓解方式,但论文尚未给出足够的随机抽样确认统计。
最小关键补充是冻结模型与阈值,在独立天空块上进行不依赖 HASH 正例的盲搜,对预测按分数、大小和背景分层抽样人工核验,再对代表性子样本做光谱确认,报告面积归一化误报率及候选纯度区间。不能只跟进最漂亮的少量候选,再用其成功率代表全部候选。这个缺口不推翻已知星云检出的结果,却限制了“发现能力”的外推。
研究启发与可执行验证
稀有天体搜索首先要验证选择函数与跟进成本,而不是继续比较接近饱和的裁图 F1。可先固定已有检测器,在空间独立、含真实空背景的评估集上统计每平方度误报数、各角尺寸及表面亮度范围的召回;再在同一批图像上比较原始置信分数与加入 H II 区、亮星鬼像等困难负例后的排序。目标是在相同人工复核预算下提高有效候选比例,而不是保证所有指标同步上升。
这是迁移建议,前提是有可靠的背景和污染源标注;困难负例挖掘也可能误伤罕见真目标。另一个小成本验证是比较 8 位拉伸与保留浮点通量的输入,同时固定划分与模型,用来区分预处理收益和网络收益。阅读顺序建议为第 3.2、3.3、4.3、4.4 节,再回看表 3–6 和图 4、13;无需先逐条追溯 YOLO 的所有发展版本。
2. WinARDet:压缩已生成的历史,而不是让重复框占满上下文
基本信息:Chenxu Wang、Hangyi Kuang、Bo-Wen Yin、Yuxuan Li、Quan-Sheng Zeng、Yang Zhang、Xu Guo、Xiang Li、Qibin Hou;arXiv:2610.19419v1;分类 cs.CV;首次提交 2026-10-14 02:09:36 UTC,无后续版本。摘要,HTML 正文及附录,PDF,官方代码与项目说明。当前分析针对预印本,不将其当作已经同行评审通过。
适用研究场景与结论:本篇适合使用多模态语言模型、按序生成大量对象坐标的检测研究。它的贡献不在视觉 backbone,而在生成过程如何保存历史。最明确的结论是,在作者的密集场景设置中,减少历史坐标的直接暴露可以降低重复输出,提升有效对象生成;不能泛化为所有检测器都会更快、更准。
问题定位:一张图几百个对象时,答案本身会成为负担
RexOmni 与 LocateAnything 将图像和语言指令转换成视觉与文本 token,再生成类别、框坐标或其他几何结构。完整历史自回归 FHAR 保留全部已生成答案。对于数百甚至上千个对象,每多生成一个重复框,都消耗解码时间、挤占后续对象的生成预算。
作者在图 2 观察到:随着输出延长,坐标 query 分配给历史答案的注意力增加,初始系统 token 的注意力减少;重复框增长,新对象发现率下降。他们据此提出“历史答案注意力占据”的解释。观察与机制解释应分开:图 2 说明二者相关,不能单凭注意力可视化证明唯一因果根源。
这里不存在传统检测 head 的分类分支与框回归分支。视觉编码器产生图像 token,文本和系统指令形成前缀;解码器通过词表概率预测离散类别与坐标。坐标按图像宽高归一化,量化为 1,000 个取值。RexOmni 串行生成四个框坐标及结构 token;LocateAnything 把输出组织成六 token 的原子块,支持框内并行预测。训练主要是答案 token 的交叉熵,而非另加 IoU 回归损失或采用 DETR 式匈牙利匹配。
方法数据流:300 个 token 压成 20 个,但不丢掉全部过去
令图像、系统和提示词构成固定前缀
也就是始终保留原始视觉与指令前缀、过去各窗口的压缩记忆,以及当前窗口尚未压缩的精确答案。过去窗口分别压缩后累积,不是把整段历史反复压成一个固定长度状态。因此总记忆仍随窗口数增长,只是增长斜率更小,不能称为恒定显存或无限上下文。
默认窗口长
压缩器有两条输入路径。一路将中间序列等分为八段,段内平均得到内容相关 query;另一路添加可学习的窗口内位置编码,经投影提供 key/value。六层交叉注意力和前馈残差块更新 query,输出经过归一化与投影,再拼回原始边界 token。它输出的是连续向量,不是重新生成八个文本摘要词。作者认为内容初始化比随机 query 更能保留各局部区间的信息,但正文没有单独给出二者的严格消融,不能把该动机写成已被独立验证的结论。
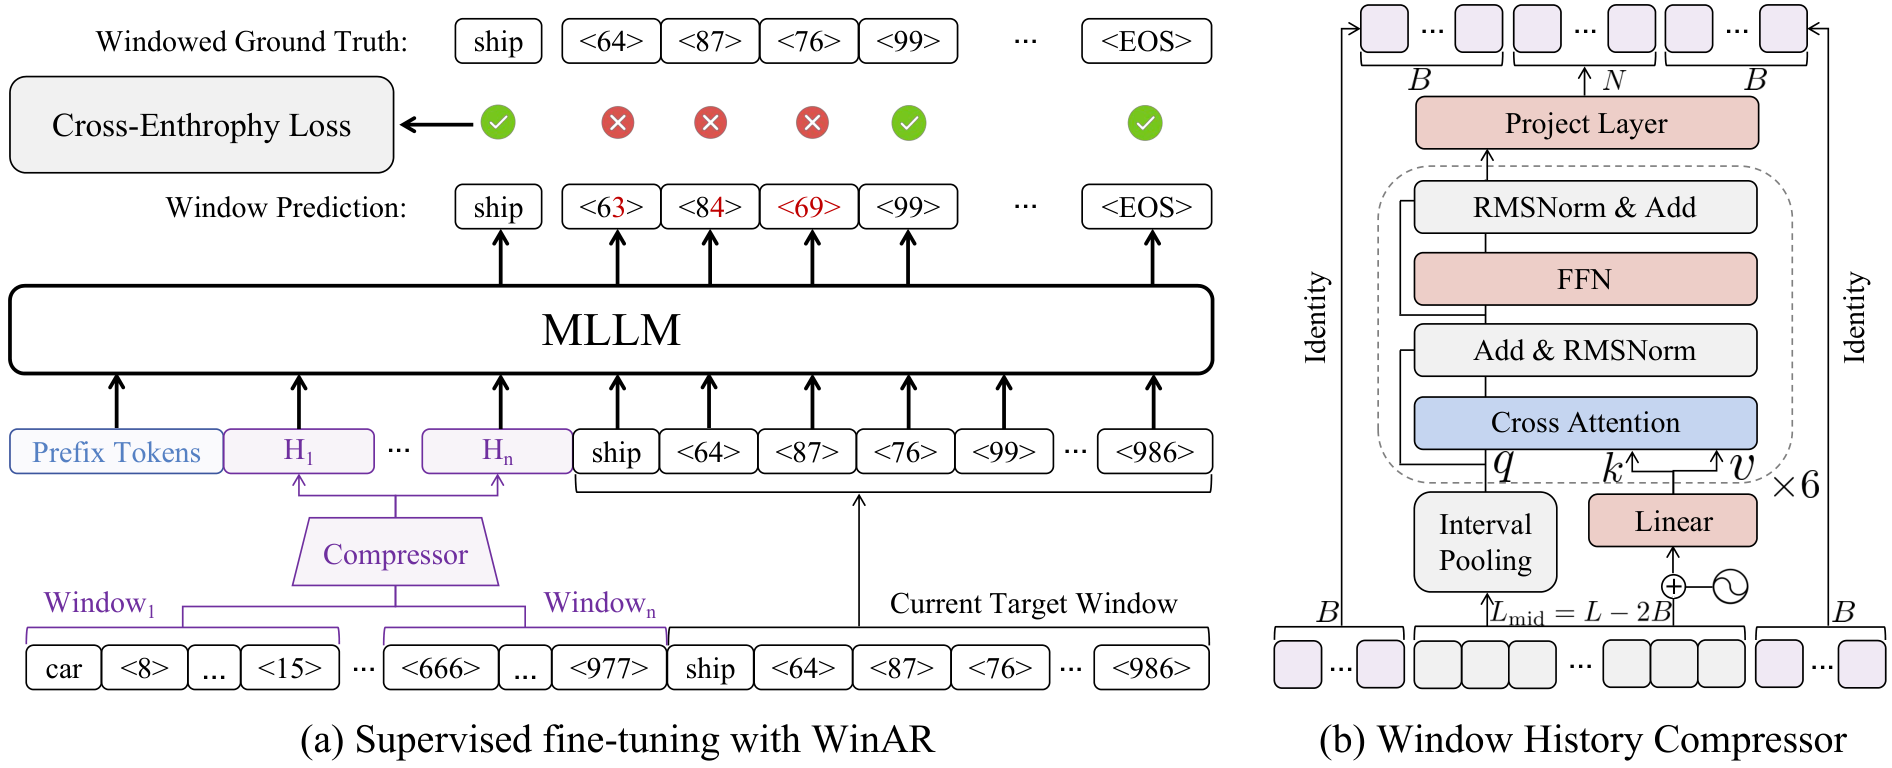
训练时,仅当前窗口接受交叉熵监督,已完成窗口通过压缩表示参与条件化。推理时先生成一个窗口,再压缩并重建后续窗口的条件,直到 EOS 或预算上限。节省的是大量旧答案 token 对应的表示与激活,不是免去视觉编码或语言模型计算。窗口切换时还要做压缩与 KV cache 的重新 prefill,可能抵消部分速度收益。
数据、训练与评测:必须用曝光匹配基线
附录 A.1 给出更具体的数据划分:DOTA-v2.0 裁成
RSDense 不是新采集的独立域,而是联合评估集中对象数超过 200 的 712 张图,平均约 412 个对象。摘要写 200–2,000 个对象,表 7 给出的实际范围是 201–2,305。另用 SKU110K 验证密集商品场景、COCO 验证普通密度场景,多边形实验则输出每对象八个坐标。
窗口训练会将一个长答案拆成多个训练实例,这本身增加长样本曝光和更新次数。作者没有只与普通 FHAR 比,而是增加 FHAR*:按约
表 8 配方为四个 epoch,AdamW,单卡 batch=1,梯度累积 16;语言模型和多模态投影学习率
评测还有两个边界。第一,附录 A.3 明确每张图的提示词只包含该图真值中存在的类别,相当于给出了类别存在信息,不是全类别未知的自然盲检。第二,RSDense 主表按图像平均,并描述为类无关匹配;常规联合集按类别平均、允许每图每类最多 1,000 个预测。附录表 9 又用保留全部预测、按类别汇总的协议。因此不同表的绝对 F1 不能直接连成一条改进曲线。
主要结果与消融:减少重复比“全面领先”更稳健
| 设置 | FHAR* → WinAR | 可支持的结论 |
|---|---|---|
| 表 1,RexOmni,RSDense | F1 32.16 → 39.36;召回 36.82 → 45.23;重复率 35.48% → 13.00% | 高密度长答案中的新增对象发现得到改善 |
| 表 1,RexOmni,联合集 | F1 67.59 → 67.97 | 平均收益小得多,不是普遍大幅增益 |
| 表 1,LocateAnything,NTP,RSDense | F1 54.87 → 54.40;重复率 5.90% → 0.49% | 重复减少并不保证 F1 提高 |
| 表 1,LocateAnything,PBD,RSDense | F1 26.15 → 27.54;重复率 14.89% → 2.13% | 框内并行解码也能使用该机制 |
| 表 3,四边形输出 | DOTA2 F1 47.25 → 48.93;SODA-A 38.64 → 44.00 | 不只适用于四坐标水平框 |
| 表 9,全部预测协议 | COCO F1 +0.56;SKU110K +0.48;RSDense +4.46 | 去掉预测截断后仍有收益,但它不是主表的同一口径 |
表 4 在匹配训练曝光后比较窗口长度。
还要区分表 4 与主表:前者为了窗口长度比较采用额外曝光匹配,默认配置的 F1=44.78,主表是 39.36,不能挑选较高值替代主结果。表 5 的六层压缩器优于四层,八层没有明显进一步收益;未见多随机种子误差条,因此 39.36 与 39.32 这类小差值不足以支持强结论。
表 10 的推理速度统一在八张 H100 上测量。RexOmni 的原始框吞吐从 6.05 到 6.68 框/秒,去除冗余后的有效框吞吐从 3.57 到 5.40;这里“有效”意为不重复,不等于全部是真阳性。LocateAnything PBD 的原始吞吐反而从 29.03 降至 26.15,有效吞吐从 24.63 小幅升到 25.61。训练峰值显存分别从 57.62 降至 42.97 GB、从 67.38 降至 44.43 GB。由此可以支持长序列训练的显存节约,但不能把历史 token 的 15 倍压缩比直接说成 15 倍推理加速。新增参数、完整 FLOPs、单图延迟分布及不同批量下的速度仍未充分报告。
开源代码核验卡
核验日期为 2026-10-16。官方性依据是论文正文直接链接 facias914/WinARDet,仓库 README 又回链论文,并提供模型与数据发布入口。
- 模型实现:满足。核心 object_memory_compressor.py 包含区间平均初始化、位置编码、交叉注意力、RMSNorm、前馈残差与边界直通,不是只调用外部服务的包装。该实现使用两层带 GELU 的输入投影,正文较简略地称其为投影,不应忽略实现细节。
- 训练路径:满足。train_seg.py 构造 Qwen2.5-VL 模型并接入窗口压缩训练器;sft_winar.py 给出 300/6/8 与六层配置;启动脚本 给出 torchrun、优化和显存相关参数。
- 评估路径:满足。RSDense 评估脚本 串联推理、预测格式转换和指标计算;评估说明 解释不同后端及数据协议。
- 配置与文档:满足基本理解与运行准备要求。训练指南 说明底座权重、数据 TSV 及需要调整的路径,README 给出 PyTorch、CUDA 与 FlashAttention 版本和数据入口。
最终判定为满足实质性开源门槛,但不是开箱即用的复现保证。实际代码位于 RexOmni_WinAR 子目录,文档中的部分 cd 命令没有反映这一层;启动脚本引用 configs/compression/sft_winar_dense.py,而本次树中提供的是 configs/sft_winar.py。应显式更正为已存在配置,再替换模型和数据路径,不可直接照抄命令。
另外,评估 README 称匹配保持类别感知,而论文 A.3 将 RSDense 主表描述为类无关匹配。当前核验不能消除这处协议差异,复现实验前需要核对实际后端并重算两种口径。没有运行训练或基准测试,因此不声称仓库可直接重现表中数值。
证据评价:对“在给定底座与数据上降低重复输出”的可信度为中高,曝光匹配基线、不同解码方式、多边形输出和全部预测评价共同支持它。对“该机制在任意密集检测场景都有相同收益”的可信度为中低,原因包括类别提示先验、主要高密度结果来自遥感子集、部分底座的 F1 不增反降,以及评测协议仍有需厘清之处。
审稿人视角:最大问题与研究启发
最大的一个问题
最重要的机制证据缺口是没有充分区分学习式历史压缩的收益与单纯限制原始历史的收益。第 3.2 节一次改变历史长度、表示方式和窗口训练结构;图 2 的注意力变化与重复率相伴发生;表 4、5 主要比较该设计内部的窗口、边界和深度,没有提供等历史预算的滑动窗口、只保留边界或简单池化记忆等直接对照。
这一点比微小的单个分数变化更影响方法取舍:如果便宜的历史截断已能获得主要收益,六层可训练压缩器的必要性就需要重新估计。FHAR* 已经认真控制了曝光和更新次数,不能再把“训练更多”当作作者没有处理的问题;缺少的是历史表示方式的独立控制。该限制不否定 WinAR 的实测收益,也不证明注意力解释错误,只意味着“学习压缩是关键原因”仍未被充分隔离。
最小验证是在同样底座、训练曝光、当前窗口长度和历史预算下,增加一个保留边界的简单池化或滑动历史对照,联合报告新对象发现率、重复率、召回及实际延迟。如果学习压缩仍稳定胜出,再把增益归因于其记忆表示更有说服力。正文与附录没有把这项缺失作为已解决的控制实验。
研究启发与可执行验证
对长序列检测,应该把“识别能力不足”和“生成预算被重复答案浪费”分开诊断。先画随解码位置变化的新对象发现率与重复率,再决定是否需要历史压缩。迁移到天文密集场时,需要建立对象顺序、坐标量化和类别提示规则,并保留真实空背景;不能仅因为星场密集,就假定自然图像多模态底座能识别恒星或弥散星系。
一个可执行的迁移验证是固定视觉编码器与训练数据,比较完整历史、简单有限历史、学习压缩三种生成方式,在相同 token 预算下评价独立天区中的目标召回与重复率。这只是研究建议,尚无本文天文实验证据;额外代价包括序列标签构建、压缩器训练和窗口切换时的重算。
可复用模块或设计思想
最有价值的是“精确边界直通+内部内容压缩”的历史接口。输入为
最小移植实验可只在一个已有生成式检测底座上做 300/6/8 配置,对比同预算简单池化。需要保证压缩输出维度与底座嵌入一致、完成窗口长度合法,并实现训练与推理一致的上下文构造。增加的参数与 FLOPs 不应从名称猜测,应按具体底座维度计算;本文没有给出可通用于其他模型的成本数值。
第二个可复用思想是按答案长度匹配样本曝光。它没有新的神经模块,却直接决定方法比较是否有效。使用窗口训练时记录每个原始样本贡献的窗口数、优化步数与 token 数,再给基线匹配相应预算。本文 FHAR* 控制了曝光和更新次数,是可以直接借鉴的实验设计;若还要比较训练经济性,则应进一步在同硬件上统计总训练时长,不能只比较 epoch 数。
阅读顺序为图 2、图 4、第 3.2 节、表 1 和表 4,再读附录 A.1–A.3。希望复现时应把训练脚本、配置文件与评估后端放在一起核对;只读摘要会遗漏曝光匹配、真值类别提示及吞吐下降的情形。
四、跨论文结论与行动建议
最优先精读星云论文,因为它把天文对象选择、图像处理、标签近似和大面积部署的现实问题放在同一条流程中。WinARDet 作为方法储备更合适,尤其适用于已有自回归检测基线、且确认存在长答案重复问题的场景。
两篇最重要的限制都影响下一步,但性质不同。星云论文缺的是目标富集测试与真实天空纯度之间的验证,优先补空间独立盲搜评估,比再换一个 backbone 更有意义。WinARDet 缺的是简单历史控制与学习压缩之间的关键机制对照,优先验证压缩器是否必要,而不是立即扩展更多层。
可立即设计、但不应当作已有结果的三个实验是:
- 固定天文检测模型,在独立天空块上按每平方度误报数和固定复核预算下的候选纯度评价,并分层报告目标角尺寸与背景条件。
- 对生成式检测器匹配曝光、更新与输出预算,比较完整历史、简单有限历史和学习压缩,同时统计新对象率、重复率与真实耗时。
- 对近饱和的裁图指标增加严格定位口径和盲搜口径,区分“目标存在被识别”“几何位置准确”“候选科学性质得到确认”。
暂时不应据此宣称:YOLOv12 显著优于 v11、几万预测等于几万新星云、AP01 可与 AP50 直接比较,或压缩历史必然提升所有底座的 F1 与原始吞吐。两篇真正可带走的价值,是把检测评估放回它要支持的发现流程和计算预算中。
本报告由 ChatGPT Dots 整理分析,博客作者对分析内容不负责且不代表博客作者本人的想法。