一、本期总体分析
arXiv 论文时间范围:[2026-10-06 04:58:00, 2026-10-07 04:58:00)(Asia/Singapore) 各分类篇数:astro-ph 195;cs.CV 451;cs.LG 931;cs.AI 857;stat.ML 168(含跨类,分类间可能重复) 入选篇数:2
本期两篇论文分别检验了天文机器学习中容易被默认接受的两个步骤:光谱进入模型前是否应当去掉连续谱,以及不同巡天的表示看起来相似时,物理量预测器是否能够直接迁移。
DESI 恒星光谱论文保留整体谱能量分布,并把消光与恒星标签一起拟合。它提供了真实巡天交叉样本上的结果,温度与表面重力相对参考星表的偏差有所减小;但原始金属丰度仍需经验校准,误差条也不能直接理解成已经验证的贝叶斯后验。另一篇论文冻结大量预训练模型,把几何相似度、层选择和物理量迁移分开检验。其主要价值是实验设计:邻域相似、配对检索准确和同一回归器跨巡天有效,是三个不同的问题。
建议先读光谱论文,再读表示迁移论文。 前者适合思考数据预处理与物理前向模型如何配合,预计精读 35–50 分钟;后者适合设计多模态与跨巡天验证,预计精读 30–45 分钟。两者都值得读,但目前都不宜被当成拿来即可完成端到端复现的成熟方案:第一篇链接的公开代码仍是前代归一化版本,第二篇的匿名复现入口本次未能访问。
二、入选论文概览
| 优先级 | 英文标题 | 论文类型 | 核心贡献 | 数据或基准 | 代码状态 | 适用研究场景 | 一句话判断 | arXiv |
|---|---|---|---|---|---|---|---|---|
| 1 | Stellar parameters and abundances for 3.2 million DESI DR1 spectra using machine learning | 天文交叉 | 用合成光谱训练前向网络,联合拟合未归一化 SED、恒星标签与消光 | DESI DR1;APOGEE DR17、GALAH DR3 交叉样本 | 前代 LRPayne 实现可读;本篇完整 DESI 版本未核实 | 低分辨率光谱参数、丰度估计与星表质量控制 | 保留连续谱有价值,但需把校准收益和统计不确定性分开验证 | 2610.04294v1 |
| 2 | Shared Geometry Is Not Shared Physics: A Layerwise Test of the Platonic Representation Hypothesis in Astronomy | 天文交叉 | 逐层对齐检验与独立的物理量迁移实验,展示几何相似度的局限 | HSC 与 DESI、Legacy Survey、JWST、COSMOS-Web 配对产品 | 正文链接匿名仓库;本次访问未成功 | 基础模型选层、图像—光谱对齐、跨巡天迁移 | 几何一致性不能替代目标任务验证;结论限定于不适配的线性迁移 | 2610.04130v1 |
三、逐篇深度分析
1. 保留光谱整体形状,是否能改善恒星参数推断
基本信息与研究问题
英文标题:Stellar parameters and abundances for 3.2 million DESI DR1 spectra using machine learning。作者:Nagaraj Vernekar、Michael Hayden、Sara Lucatello。版本:arXiv:2610.04294v1,首次提交于 2026-10-03 05:00:00 UTC;本次没有后续修订。分类为 astro-ph.SR、astro-ph.GA、astro-ph.IM。摘要页标注“Submitted to ApJS”,不能当作已接收证据。摘要页、HTML 正文、PDF、作者链接的 LRPayne 仓库、部分星表。
这项工作服务于银河考古:从大量恒星光谱恢复温度、表面重力、金属丰度和元素丰度,进而研究恒星族群及银河系化学演化。它并不预测恒星质量或年龄,也不是将观测光谱输入网络后直接输出标签的监督回归。
一句话结论:值得精读的部分是“神经网络作为物理前向模型的快速插值器,保留 SED 后再优化恒星标签”;星表的误差条和未公开部分需要更谨慎地使用。
常见连续谱归一化会压低通量标定、距离尺度等因素的影响,突出谱线,但同时移除温度和消光在整体谱形上的信息。低分辨率下大量谱线混合,去掉连续谱后可用信息进一步减少。作者因此改拟合经过通量标定但未做连续谱归一化的 DESI 光谱,把红化也纳入模型。其代价是:温度、消光、光谱标定误差和连续谱修正项会发生耦合。全文的结果应围绕这一取舍理解,而不能概括为“归一化总是有害”。
数据怎样进入前向模型
方法第 II.2–II.4 节描述了两类数据。训练网络的标签来自合成光谱;真实观测用于拟合和外部比较,不作为这套网络的观测监督训练集。
合成库约有 37 万条光谱,使用 MARCS 一维平面平行大气、LTE 假设、Turbospectrum 和 iSpec,并采用 VALD 原子线表。温度范围为 4,000–8,000 K,表面重力为 0–5 dex,金属丰度为 −2.5 至 +1.0 dex。温度和重力组合受 MIST 演化轨迹凸包限制,因而不是在任意二维矩形内独立抽样。各元素的丰度区间不同,表 1 列出了完整范围;微湍流和宏观湍流依据经验关系设定,旋转速度在 2–20 km/s 内抽取。
光谱先在
真实数据来自 DESI DR1 的 Milky Way Survey 增值星表 mwsall-pix-iron.fits。论文描述的三个光谱臂覆盖 B:3,600–5,930 Å、R:5,600–8,000 Å、Z:7,470–9,800 Å,分辨率约从 2,000 变化到 5,500,采样为每像素 0.8 Å。作者使用主观测对应的合并、通量标定光谱;主观测按 R 臂信噪比选择。文中给出的上游合并星表包含 5,930,124 个独立对象,其中 4,378,110 个被分类为恒星。这两个数字不能与后面声称输出的 320 万行混用。
论文没有完整报告最终科学样本的天空覆盖、观测历元划分、逐谱径向速度移位和坏像素/逆方差处理的全部实现细节;不能仅凭采用 DESI 数据就声称这些步骤已经逐项复现。具体处理区域还包括强线屏蔽:Balmer 线、Na D、Ca II H&K 等在一维 LTE 模型中可能存在明显失配,Na D 还可能含星际吸收。作者报告共屏蔽 170 个像素、约 2.5%。另一个用高信噪比太阳谱残差阈值挑选坏像素的方案没有改善结果,最终保留较简单的强线屏蔽。文中未给出本次完整 DESI 掩膜文件、最终有效像素总数及各处理步骤的可运行配置,不宜用前代仓库的掩膜直接替代。
模型、损失和拟合过程
网络是全连接前向模型:输入一组物理与化学标签,输出各波长像素的通量。三个隐藏层各 2,000 个神经元;作者比较过 200、300、500、1,000 和 2,000 的宽度,认为只估计基本恒星参数时 500 已够用,而元素丰度需要更准确地表示细微谱线变化,因此采用更宽网络。隐藏层和输出使用 LeakyReLU。前代 LRPayne 的输出使用 sigmoid,把谱通量限制在归一化范围;本篇拟合未归一化 SED,取消这一输出限制。
合成库按 80%/20% 分为训练与验证。训练损失为平均绝对百分比误差,优化器为 Adam,初始学习率 0.001;验证损失连续 10 个 epoch 未改善时,学习率减半。批大小、最终训练轮数和完整宽度比较的定量表未在本篇正文给出,不能用旧仓库默认值补齐。另有 7,000 条未参与训练的合成验证谱,用于检查插值和整个拟合流程。
观测推断时,网络权重固定,用 scipy.optimize.curve_fit 改变标签,以最小化模型通量和观测通量的差异;低阶多项式吸收残余连续谱失配。其概念数据流是:
候选恒星标签及消光 → 神经光谱插值 → 连续谱修正 → 与有效观测像素比较 → 更新标签。
这与直接预测标签有两个重要区别。首先,标签必须能通过模型解释光谱;其次,推断仍有非线性优化成本和局部极小值风险。网络降低的是生成候选谱的成本,不能因此把每次拟合等同于一次网络前向传播。
正文对维度计数存在需要实现澄清的地方:第 II.2 节先列 30 个物理/化学标签,又说训练不使用宏观湍流,加入消光后却写成 31 个;第 II.3 和 III.4 节则采用 30 维拟合表述。按其列项删去宏观湍流再加入消光,得到 30 维,但这只是对列项的核对,不能替代作者的最终输入数组定义。多项式阶数及与 SED 的完整组合方式也未充分展开。
初值为何如此重要
作者报告,初始温度偏离超过约 300 K,或者初始重力、金属丰度偏离超过约 0.3 dex 时,优化可能落到错误极小值。这不是模型对参数的容许误差,而是初始化敏感性。常规拟合借助 Gaia XP 推断的基本参数作为初值;在 S/N≥20 的 DESI 样本中,约 80% 有这样的初值。第 III.2.1–III.3.5 节的主要比较都基于有 Gaia XP 初值的对象。
缺少初值时,第 III.4 节采用两步策略:先在温度、重力、金属丰度、消光四个变量上搜索
这能缓解温度—消光退化下的坏初值问题,却不构成找到全局最优的数学保证。作者把它称为“global fit”,实际是有限粗网格加局部精修。图 8 中,它在交叉样本上通常接近有初值拟合,但部分参数的散布变大。该实验是在已有初值的样本上人为隐藏初值,尚不能完全代表真实缺少 Gaia XP 的更暗或不同分布对象。
实验支持了哪些改进
真实比较使用 APOGEE DR17 和 GALAH DR3。APOGEE 要求 FE_H_FLAG=0、STARFLAG=0,GALAH 要求 flag_sp=0、flag_fe_h=0,再限制 DESI 的中位 S/N≥20,分别得到 6,719 和 3,455 个匹配对象。论文没有在此给出交叉匹配半径、自行处理及两参考星表间的重叠去重细节,因此不能把两者相加当成已确认的独立验证恒星总数。
图 2 和第 III.2.1 节给出的代表性比较如下。这里列的是正文报告的“参考值减拟合值”偏差中心,不是 MAE,也不是逐星不确定性。图 2 中 GALAH 温度残差标注约 −42.79 K,而正文写 −47 K,存在数值不一致;下表保留正文值,不将两者默认为同一结果。
| 标签 | 本方法相对 APOGEE | 本方法相对 GALAH | 对照与解释 |
|---|---|---|---|
| 有效温度 | −14 K | −47 K | SP 对应为 −154、−193 K;本方法的偏差更接近零 |
| 表面重力 | −0.02 dex | +0.09 dex | SP 对两星表约为 −0.25 dex |
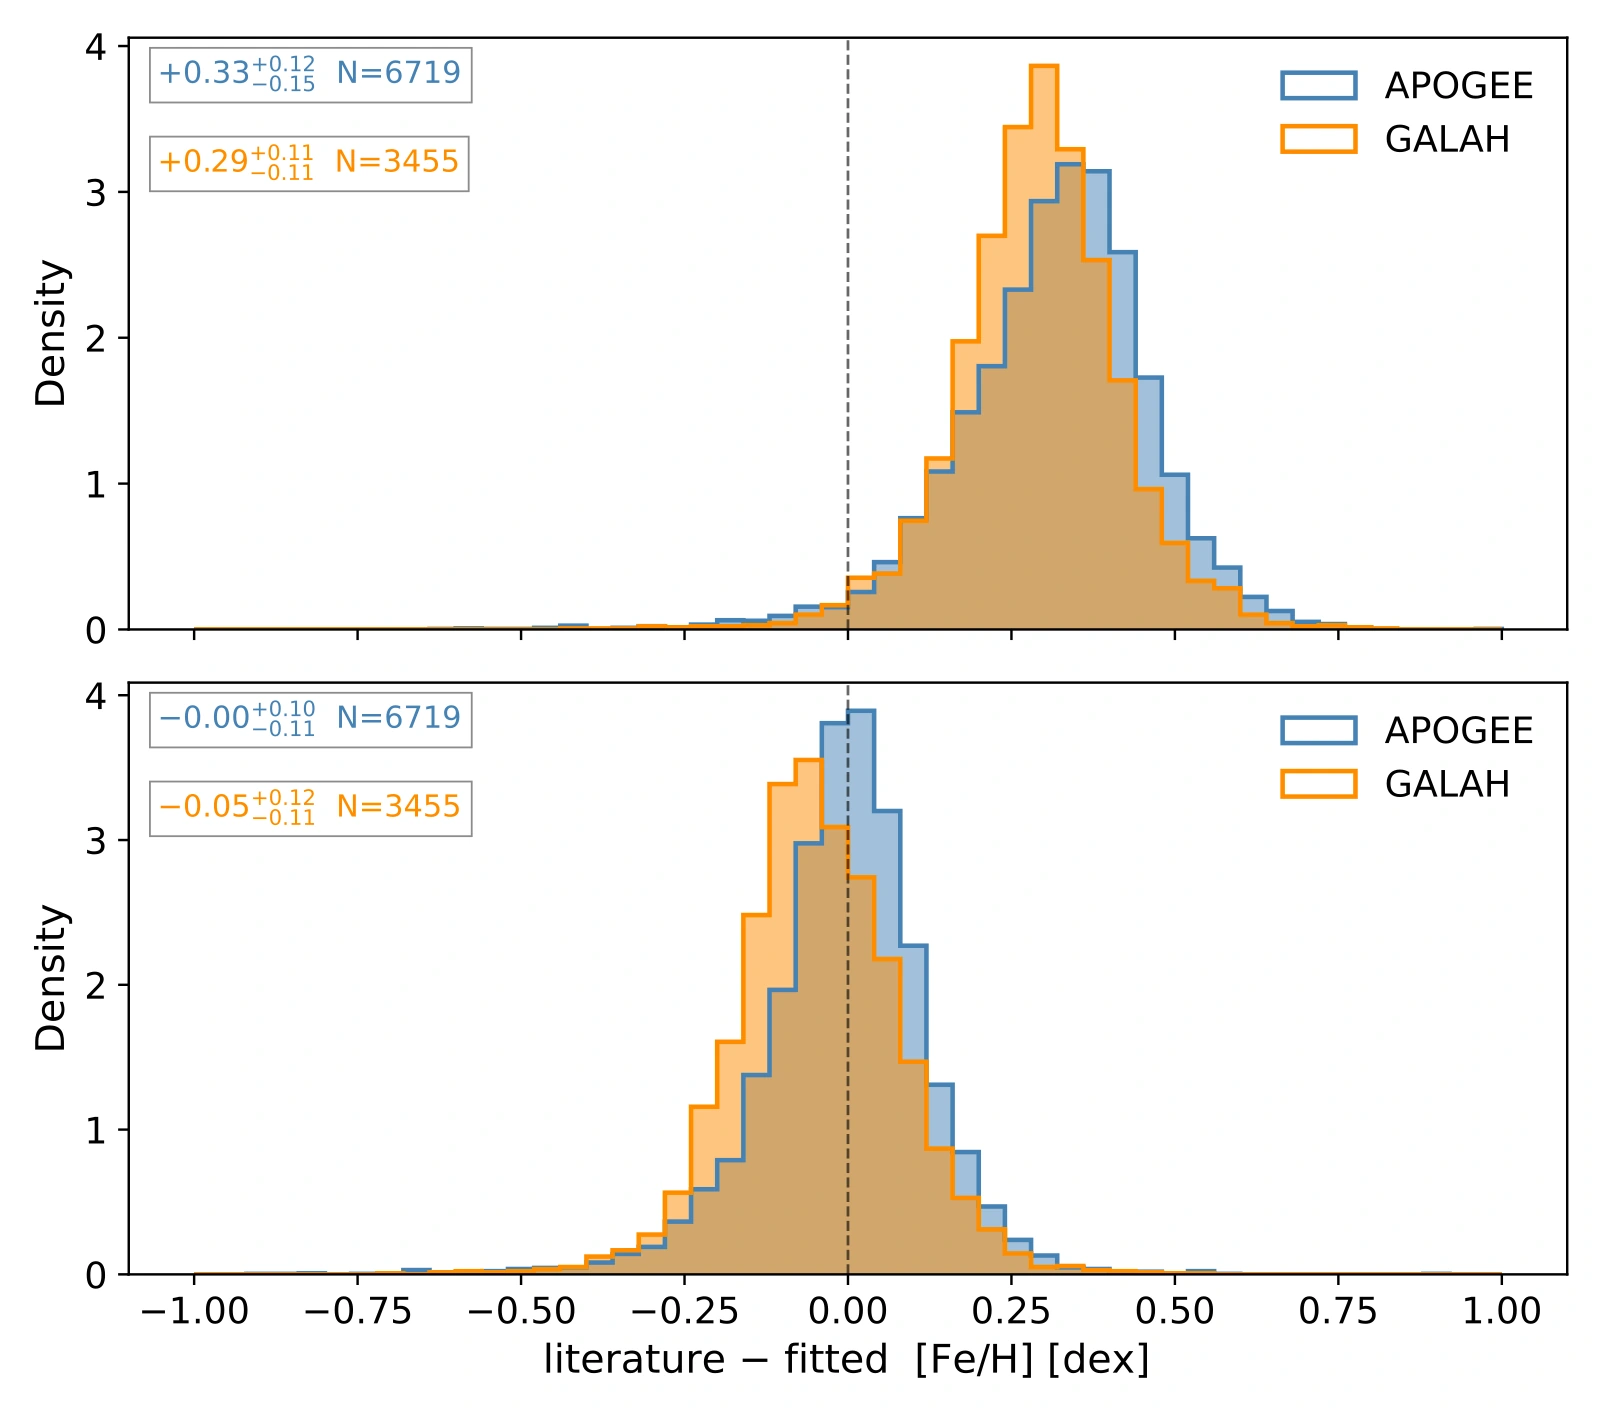
| 原始金属丰度 | +0.33 dex | +0.29 dex | 作者解释为拟合值偏低,提示残余连续谱处理问题 |
| 校准后金属丰度 | 约 0.00 dex | −0.05 dex | 校准系数用 APOGEE 样本拟合,再应用到 GALAH |
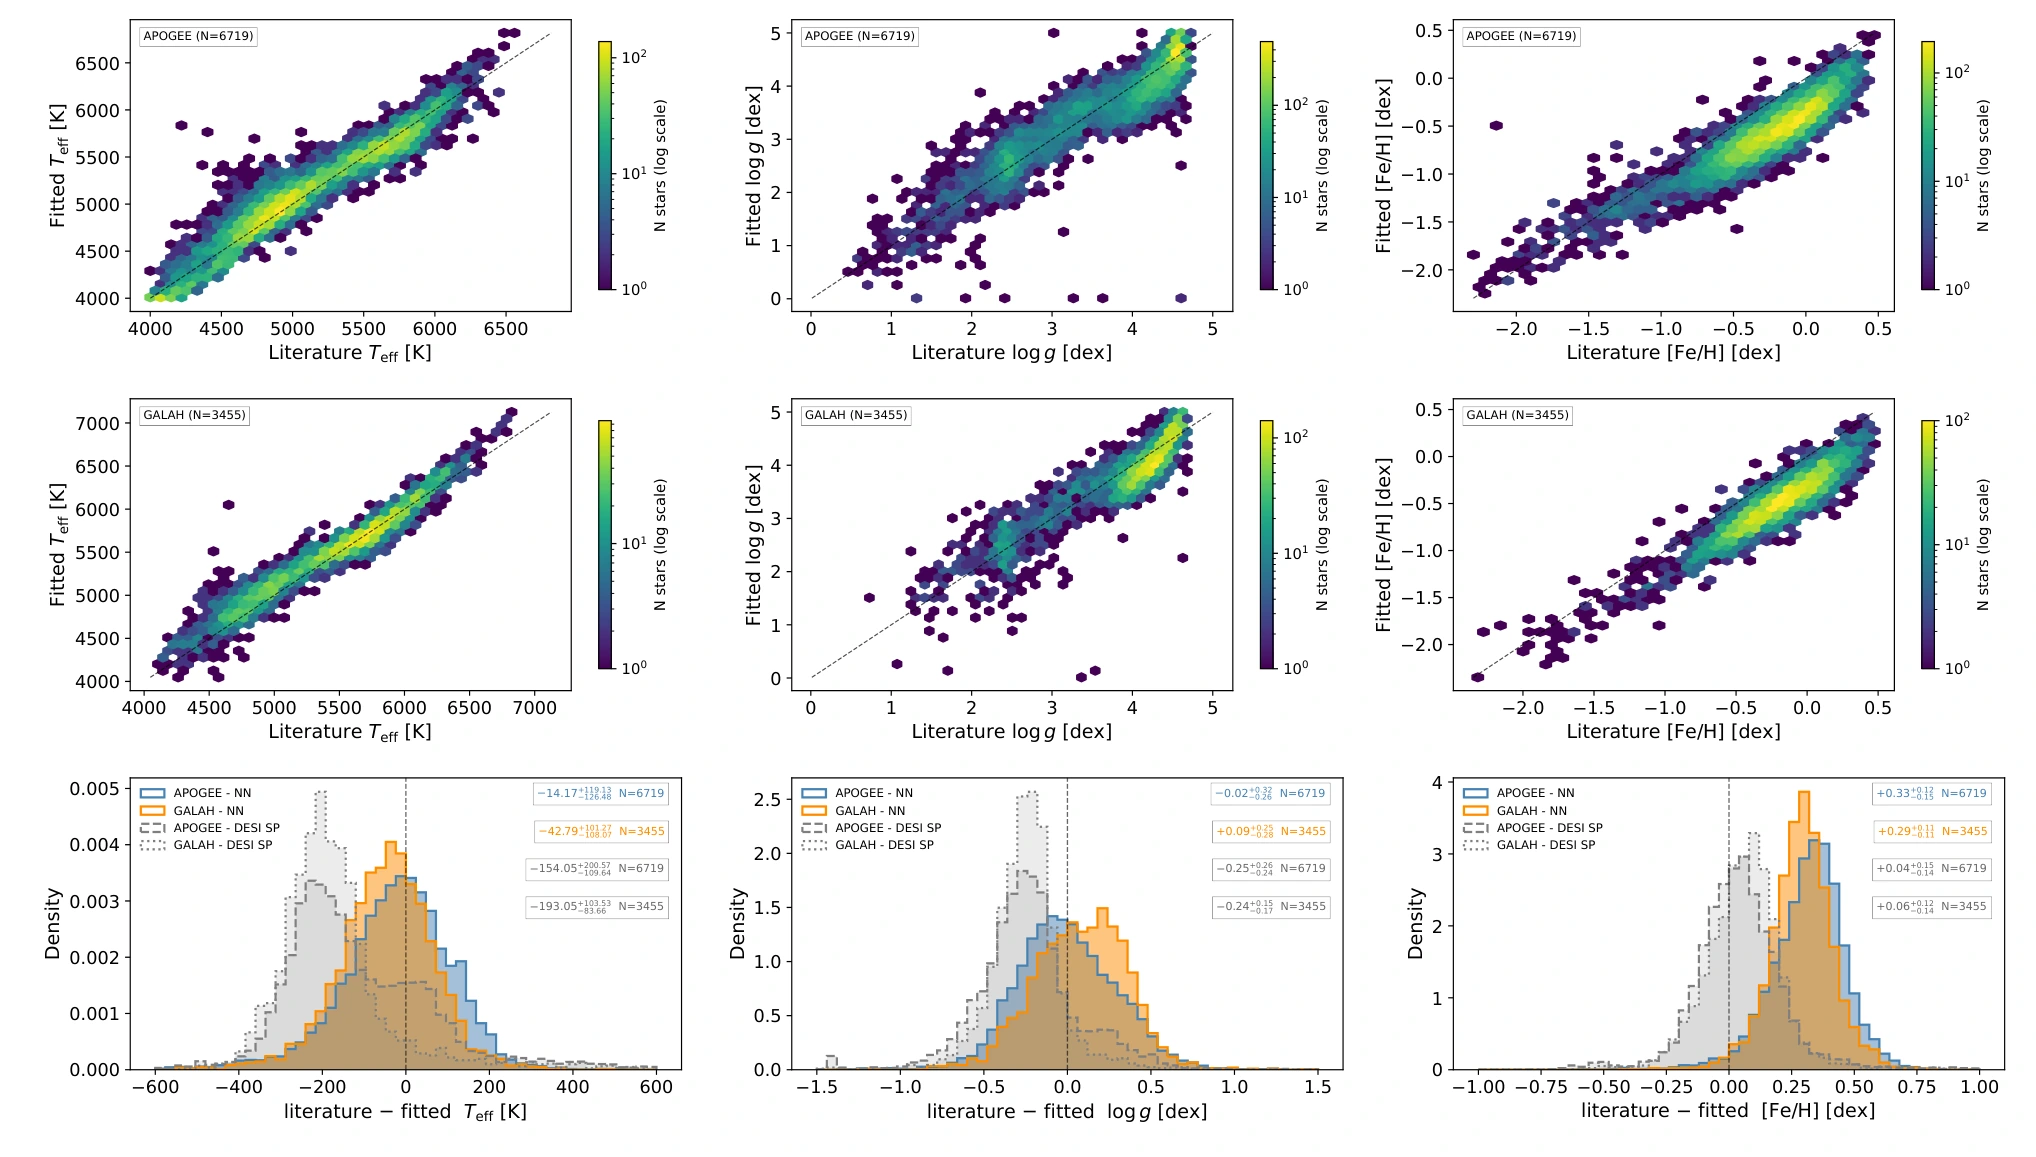
金属丰度的符号尤其容易误读:正文写的是正的残差数值,同时明确解释模型金属丰度偏低,不能把 +0.33 dex 写成模型高估 +0.33 dex。作者把这种偏低归因于低阶多项式对连续谱零点的处理,而不是神经网络插值误差。随后按矮星/巨星分别拟合温度相关二次校准,用的是 APOGEE 交叉样本;表 2 的两组样本量为 4,301 和 2,418。
因此,APOGEE 上校准后接近零是校准内结果,不能再当完全独立的外部验证。GALAH 没有单独重拟合校准系数,是更有意义的跨参考目录检验,但两份匹配样本是否重叠未在本文明确,仍不能据此声称对象完全独立。作者保留原始及校准后金属丰度,方便使用者选择标尺,这一点值得保留。
丰度部分更不能只看“12 种元素”。最终讨论的是 Na、Mg、Al、Si、Ca、Ti、V、Cr、Mn、Ni、Ba、Y;虽然训练库包含 C、N、O 等,它们没有因为进入模型就自动成为可靠星表标签。Mg、Ca 的偏差约为 −0.05 至 −0.07 dex,Mn 约 −0.03 dex、散布约 0.11–0.13 dex;Ba 相对 GALAH 的偏差约 +0.06 dex,但分布较宽,Y 约 −0.19 dex、散布也较宽。V 相对不同参考目录差异明显。正文还提醒 APOGEE 的 Ti、V 本身存在参考值可靠性问题,不能把所有参考丰度等权视为真值。
低信噪比检验有一个关键条件:图 7 的 S/N=10 点来自将原本 S/N≥20 的交叉样本加噪并重新拟合,并非真实 S/N≈10 对象的独立外部比较。Ba 在这一设置下出现约 +0.50 dex 的偏差,明显差于其较高信噪比结果。模拟噪声可以测试噪声敏感性,不能同时验证暗星选择效应、通量标定误差、坏像素分布及真实初值缺失造成的变化。
开源与星表状态应怎样理解
截至 2026-10-07 核验,LRPayne 仓库可访问,有 training.py、fitting.py、environment.yml 和示例输入。但这不是已确认与本篇一致的 DESI 实现:当前 training.py 是三个 200 宽隐藏层和 sigmoid 输出,优化器写为 AdamW;fitting.py 示例波长限制在 4,200–6,900 Å。README 说明示例训练数据只有 500 条,不能用于正式模型训练。这些与本篇 2,000 宽、未归一化 SED、DESI 全波段的描述明显不同。
故可复用的是前向插值加拟合的程序骨架,不能声称本篇训练集、模型和全巡天流程已完整开源。本文没有运行其训练或拟合。
Zenodo 记录本次可通过官方 API 核实:标题与说明明确为 17 万颗恒星的子集,包含一个 57,340,800 字节的 DESI_DR1_catalog.fits,数据许可 CC BY 4.0;本次未下载全文件逐行核验。记录说明中的未来完整规模写为 350 万,而论文写 320 万,二者不一致,应保留区别。论文第 III.6 节也使用“will release”,因此准确的状态是:有公开子集,完整 320 万行产品本次未核实可下载。
星表设计包含 HAS_GAIA_GUESS,区分有外部初值和网格初值两种拟合。作者还在宽度为 5 的 S/N 区间内,以拟合 CHI2_FLAG,建议高可靠性样本排除大于 3 的对象。这个标记识别同等信噪比下的相对异常拟合,不保证留下的每一种元素都达到同样精度;使用者仍需保留初始化来源、参数边界和逐元素质量条件。
证据评价与阅读路线
对“合成谱插值精度高、交叉样本中的温度和重力偏差较小”,可信度为中到高,有合成验证和两个参考目录支撑。对“这些改进主要由保留 SED 引起”,可信度为中:新方法与 SP 不只归一化不同,网络、合成库、优化及样本质量处理也不同;缺少同一流水线仅切换连续谱处理的控制实验。作者还说明没有采用 SP 原论文的 BESTGRID 排除条件,因此这里的 SP 残差不应直接代表其最佳质量子样本表现。
对“全星表每个标签的误差条已经可靠”,目前应给低可信度,原因见下面的专项分析。阅读时建议优先看第 II.2–II.5 节、图 2–3、第 III.4–III.6 节;元素逐项比较可按科学需求选读。不要只读摘要里的 320 万和 0.3%,前者是处理/产品规模,后者是同源合成验证中的通量插值指标。
审稿人视角:最大问题与研究启发
最大的一个问题
最重要的问题是,第 III.5 节用不同初始化反复优化得到的参数分布,并没有被证明是能提供正确覆盖率的统计后验。
该节训练 10 个网络,每个对象在每个网络下改变优化初值拟合 1,000 次,合计 10,000 次,再把参数分布的第 16、84 百分位解释为“1σ”不确定性。这个流程可以揭示初始化与模型训练随机性导致的解分散,却不等于按似然和先验抽样:优化器落入一个极小值的频率取决于初值分布和收敛盆地,并不会自动按该解的后验概率加权。文中称其为“MCMC-like”,但没有给出可保证后验采样的转移核、权重或覆盖率验证。
这比网络宽度是否最优更重要,因为星表误差条会影响异常对象筛选、族群比较和后续加权拟合。大量重复优化也不能自动涵盖原子线表、LTE 假设、消光律和连续谱校准的系统误差。实际不确定性演示只有七颗代表星、三个信噪比;表 3 不是对 320 万对象逐星误差质量的验证。它不会推翻温度、重力的点估计比较,但会限制对丰度精密度及误差条的科学解释。
作者意识到了拟合误差和网络随机性,也展示了参数空间依赖;现有流程仍未回答区间覆盖率是否正确。最小的补充验证是:固定少量覆盖温度、金属丰度和信噪比范围的真标签,多次生成独立噪声观测,每次走完整推断与区间构造,检查名义 68% 区间实际覆盖比例;再与同一前向模型下具有明确似然和先验的采样结果比较。这样能直接检验当前误差条是否只是“优化稳定性范围”。
研究启发与可执行验证
可借鉴的核心是保留有物理意义的低频谱形,同时显式处理其干扰因素,而不是默认将所有连续谱变化都删除。
迁移到其他光谱任务时,优先做两个小规模对照:其一,在相同合成库、网络和样本上比较归一化/未归一化输入,并分别扰动消光及平滑标定误差,判断收益来自真实谱形还是校准捷径;其二,对区间做上述覆盖率实验,而不是仅比较多次运行的标准差。前者需要可信的通量和仪器响应,后者需要重复模拟及少量较慢的参考推断,都有额外计算成本。若标定误差超出可建模范围,保留完整 SED 也可能降低稳健性;这一迁移效果尚待验证。
2. 表示空间看起来相似,为何物理回归仍会失败
基本信息与研究关联
英文标题:Shared Geometry Is Not Shared Physics: A Layerwise Test of the Platonic Representation Hypothesis in Astronomy。作者:Kshitij Duraphe、Aravind Kannappan、Dun Li Chan、Okiki Famutimi、Yaswant Sai Ejjagiri、Michael J. Smith、John F. Wu。版本:arXiv:2610.04130v1,首次提交于 2026-10-02 23:06:36 UTC;本次无修订。分类为 astro-ph.IM、cs.LG。摘要页注明 NeurIPS 2026 Interp4Discovery Workshop 接收,不等于 NeurIPS 主会接收。摘要页、HTML、PDF。
作者在引言脚注链接了匿名复现脚本入口。本次网页访问未成功,直接读取匿名服务也返回 403,故不能确认目录、数据产物及复现命令已经可用。没有依据把这个访问结果解释为空仓库。
一句话结论:这是一篇值得精读的实验诊断论文;它说明不能用跨模态几何相似度代替科学任务评估,但没有证明这些表示缺少可适配、可非线性解码的共同物理信息。
天文跨模态研究中,光学图像、红外图像和光谱来自同一天体,却经过不同波段、PSF、噪声、标定与样本选择。模型可能学会把明亮、红色或外形相近的对象放在附近,但这些空间关系不保证某个坐标方向在两个巡天里都表示同一个物理量。作者把这一点落实为可检验的问题:几何对齐出现在什么深度,哪些块间变化共享几何,以及从一个巡天拟合的线性回归器能否原封不动用于另一个巡天。
样本、模型和标签的对应关系
HSC 是所有配对实验的共同参考。作者使用既有配对产品,确定性地删除缺失或重复标识的行;对于重复标识,不任意保留一条,而是删除全部重复出现。JWST 小样本还重新应用既有图像质量筛选。数据不是一个统一大表,尤其两份 COSMOS-Web 产品不能按行号互连。附录 A.2、表 1给出了这一边界。
| 与 HSC 配对的数据 | 原始产品行数 | 分析行数 | 模型数 | 用途 |
|---|---|---|---|---|
| DESI 光谱 | 20,465 | 20,321 | 36 | 几何对齐、公共空间检索 |
| Legacy Survey 图像 | 101,725 | 101,619 | 36 | 颜色与尺度的逐层迁移 |
| JWST 图像小样本 | 1,496 | 929 | 36 | 星等与尺度的逐层迁移 |
| COSMOS-Web 逐层产品 | 56,322 | 56,322 | 31 | 逐层几何 |
| COSMOS-Web 最终表示产品 | 45,000 | 45,000 | 31 | 五个目标的最终层迁移 |
45,000 行产品的参考标签来自公开的 Ashodkh/cosmosweb-hsc-jwst-high-snr-pil2 目录,按作者指定的发布顺序取前 45,000 行。最终目标包括目录中的光谱红移、恒星质量、sSFR、HSC 的 Confidence_level<0;质量和 sSFR 使用 lp_mass、lp_ssfr。这些是测量或模型推断标签,不是无误差真值。
Legacy Survey 的颜色由正的通量比换算,形状目标使用正的 SHAPE_R 的对数;JWST 使用 mag_auto 和正的 flux_radius 的对数。不同实验的“大小”并非完全相同的仪器无关物理半径,不能直接当成跨巡天一致的固有星系尺度。
36 个模型覆盖 11 个家族,包括 AstroPT、CLIP、ConvNeXt、DINO、DINOv3、I-JEPA、LLaVA、PaliGemma、ViT、ViT-MAE、V-JEPA。作者冻结既有模型,不重新训练基础模型;主要拟合的是线性探针和几何变换。SDSS 没有纳入,因为上游检验认为 DESI 训练的 SpecFormer 在重采样后的 SDSS 光谱上仍处于域外;这项排除说明作者没有把“波长网格相同”视为模态已经兼容。
复现时还需补充上游细节:本篇没有完整重述各巡天发布版本、图像波段组合、裁图尺度、匹配半径、PSF及归一化流程;“HSC 与 JWST 配对”本身不能回答这些问题。本文不自行用巡天常见配置补齐。
从表示提取到科学迁移的完整数据流
每个匹配天体先在两个观测视图中经过冻结编码器,保存各阶段的激活。作者特意区分“保存阶段”与网络层:保存对象可能是块输出、归一化、池化、投影或输出头,不宜简单按层号比较架构。
第一步衡量几何。每一行表示先做归一化,再找余弦最近邻;主指标是
其中
第二步处理逐层搜索的统计问题。如果在几十个阶段中选最高对齐值,再用单层随机基线检验,会低估偶然峰值。作者对每次打乱对象对应关系后的整条曲线同样取最大值,形成“最大值对最大值”的置换检验;9,999 次置换后,对原先评估的 175 条曲线做 Holm 校正,最后报告保留的 139 条。这样没有因为排除了 SDSS 就悄悄缩小多重比较集合。
第三步比较相邻块的变化。在宽度相同、对象顺序一致的相邻块中,定义
第四步才是科学任务。逐层图像迁移采用线性 ridge 回归,拟合源视图标准化参数及回归系数后,原样用于目标视图,不在目标域重新拟合。只允许等宽表示,正则化候选为 0.01、0.1、1、10、100。每折约 60% 对象拟合、10% 选择几何阶段、10% 选择标签阶段、20% 测试,四个角色互不重叠。
几何选层用配对检索,在最优值一个标准误以内选最早阶段;标签选层则用另一个验证子集的物理预测表现。两种选择最终在相同测试对象上比较。它检验的是“无标签几何准则能否替代目标验证”,而不是拿测试集最优层与验证最优层进行不公平对照。附录中的测试曲线最大值仅作描述,不是主结论的选层依据。
最终 COSMOS-Web 实验又换成更严格的空间角色分配:按赤经分成十个连续片区,每折测试两个片区,丢弃邻接片区作为缓冲,远处两个片区选择正则化,其余拟合。五折使每个对象测试一次。它减少相近位置跨集合的直接关联,但仍是同一巡天场中的空间验证,不等于独立外场测试。
主结果及控制实验
最直观的结果是:139 条保留的模型—巡天曲线都在某个阶段存在显著局部几何对齐,但对齐并不随深度稳定增长。最终阶段也经常不是最高对齐阶段。在 JWST 配对中,83% 模型的 MRR 从前四分之一到后四分之一上升,而平均邻域重叠、CKA 和 Procrustes 反而下降。找回同一天体与保留邻居结构确实会给出不同判断。
逐层物理预测的八种目标—方向组合里,几何选层都不如标签选层,家族等权汇总的区间均排除零;正文报告的
最终层的红移结果更鲜明:31 对模型都有显著邻域对齐,同巡天预测平均
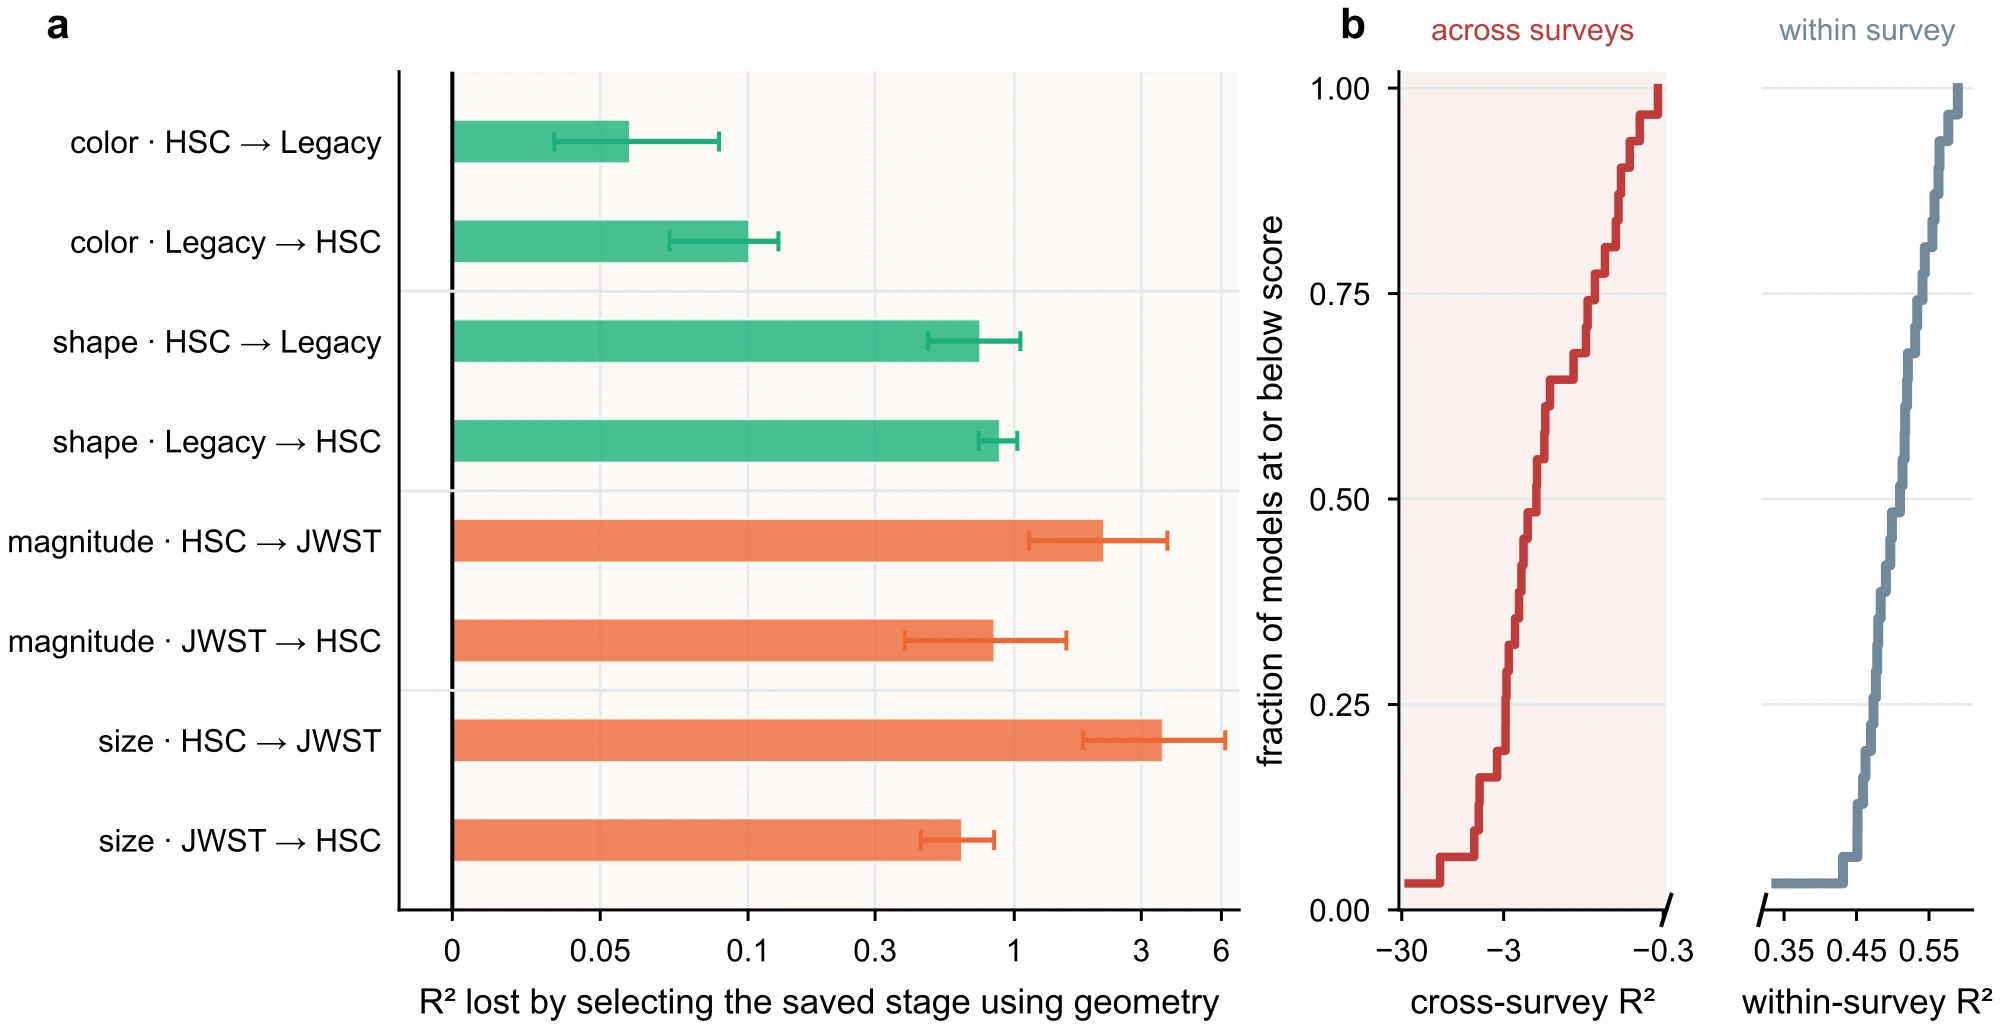
另一个容易误读的数字来自恒星质量:表 8 的未调整置换
控制实验帮助排除了一些简单解释。打乱配对或使用同形状高斯随机矩阵后,局部对齐接近零,说明信号不只是样本数和维度的产物。随机投影到 32/64 维后,保留约 51%/71% 的邻域对齐;移除前五个主成分反而将其提升到约 128%,同时降低全局相似度。线性回归掉星等、颜色和红移后,还保留约 97% 的局部对齐。这排除了所测试线性干扰模型作为完整解释,不能据此排除所有非线性亮度、形态或选择效应。
HSC—DESI 的额外实验先标准化,再各自 PCA 到 64 维,拟合正则化 CCA 公共空间,平均测试 MRR 达到 0.038。所有变换都只在拟合行学习,是合理的检索实验;但它没有物理标签,不能拿它证明适配后红移或质量预测有效。
证据强度、计算与复现风险
对“几何准则不能可靠替代本文的物理选层验证”,可信度为高:验证角色分离、统一测试对象、按家族汇总及多重比较处理都针对实际混淆因素。对“所有天文跨域表示都不能共享物理信息”,则没有这样的证据,也不是作者限定后的正式结论。
小 JWST 产品过滤后只有 929 个对象;光谱侧只检验固定表示;预训练数据、架构、参数规模和训练目标彼此相关。层间几何关系因此主要是关联证据,不是证明某种训练范式造成了共享或不共享。图中的标准误、对象 bootstrap 和家族 bootstrap 分别表示不同的不确定性,不能互换为模型泛化误差。
作者报告整套实验约 1,500 GPU 小时,大部分花在逐层表示提取;缓存以后,下游探针分析平均仍约需 5 GPU 小时。其环境包括八张 A100、128 CPU 核和 1 TB 内存。这里的“冻结模型”并不等于低成本,全量保存大型视觉语言模型中间表示可能比拟合线性头昂贵得多。
正文声称匿名仓库可复现图表并可选重建上游数据,但本次未能访问,因此实现路径、缓存产品及划分文件未核验。阅读优先级建议为精读第 4 节、图 3、附录 A.5–A.6 与 C;表 6–9 适合随后检查统计解释,全部模型逐层热图可选读。
审稿人视角:最大问题与研究启发
最大的一个问题
最大的解释限制是,未适配线性探针失败,尚不能区分“物理信息缺失”与“相同信息使用了不同特征坐标”。
证据锚点是附录 A.6:源域标准化和 ridge 系数直接用于目标表示;附录 C 也明确限定这一条件。用一个简单的数学例子即可看出边界:对表示做正交旋转,可以保持对象间距离和邻域关系,却改变固定回归系数对应的预测方向。这是本文分析用来解释实验的例子,不是论文额外运行的实验。真实跨巡天情况还可能叠加波段信息缺失、均值尺度变化和噪声差异。
因此,这个实验足以否定“几何相似就能直接复用同一线性预测器”,却不足以说明共享物理信息本身不存在。它比单个显著性阈值更重要,因为会直接改变对论文标题及基础模型价值的解读。作者已经在第 4 节和附录 C 承认适配器、非线性解码与联合训练不在当前结论内;这不是推翻论文,而是限制它能够回答的问题。
最小而关键的追加对照是在原有空间划分中,用训练配对对象拟合一个低容量线性或正交适配器,再保持源域物理回归器不变,测试是否恢复预测能力;旁边保留未经适配及目标域重拟合的上下界。不能用测试对象拟合适配器。若很少配对校准就恢复大部分性能,失败主要来自坐标不兼容;若仍不能恢复,还需进一步检查目标可辨识性,不能立即归因于信息彻底消失。现有 CCA 检索结果因缺少物理目标,尚不能替代这一对照。
研究启发与可执行验证
最值得复用的设计是把“几何选择”“科学选择”和“最后评估”分配给不同数据角色,再用能区分解释的控制实验检验迁移。
迁移分析建议分两步:先在少数冻结模型上同时报告邻域对齐、检索和目标预测,不用某一个高相似度分数作为继续投入的唯一依据;再比较原样迁移、低容量适配、目标域重拟合,固定天体级或带缓冲的空间划分。这个设计只需少量代表模型即可起步,不必重建 36 个模型的全层缓存。前提是存在可靠配对和足够标签;适配器的成功也只适用于其训练支持范围,不能自动推广到未覆盖的波段、天区和亮度区间。
四、跨论文结论与行动建议
两篇论文都提醒我们,压缩或变换后的数据是否保留了科学信息,需要用目标任务验证。光谱论文通过物理前向模型尝试保留连续谱信息,表示论文则表明相似的几何结构不保证相同的预测坐标。它们不能互相代替:高精度重建不证明参数误差条可信,高表示相似度也不证明物理回归可迁移。
建议按以下顺序行动:
- 优先精读 DESI 光谱论文的预处理与拟合设计,把连续谱、消光、标定误差和初值放在同一实验中看。最小复现从少量高质量对象开始,不把前代 LRPayne 示例当成本篇完整实现。
- 将表示迁移论文作为评估方法储备,优先借鉴独立选层验证、家族级统计及带缓冲空间划分。相比批量更换编码器,先比较无适配与低容量适配更能回答失败原因。
- 为任何概率输出增加覆盖率验证。重复优化产生的离散程度、经验校准后的偏差及模型间分歧各有用途,都不能未经检验就改名为可靠后验。
暂时不应据此断言:所有光谱都应取消归一化;320 万行新星表已经完整可下载;所有元素在真实低信噪比对象上都可靠;几何对齐没有科学价值;或者基础模型不可能实现跨巡天迁移。第一篇最大的问题影响误差条及星表使用优先级,第二篇最大的限制影响结论措辞和适配实验设计。保留这些条件之后,两篇论文仍提供了明确、可执行的研究启发。
本报告由 ChatGPT Dots 整理分析,博客作者对分析内容不负责且不代表博客作者本人的想法。