一、本期总体分析
arXiv 论文时间范围:[2026-10-05 05:00:18, 2026-10-06 05:00:18)(Asia/Singapore) 各分类篇数:astro-ph 90;cs.CV 191;cs.LG 456;cs.AI 402;stat.ML 63(含跨类,分类间可能重复) 入选篇数:2
两篇论文都关心不同观测之间的信息关系,但判断“成功”的对象不同。第一篇把同一天体在不同巡天中的表示连接起来,用保形预测寻找可提前识别的高误差对象;第二篇把低分辨率尘埃偏振与高分辨率示踪图结合,学习恢复更细的空间结构。前者适合跨巡天表征与不确定性研究,后者适合多模态天文图像、逆问题和前景模拟。
共同的阅读重点是代理指标与科学目标之间还隔着什么。表示翻译误差小,不自动意味着红移或物理参数更准确;重建图像更有丝状结构,也不自动意味着这些小尺度都是真实天空信号。两篇都提供了有用的诊断设计,也都需要避免把一种内部一致性升级为更强的物理结论。
建议先读基础模型可靠性论文,重点看方法、困难度负对照及匹配分析,约需35—45分钟;再读尘埃超分辨率论文的数据构造、逐像素示踪量注意力和噪声讨论,约需45—60分钟。第一篇优先作为评价协议参考;第二篇作为有明确物理输入关系的融合方法储备。
二、入选论文概览
| 优先级 | 英文标题 | 类型 | 核心贡献 | 数据或基准 | 代码状态 | 适用研究场景 | 一句话判断 | 原文 |
|---|---|---|---|---|---|---|---|---|
| 1 | Do Astronomical Foundation Models Know When They Will Fail? | 天文交叉 | 用全局及局部自适应保形区域审计跨巡天表示,区分可预警与静默失败 | Legacy→HSC、HSC→JWST、SDSS光谱→HSC图像 | 正文承诺后续释放完整代码;数据入口本次未能访问核实 | 跨巡天表示、模态迁移、失败检测 | 诊断框架有价值,表示距离的跨模型比较须谨慎 | 2610.02613v1 |
| 2 | Super-resolving Polarized Dust Emission with Transformer-Based Multi-Tracer Fusion | 天文交叉 | 五幅示踪图与分辨率条件联合恢复353 GHz偏振细节 | Planck GNILC、尘埃光学深度、H I4PI派生模板 | 模型与输出图承诺发表时公开,尚不能据此称已可复现 | 天文图像融合、带噪逆问题、CMB前景 | 应精读融合机制,但形态逼真尚不足以验证真实小尺度 | 2610.02575v1 |
三、逐篇深度分析
3.1 基础模型是否知道自己将在哪些对象上失败
英文标题:Do Astronomical Foundation Models Know When They Will Fail?
作者:Vaidehi Bulusu、Mehul Goyal、Md Rabius Sany Apu、Michael J. Smith、Shashwat Sourav
版本与分类:arXiv:2610.02613v1;astro-ph.IM
提交与更新:首次提交及当前版本时间为2026-10-02 00:14:02 UTC,无后续版本记录
论文入口:摘要、HTML正文、PDF
研究资源:论文给出Hugging Face数据入口,本次访问未能核实其内容;附录B说明完整代码和模型配置将在去匿名后释放。摘要页注明获NeurIPS 2026 Interpretability for Discovery workshop接收,不能将此写成主会录用或期刊发表。
科学问题与研究关联
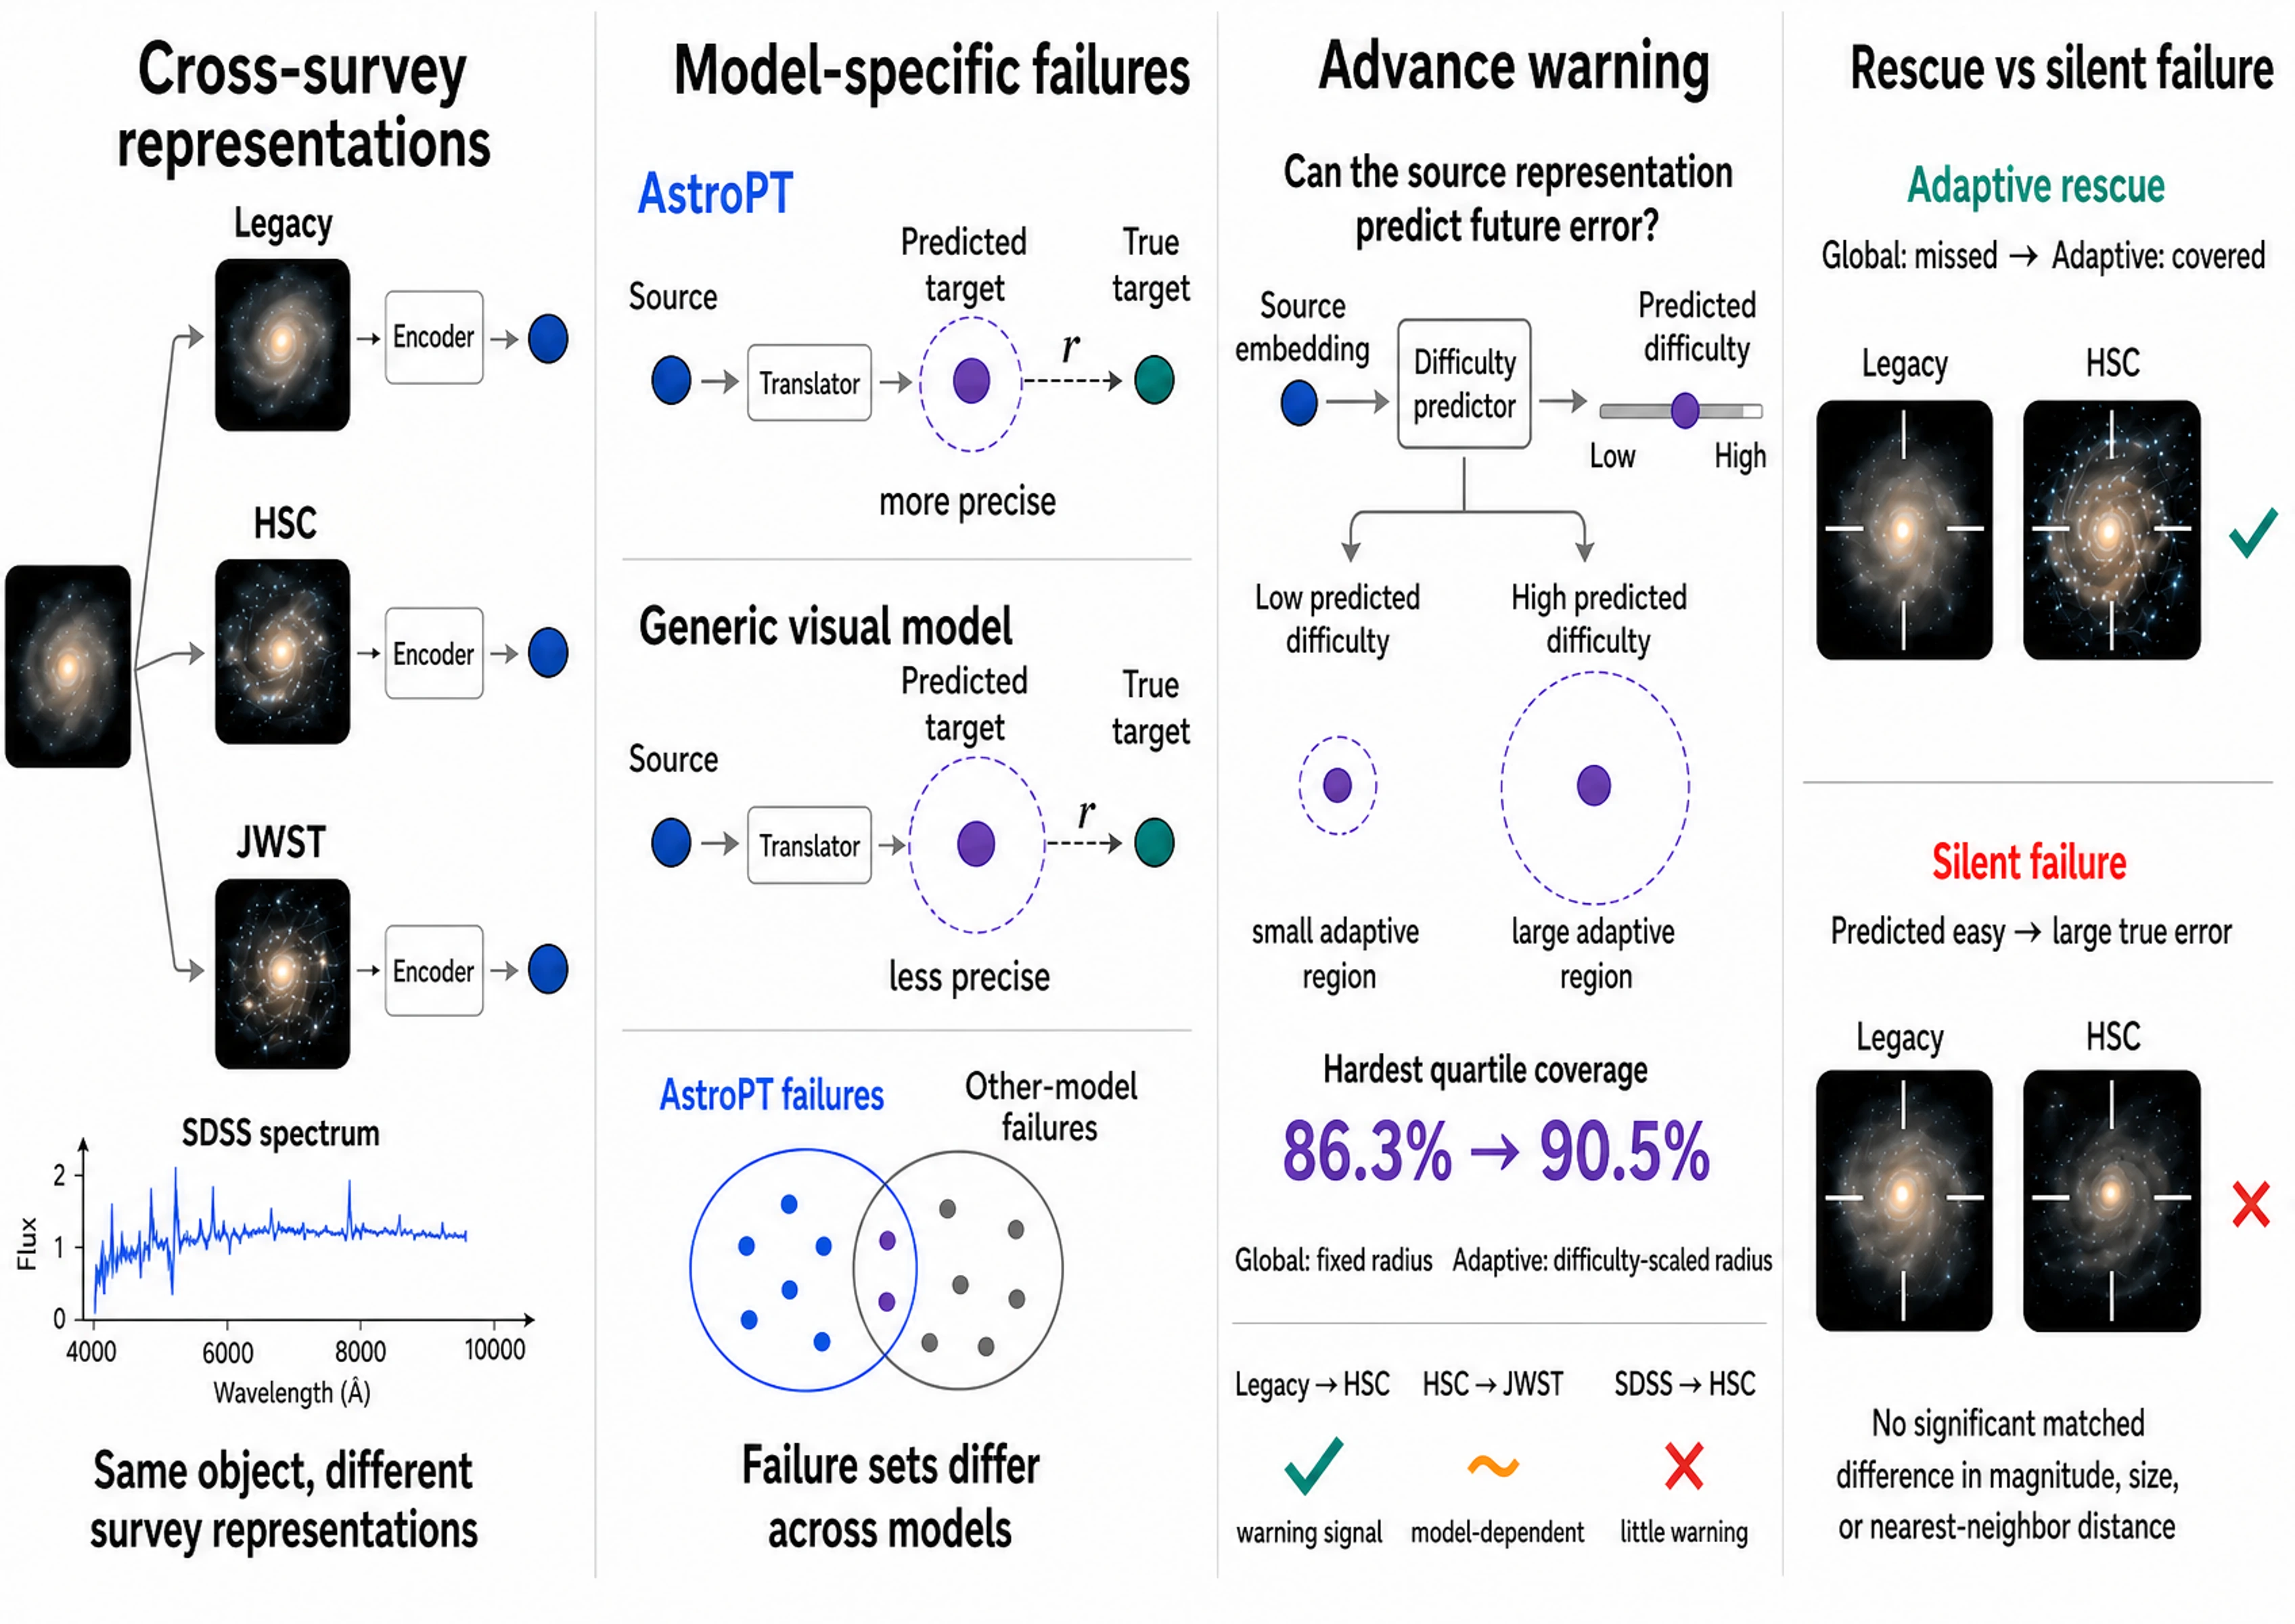
同一个星系在不同巡天里可以呈现完全不同的外观:角分辨率、观测深度、波段、背景和邻源混叠均会改变像素。基础模型把这些像素变成向量以后,是否保留了能跨观测预测的信息?如果不能,源端向量本身能否提前提示风险?
这与一般的下游精度比较不同。论文不训练一个红移或恒星质量预测器,而是把“目标巡天的表示能否由源巡天表示预测”本身设为任务。其价值是把失败定位到具体对象、表示家族和模态方向,供后续科学检查使用。值得精读的是失败审计协议,不能直接带走一个关于物理参数精度的结论。
数据与输入究竟是什么
论文使用三个交叉匹配集合。Legacy→HSC和HSC→JWST是图像到图像;SDSS→HSC则从固定的SDSS光谱编码器表示预测HSC图像表示。最后一个方向同时改变了巡天与观测模态,不能与前两个方向混作完全相同的迁移问题。
图像表示来自AstroPT、DINOv2、ConvNeXt、I-JEPA及ViT的多个规模。附录表1明确,前两个方向的源、目标使用相同型号的编码器,SDSS方向固定源为specformer_base_sdss,只改变目标图像编码器。该表标出的训练规模分别为HSC→JWST约1.5K、Legacy→HSC约100K、SDSS→HSC约2K。这些是训练规模,不是三套数据的总天体数。
正文说明使用固定训练、校准、测试划分,并在翻译前对每个表示做L2归一化。但在正文与附录B中,未找到足以独立重建数据的巡天发布版本、统一波段清单、匹配半径、质量cuts、完整样本分布、天空覆盖、重复天体隔离规则和全部划分规模。像素层的消光、背景、PSF、cutout和各编码器输入变换也没有形成完整配方。不能用所引用巡天的常见设置补写这些信息。
因此,这是一项使用真实多巡天观测的表征审计,但可复现性目前仍受数据说明和未释放配置限制。缺少信息不是已经发生数据泄漏的证据;它意味着读者暂时不能独立确认空间相关性、匹配选择和预训练暴露如何影响结果。
方法数据流与保形区域
先冻结编码器,得到同一对象的源表示与目标表示;随后只训练一个相对简单的翻译器。作者比较ridge、k近邻回归和RBF核SVR,不使用大容量神经翻译网络。作者明确的动机是:尽量测量原表示中已经存在的可预测关系,减少由强大翻译器额外学习造成的混淆。
按方法节,残差为:
其中
这个保证有严格范围:在校准对象和新对象满足交换性时,它约束总体平均覆盖,不保证每类星系或每个观测条件都得到同样覆盖,也不会自动延伸到校准集之外的新巡天。
第二步另拟合一个ridge困难度模型,仅根据源端表示预测翻译误差的大小。作者说明其训练数据与翻译器训练集分离。困难度进入归一化分数:
这里的
最后,把对象按结果分组:全局区域漏掉、自适应区域覆盖的是“挽救”;预测困难度低但实际残差大的是“静默失败”;预测困难但实际简单的是误报;原本全局覆盖、自适应后漏掉的对象也要记录。自适应不是单向扩张所有区间,而是重新分配区域大小。
结果应怎样解读
正文§3.1在ridge下报告AstroPT-850M三个方向的平均残差为0.179、0.107和0.168。附录表1相应为0.171、0.111和0.159,表注说明使用了不同随机种子,因此不能悄悄把两组数拼成一组。另有一个未解决的记号问题:方法节写维数归一化残差,附录表题写mean L2 distance,未在表注明确重述归一化。此处保留作者报告值,不跨表重算相对优势。
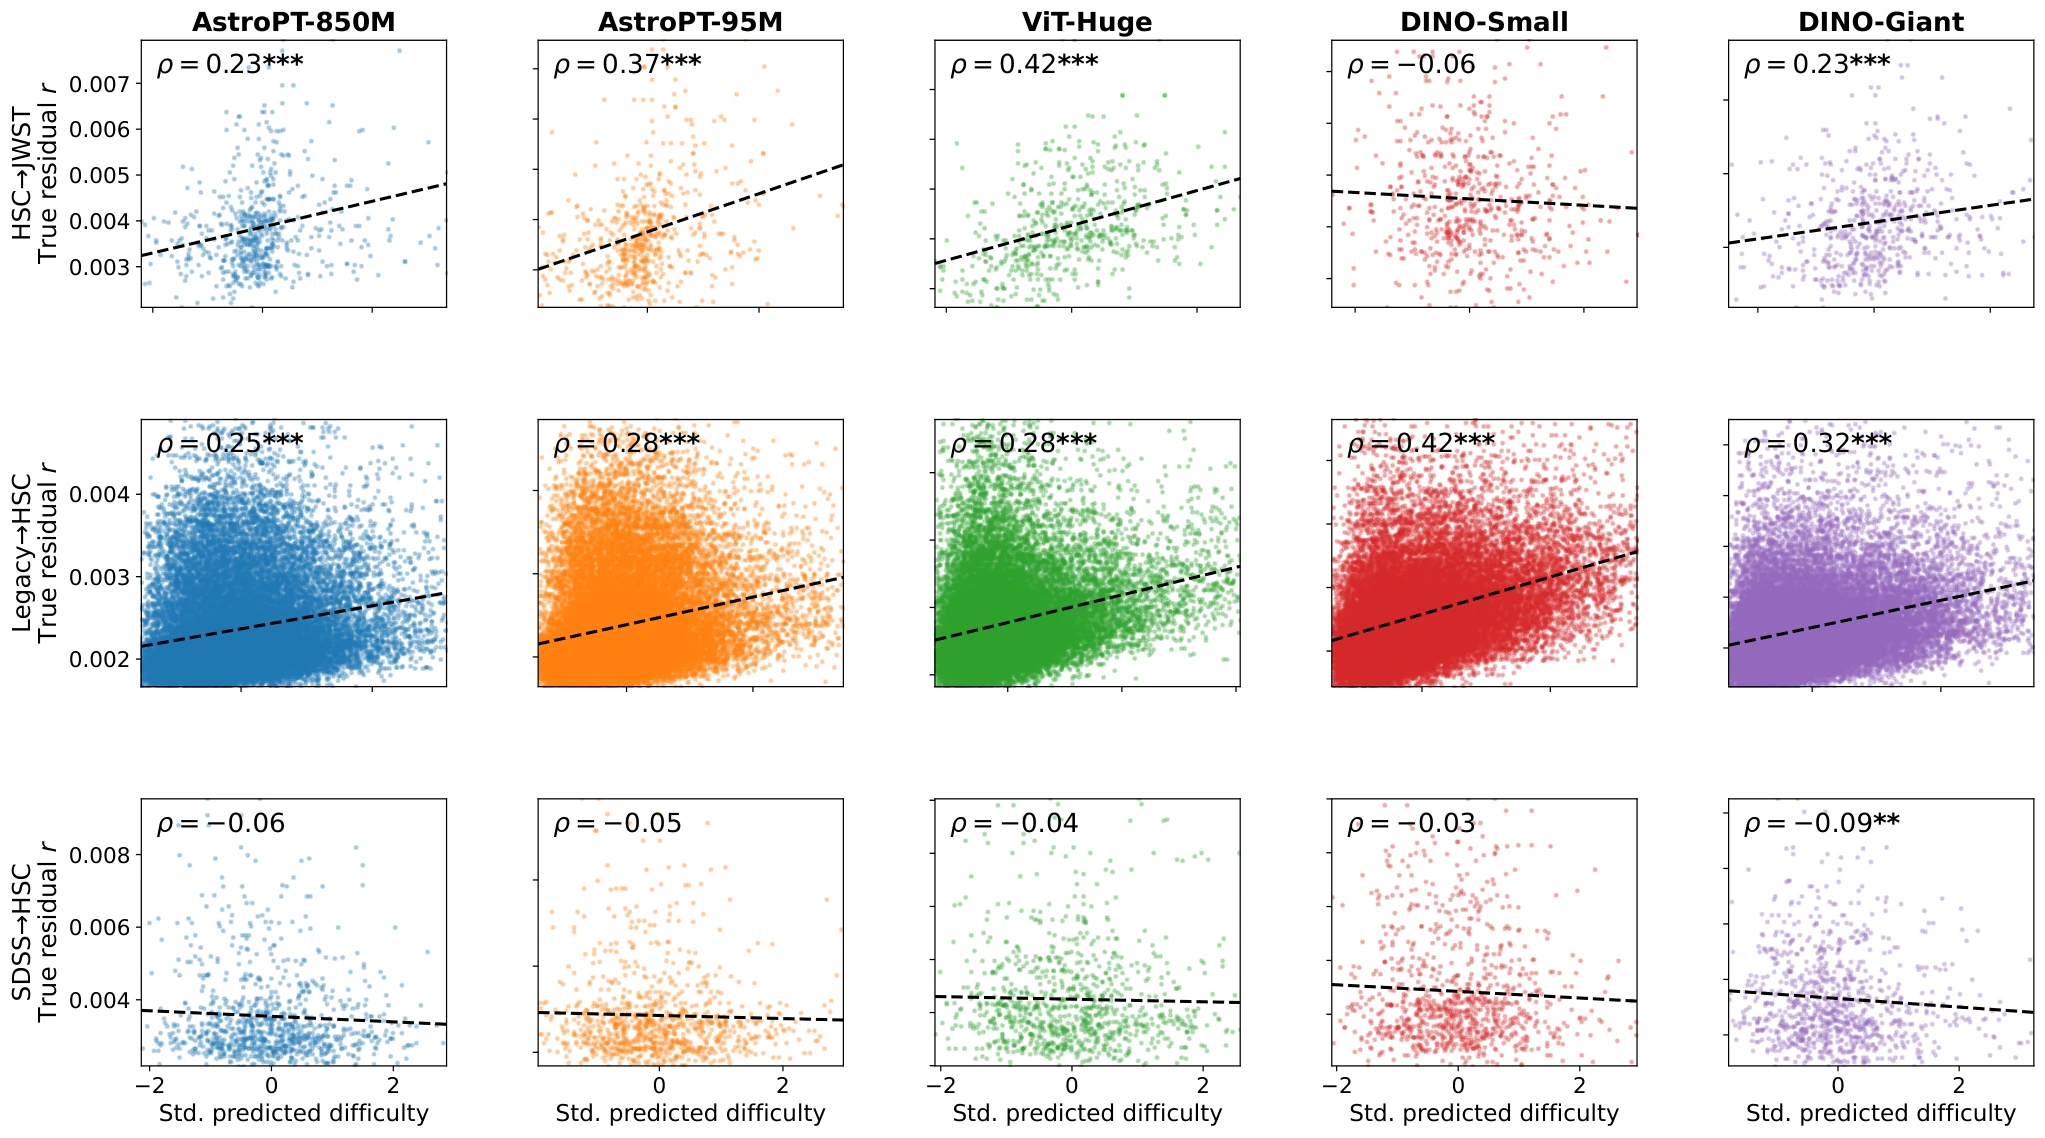
更稳妥的阅读重点是同一表示内部的困难度信号。正文§3.2报告Legacy→HSC各backbone的Spearman相关约0.25—0.42;HSC→JWST依赖型号,ViT-Huge约0.42、AstroPT-95M约0.37,DINO-Small约−0.06;SDSS光谱→HSC方向普遍接近零。这项负结果很重要:拟合一个误差预测器,不会自动获得有用的风险预警。
在90%目标覆盖下,Legacy→HSC最高预测困难度四分位的覆盖率,AstroPT-850M从86.3%升至90.5%,AstroPT-95M从84.3%升至90.4%。这支持在该分组中缓解欠覆盖,不等于给所有天文子群建立了条件覆盖保证。附录图10同时展示区域大小;应连同它判断改善是否主要靠扩大区间,不能只看覆盖率。
失败集合也不相同。HSC→JWST中,AstroPT家族内部未覆盖集合的Jaccard约0.61—0.68,与其他家族重叠更低。相同90%总体覆盖只决定失败比例相近,不决定漏掉同一批对象。多模型分歧可用于安排人工检查,但论文没有据此完成一个经过验证的集成算法。
作者进一步用匹配对照检查i波段星等、表观尺度和近邻距离。附录E对12项比较做Holm校正,并用2,000次配对bootstrap给出区间。静默失败与稳定对象在这三个量上的差异均未显著;挽救对象和误报对象的一部分区别则体现在近邻距离。这里应写“这些检验没有发现差异”,不能写“证明亮度、大小和环境完全无关”。残差参与类别定义,对残差再做组间比较不能独立解释机制。
附录F把部分HSC图像卷积到近似1.2角秒PSF,再与Legacy图像比较。它是代表对象的视觉检查,支持PSF差异不能解释所有示例;不是对全样本完成统一PSF后的重新训练或定量消融。
证据强度与复用边界
总体可信度为中等。多个翻译器、多个巡天方向、困难度负对照和匹配分析使研究不止停留于单一可视化;但完整实现、样本定义和跨模型距离口径仍待补足。没有报告统一的调参空间、训练成本、编码吞吐及显存,不能据此给出工程复现预算。
直接可复用的是三段式协议:表示翻译、独立困难度学习、独立残差校准。它比只给一个平均误差更能暴露局部失败;但源表示无法预测目标模态中特有的信息时,再复杂的困难度头也未必有效。将该方法迁移到红移或物理参数任务时,应把同一套失败分组与真实下游误差相连,而非以向量球覆盖代替物理量覆盖。
阅读路线:精读§2、§3.2与附录D—F;表1—3用于核对残差分布,不宜孤立拿来给backbone排科学能力名次。附录B用于确认复现条件,而不是将“将开源”当成已交付。
审稿人视角:最大问题与研究启发
最大的一个问题
跨backbone的“翻译更准”仍缺少足够统一的表示几何基准,因而不能直接等价为更可靠的天文信息保留。依据是§2的L2归一化及除以
这不是证明AstroPT结果无效,而是限制了最强比较主张。本文推断:将同样的单位范数几何嵌入更高维、再除以
最小关键修正是:在每个目标空间加入训练均值或随机配对等参照,报告相对这些参照的可预测增益;同时统一明确原始距离、归一化距离与维数,并在同一个独立天文下游目标上检验排名是否保持。论文已有随机配对显著性检验,但“显著优于随机配对”还不等于不同空间的绝对误差可直接比较。作者讨论了交换性和物理归因限制,尚未充分解决这一几何可比性问题。
研究启发与可执行验证
最值得借鉴的是把“能否预测失败”作为单独可被否定的假设。迁移分析建议:固定一个天文任务与对象集合,保留互不混用的拟合、困难度、校准、测试角色;同时画困难度相关、最难四分位覆盖与区域大小。若困难度没有信息,就保留全局校准而不强推自适应。代价是要为多个阶段保留足够独立对象,交叉匹配较小的巡天对尤其需要报告样本不确定性。
3.2 用多种观测示踪量恢复尘埃偏振的小尺度结构
英文标题:Super-resolving Polarized Dust Emission with Transformer-Based Multi-Tracer Fusion
作者:Minjie Lei、George Halal、S. E. Clark、Alejandro Dobles、Katie Brown、Viraj Manwadkar
版本与分类:arXiv:2610.02575v1;astro-ph.GA
提交与更新:首次提交及当前版本时间为2026-10-01 23:10:58 UTC,无后续版本记录
论文入口:摘要、HTML、PDF
代码与产品:结论后说明模型及高分辨率353 GHz偏振图将在发表时公开;当前正文没有可核验的已释放实现入口,不能声称已能复现实验。
为什么这是一个天文逆问题
银河尘埃偏振是宇宙微波背景B模研究的重要前景。小尺度前景结构会影响成分分离、透镜重建与去透镜,因此模拟天空不只需要正确的平均功率,也需要合理的空间形态及不确定性。
现有方案可以向粗图注入符合指定统计量的细节,但“统计相似的一幅图”未必对应真实天空位置上的丝状结构。本文利用高分辨率尘埃光学深度和中性氢丝状模板,辅助恢复粗偏振图中的细节。这给多模态融合一个明确的物理理由:不同示踪量观测同一星际介质的不同方面。
值得精读的是同位置、跨示踪量的信息交互;其输出应当视为受观测条件约束的预测图,而不是新增的20角分偏振观测。
数据来源与样本构造
目标来自Planck R3.00 GNILC的353 GHz Stokes
辅助输入之一是R1.20 Planck 353 GHz尘埃光学深度
§II.2把GNILC中15、20、25、30角分区域分别平滑到60、80、100、120角分,形成四倍波束分辨率恢复任务。高分辨率目标仍是原生GNILC,没有模拟真值。更高分辨率区域因面积不足未用于构造训练patch;更粗区域则因四倍平滑后过粗被排除。训练区域约覆盖40%天空,不能理解为高纬全部天空均有15角分真值。
每个目标尺度
归一化不是逐patch拉伸:作者在所选天空区域上,以绝对值分布的99.9995百分位确定截断和缩放,
模型从五幅图到两幅图的完整路径
五个输入分别经过卷积编码器,保持80×80空间网格,每个位置输出32维特征。目标角分辨率经embedding成为另一个32维向量。在同一位置,把五个示踪向量和一个尺度向量组成长度为6的序列,做一层、单头的Transformer自注意力。
这里最容易误读:注意力主要在同一像素的不同示踪量之间进行,不是把整幅80×80图的所有像素当成一个全局序列。 空间邻域由3×3卷积及残差块处理。融合后保留对应低分辨率GNILC
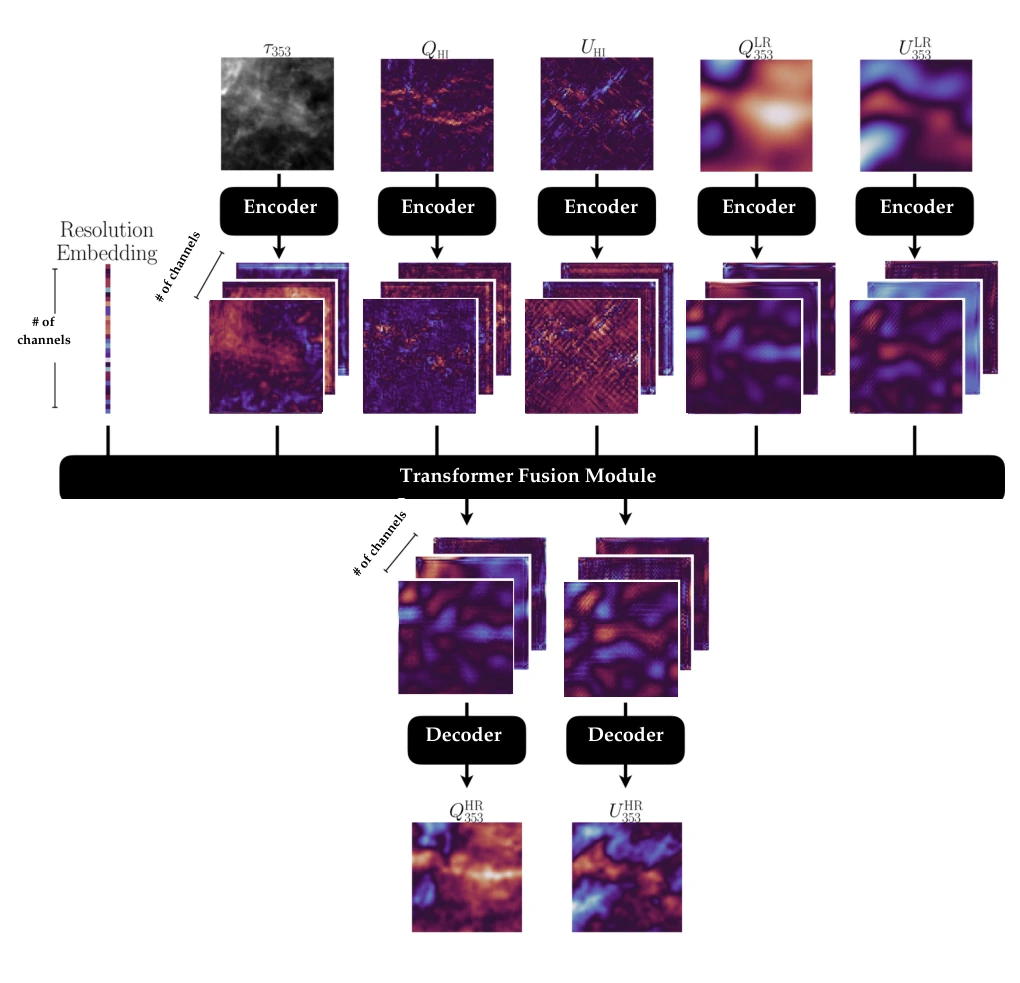
附录A与表1给出的配方是编码器4个残差块、解码器5个残差块、GELU、pre-layer normalization、通道宽32、Transformer一层一头;AdamW学习率
这一设计最有复用价值的是“保持各通道物理缩放的卷积编码+局部跨模态注意力”。它适合已经对齐、每路具有明确物理对应关系的地图,不适合不经处理直接融合PSF、网格或坐标约定不一致的图。尺度embedding也只是条件输入,不能因其注意力权重小就直接证明所有尺度都可外推。
实验究竟支持到哪一步
验证集平均归一化L1约0.003。图3图注写小于0.003,正文写0.003,因此这里只采用约数,不补造更高精度或相对改进。该指标支持人工平滑后恢复原生GNILC的能力,不等于对未观测细尺度的真实误差已知。
推断时,统一80角分GNILC被恢复为20角分,覆盖
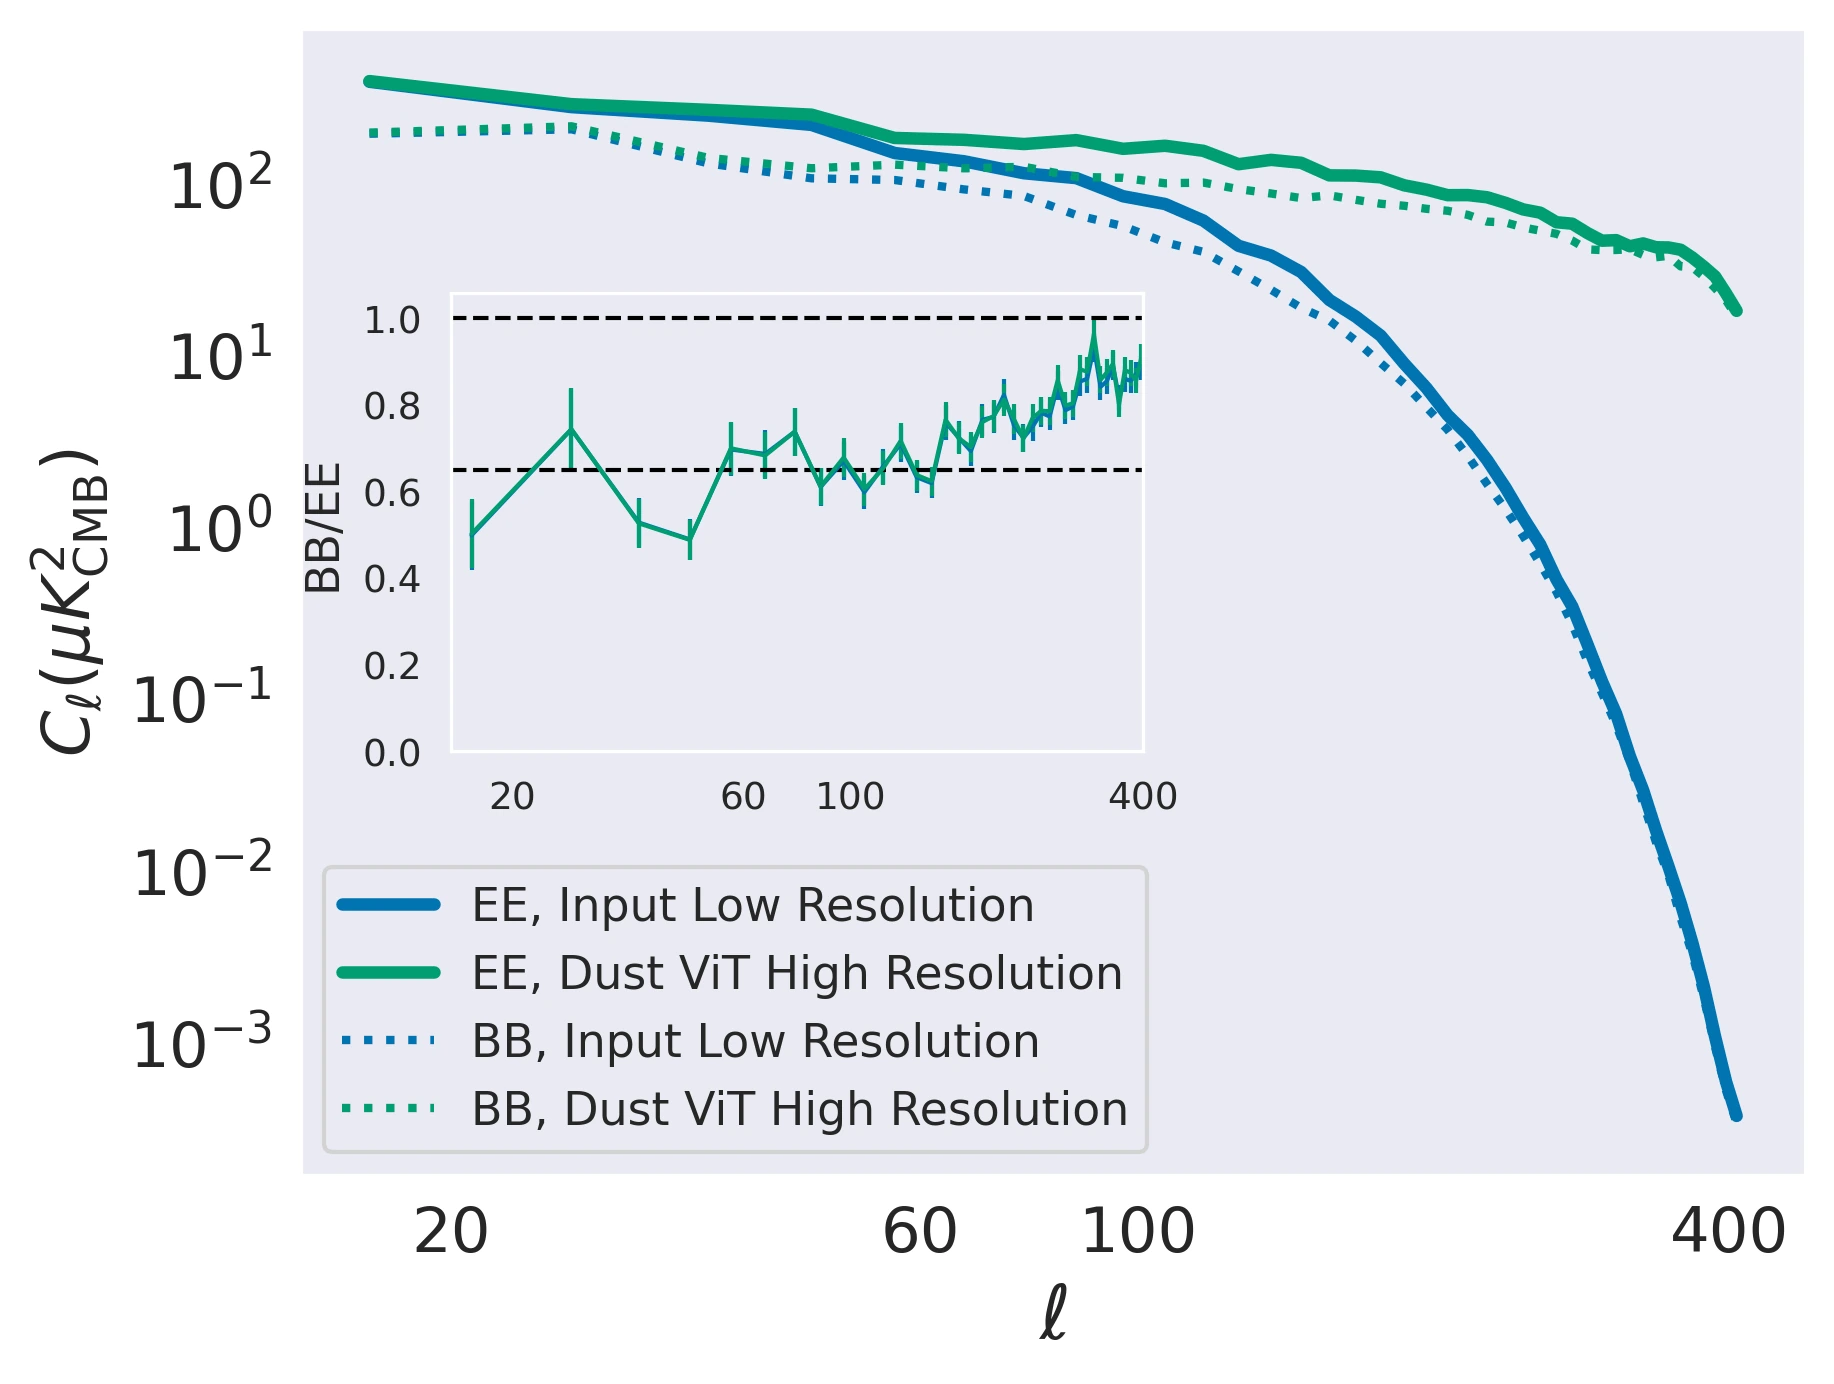
功率谱检验使用NaMaster的纯E/B估计器。论文报告恢复后的EE、BB功率延伸到约
形态评价的参照是高斯随机图、幅度调制高斯图与平滑到相同20角分的PySM d10。标量Minkowski泛函测面积、边界长度及连通性;张量版本补充方向性和结构伸长;散射变换用多尺度定向小波刻画跨尺度丝状联系。它们不是三个独立真值源,而是从不同角度描述图像结构。
在96个部分重叠的高纬20°×20°patch上,相对于高斯参照的聚合偏离量,张量泛函为dust ViT 3.24±1.46、PySM d10 1.85±1.07;散射统计量分别为5.03±1.47、4.43±0.97。这里的±是patch之间的标准差,不是模型差异的独立样本显著性。局部强丝状区域差别较清楚,但覆盖整片高纬天区的标量泛函变得相近,正文并没有证明所有天区都显著优于PySM。
同时,PySM d10以低多极信号区功率律外推小尺度,而dust ViT尝试恢复带噪GNILC。两者并不是在完全相同的噪声条件下竞争。更强非高斯性或更多丝状结构,既可以体现示踪信息,也不能排除系统误差影响,需要额外信号检验。
解释性、局限与阅读路线
图4—5的注意力展示H I模板、尘埃光学深度和粗
证据可信度为中等:同源平滑恢复和预测图形态有实验证据;真实未观测小尺度、无噪声信号及最终CMB科学收益的证据较弱。作者§VII.2主动承认模型确定性输出、继承GNILC噪声、只处理353 GHz及缺少频率去相关等限制。现有输出不能提供前景不确定性集合,也没有完成对原初B模或去透镜偏差的端到端验证。
建议精读§II与附录A以重建数据流,再读图7和§VI.3、VII.2判断信号与噪声边界;图5用于形成消融假设,而不是作为贡献证明。方法储备价值高于把当前输出直接当高精度天空真值的价值。
审稿人视角:最大问题与研究启发
最大的一个问题
真实高纬20角分小尺度的信号真实性,尚未被独立于GNILC目标噪声的证据验证。根因是训练把原生GNILC当目标,再从其平滑版本恢复;同一观测中的噪声和成分分离残差也属于目标。依据包括§II.2的数据构造、§V的BB/EE高多极趋势、§VI.3的不同噪声基线,以及§VII.2作者对噪声继承的承认。
它比图像是否更清晰更重要,因为最终用途是检验CMB前景污染:把残差恢复成连贯细节,并不等价于获得可用于宇宙学推断的尘埃信号。这个限制不会推翻“多示踪量能帮助同源重建”,但明显限制“输出更接近真实小尺度天空”的主张。
最小关键修正是开展独立噪声实现的验证:例如按作者建议使用Planck half-mission或detector-set分割,使输入和监督不共享同一噪声实现,再用交叉谱检查恢复的信号成分。半任务分割并不自动消除共享系统误差,因此还应报告剩余共同残差,而不能把它包装成无条件无噪声真值。该方案目前是作者未来工作,不是已完成的缓解实验。
研究启发与可执行验证
迁移分析中最值得保留的原则是:恢复类任务的监督应尽量隔离“希望恢复的信号”和“不希望复制的噪声”。对于重复观测的天文图像,可先按天区整体留出,并以独立观测构造输入和目标;同一对象或重叠patch不跨集合。再用一个示踪通道移除或错配对照,检查模型是否确实使用了它携带的目标相关信息。代价是独立观测、足够天空覆盖及严格偏振坐标处理,不能仅凭扩充patch数量替代。
四、跨论文结论与行动建议
两篇文章最有价值的共同点,是把观测条件和失败对象纳入评价;它们的证据缺口则分别位于表示几何和信号参考。第一篇优先用于重构跨巡天评价协议,第二篇优先用于理解具备物理对应关系的多输入融合。尚未公开的完整实现使两者都更适合先做小型独立验证,而非承诺直接复现全部结果。
可执行的下一步限定为三项:
- 先验证预警是否有信息:在固定对象与编码器下,对比全局和自适应保形区域,同时报告最难分组覆盖、区域大小和困难度相关;没有预警信号时接受负结果。
- 再连接科学目标:把表示失败类别与一个独立下游标签关联,检查表示空间结论能否转化为真实任务收益。跨backbone先澄清距离单位与空间尺度。
- 融合前先隔离噪声:对多示踪量重建,采用空间留出及独立观测监督,配合通道移除控制和交叉谱;形态统计改善不能代替信号验证。
暂时不应作出的结论包括:基础模型已经可以预警所有跨巡天失败;90%总体覆盖等于所有子群90%覆盖;注意力证明了每个模态的物理贡献;20角分预测已经成为真实偏振观测;或者这些结果已经证明对某个宇宙学参数有增益。最大问题并不消除两篇的阅读价值,但决定了应先借鉴评价与实验设计,再考虑部署或扩展模型。
本报告由 ChatGPT Dots 整理分析,博客作者对分析内容不负责且不代表博客作者本人的想法。